

Python数据分析:Pandas Series对象创建与基本操作详解

本文详细介绍Python数据分析库Pandas中Series对象的核心用法。涵盖从列表、字典及NumPy数组创建Series的方法,解析index与values等常用属性。深入讲解元素获取、修改、删除及切片操作,并演示head、tail、排序、去空等常用函数。最后通过describe统计与四则运算示例,展示Series在数据清洗与分析中的实际应用。
一、Pandas Series对象
Pandas是基于NumPy构建的Python数据分析工具库,提供了大量高效处理数据的函数与方法,并整合了多种数据处理库及数据模型,功能十分强大。
安装Pandas可使用以下命令:
conda install pandas
# 或
pip install pandas
Series数据结构
Pandas中最常用的两种数据结构为Series和DataFrame,本文重点介绍Series及其创建方式。
Series是一维数组结构,由索引(index)和值(values)两部分组成,两者一一对应。它可以存储多种数据类型,包括字符串、布尔值、数字以及Python对象等。
创建Series对象
创建Series对象的基本语法格式如下:
s = pd.Series(data, index)其中,参数data用于指定数据源,可以是字典、列表或NumPy的ndarray数组等;参数index用于指定索引,其值必须唯一,类似于Python字典的键。若未提供index参数,系统默认生成从0开始递增的整数索引。
从列表创建Series示例:
data = ["a", "b", "c", "d", "e"]
s = pd.Series(data)
s
从字典创建Series示例:
当data参数为字典且未显式传入索引时,Series将自动以字典的键作为索引,字典的值作为对应的数据值。
data = {"a": 1, "b": 2, "c": 3}
s = pd.Series(data)
s
上述代码的运行结果如下:
a 1 b 2 c 3 dtype: int64
从NumPy数组创建Series示例:
ndarray是NumPy库中的数组类型,关于NumPy的具体使用方法,可参考Python数据分析中Numpy的相关文章。
data = np.array([1, 2, 3, 4])
s = pd.Series(data)
s
创建Series对象后,即可调用其属性和方法进行数据处理与分析。接下来介绍Series对象的基本操作。
二、Series对象的基本操作
Series常用属性
- index:获取索引信息
- values:获取数组数据
- size:获取元素数量
- dtype:获取对象的数据类型
获取索引及修改索引的示例:
data = ["a", "b", "c", "d"]
s = pd.Series(data)
print(s.index)
s.index = ["A", "B", "C", "D"]
print(s.index)
运行结果如下:
RangeIndex(start=0, stop=4, step=1)
Index(['A', 'B', 'C', 'D'], dtype='object')
指定索引对应元素的获取、修改及删除操作:
Series通过索引获取、修改及删除元素的方式与Python字典操作类似,具体用法如下:
# 获取数据
print(s["A"])
# 修改数据
s['A'] = 99
# 删除数据
s = s.drop("B")
s
此外,Series支持通过筛选条件获取数据,例如获取能被2整除的数据:
data = np.array([1, 2, 3, 4])
s = pd.Series(data)
s[s%2==0]
Series切片操作示例:
Series的切片操作与Python列表切片类似,如下所示:
s[0:3] 上述代码表示获取第0、1、2个数据。
也可以使用索引值进行切片,例如获取索引值B到D的数据:
s["B":"D"]
复制代码
Series常用方法
- head(n):返回前n行数据,默认返回前5行
- tail(n):返回后n行数据,默认返回后5行
- isnull()与nonull():判断数据是否为空,返回True或False
- sort_values():对数据进行排序,通过传递ascending参数指定升序或降序,默认为True(升序)
- dropna():删除空值
Series运算
统计信息获取示例:
可以通过describe()方法获取详细的统计信息,如下所示:
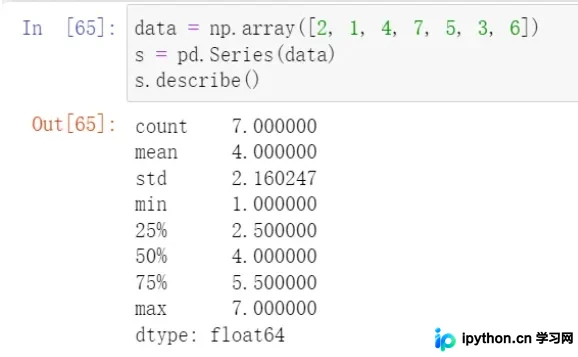
也可以通过以下方法分别获取各项统计指标:
- min():获取最小值
- max():获取最大值
- mean():获取均值
- median():获取中位数
- sum():获取总和
- count():获取总数
- ······
四则运算示例:
s+2  # 对每个元素进行+2
s*100 # 对每个元素乘100也可以调用相应方法进行运算:加法add()、减法sub()、乘法mul()、除法div()。
至此,关于Python数据分析中Pandas Series对象的介绍已完成。如需了解更多相关内容,请搜索本站历史文章或继续阅读后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









