

数据清洗:使用Python unicodedata模块一行代码去除文本特殊符号
本文介绍如何利用Python的unicodedata模块,通过一行代码高效清洗文本中的各类特殊符号。文章解析了Unicode符号的四大分类,提供了针对所有符号及特定类别(如箭头、几何图形)的过滤代码示例,并指导用户通过官方文档查询符号类别,实现精准的数据预处理。
2026-10-16
7

本文介绍如何利用Python的unicodedata模块,通过一行代码高效清洗文本中的各类特殊符号。文章解析了Unicode符号的四大分类,提供了针对所有符号及特定类别(如箭头、几何图形)的过滤代码示例,并指导用户通过官方文档查询符号类别,实现精准的数据预处理。
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
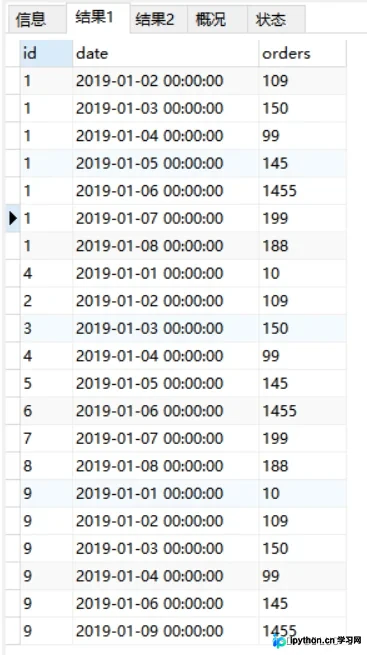
本文详细介绍在Python中按天生成时间范围序列的三种常用方法。首先利用标准库datetime结合timedelta手动计算;其次介绍使用第三方库Arrow简化日期遍历;最后展示Pandas库中date_range和truncate函数在生成不同间隔及截断时间段序列中的高级应用,帮助开发者灵活处理日期数据。
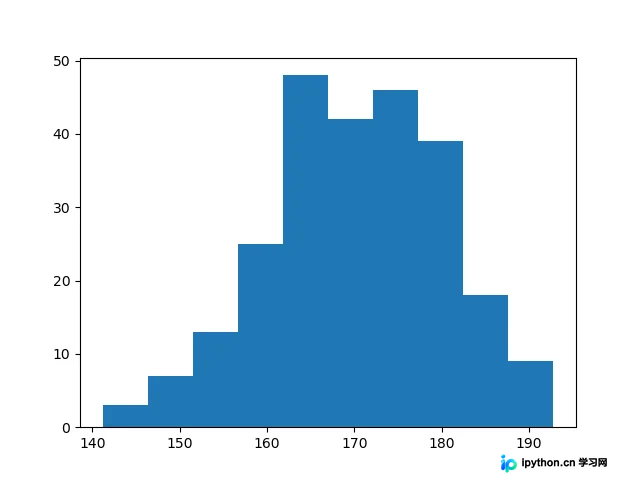
本文详细介绍在Python中生成直方图的两种主要方法。通过NumPy生成正态分布数据,分别使用Matplotlib和Pandas库绘制基础及定制直方图,展示参数设置与可视化效果,帮助读者掌握数据分布的可视化技巧。
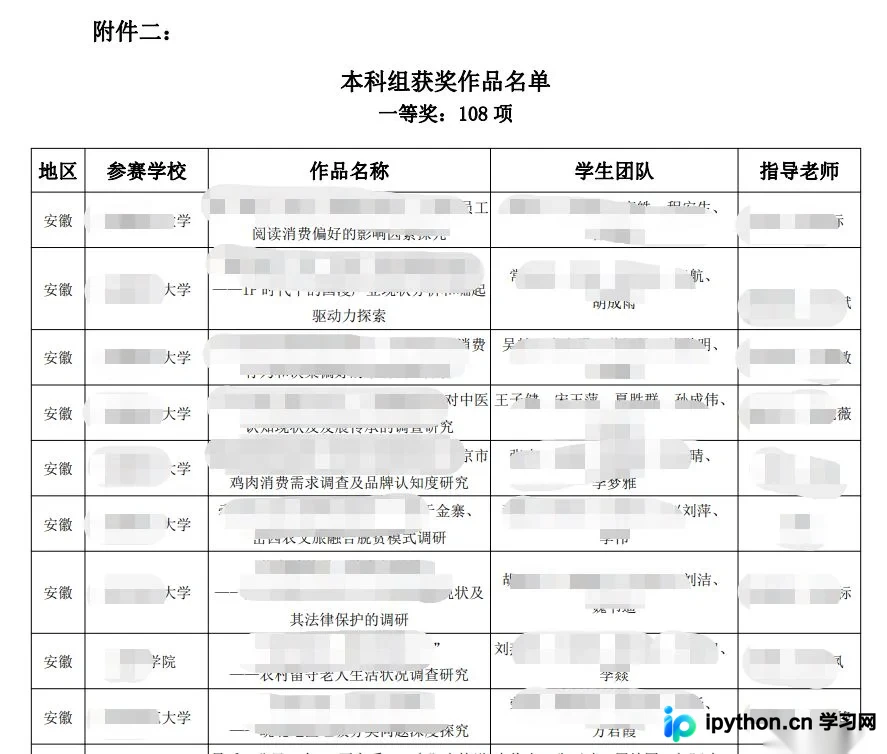
本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
本文介绍pandas处理Excel中超过14位数字自动转换为科学计数法的问题。提供两种解决方案:数据量小时使用to_csv替代to_excel;通用方法是在read_excel时指定dtype=str将所有数据读为字符串。此外,还讨论了将特定字段转为int类型时需先处理空值的注意事项,以避免转换错误。
本文详细介绍 Python 中 Pandas DataFrame 的增删改查操作。涵盖按列/行添加数据、使用 loc/iloc 选取指定行列、修改标题与数值以及删除行/列的常用方法,并解析 inplace 参数对数据修改的影响,帮助开发者高效处理结构化数据。
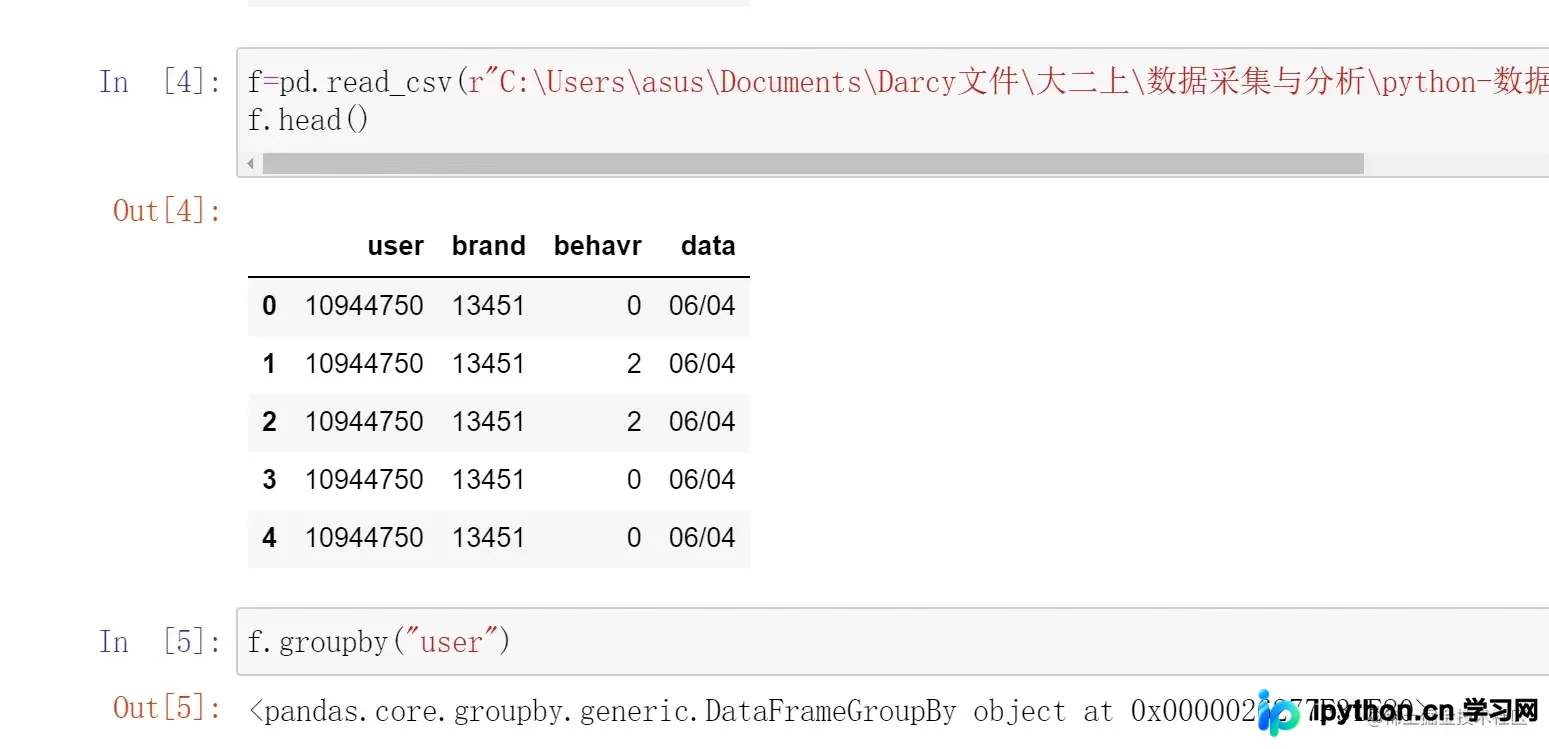
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。
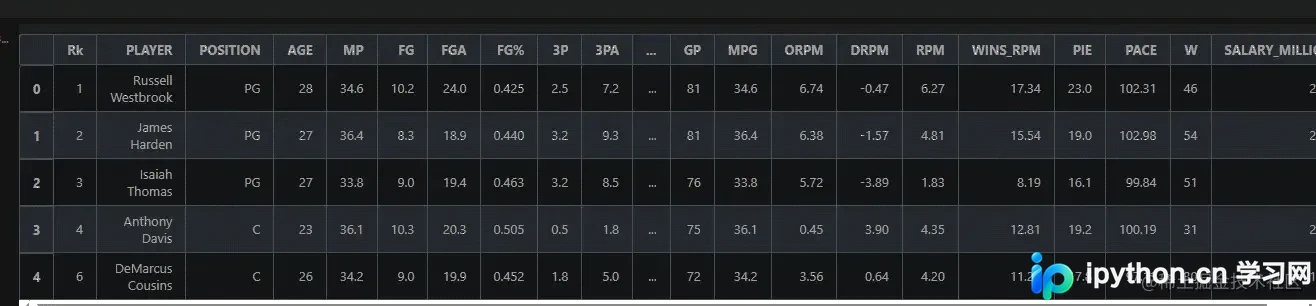
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
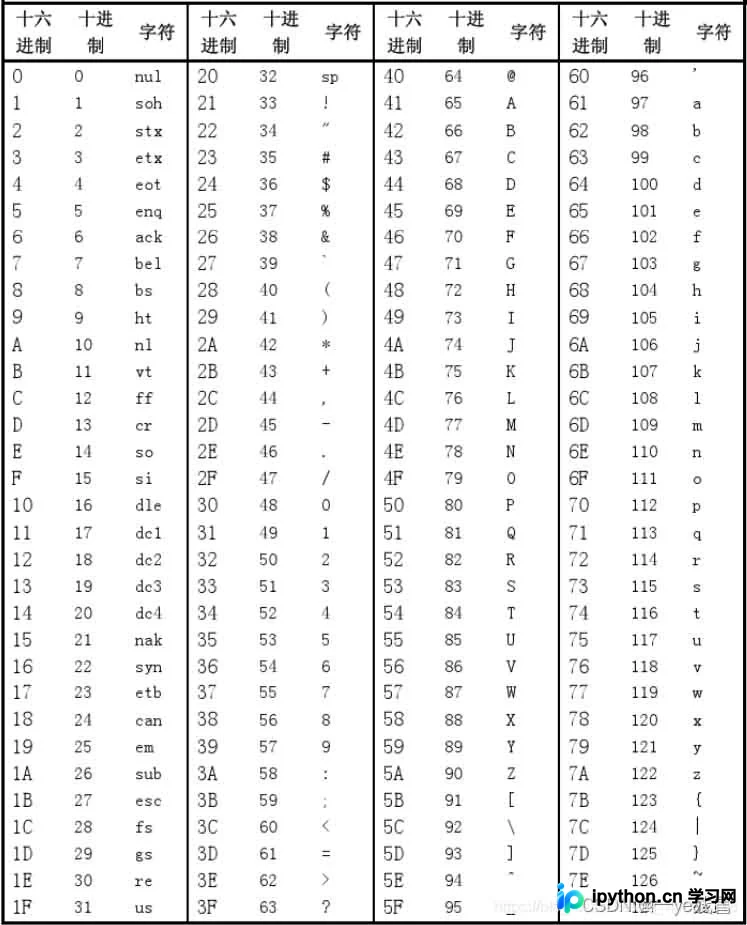
本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
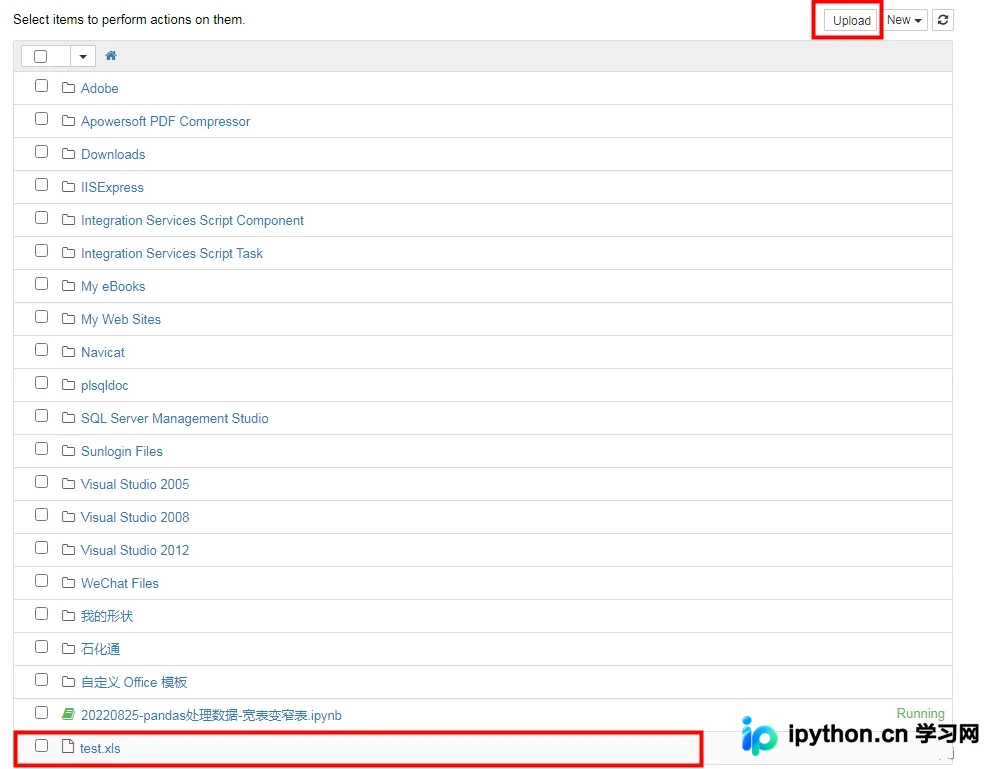
本文介绍如何使用Python的pandas库将宽表转换为窄表。通过pd.melt函数重塑数据结构,并结合dropna处理空值,最终导出为Excel文件。该方法简化了数据分析流程,提升了办公效率。
本文详细介绍Python中Pandas库的两种核心排序方法:sort_index用于按索引或列名排序,sort_values用于按数值大小排序。涵盖单列与多列排序、升降序控制、inplace参数应用及缺失值处理策略,帮助开发者高效完成数据整理任务。