

Python数据合并详解:concat、merge与join函数用法对比

本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
一、concat函数
pandas.concat()函数主要用于沿指定轴将多个对象进行堆叠,其逻辑类似于数据库中的数据表合并操作。该函数的完整签名如下:pandas.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False, keys=None, levels=None, verify_integrity=False, sort=None, copy=True)。
各参数的具体含义如下:
| 参数 | 作用 |
|---|---|
| axis | 表示连接的轴向,可以为0或者1,默认为0 |
| join | 表示连接的方式,inner表示内连接,outer表示外连接,默认使用外连接 |
| ignore_index | 接收布尔值,默认为False。如果设置为True,则表示清除现有索引并重置索引值 |
| keys | 接收序列,表示添加最外层索引 |
| levels | 用于构建MultiIndex的特定级别(唯一值) |
| names | 设置了keys和level参数后,用于创建分层级别的名称 |
| verify_integerity | 检查新的连接轴是否包含重复项。接收布尔值,当设置为True时,如果有重复的轴将会抛出错误,默认为False |
根据axis参数的不同,堆叠操作可分为横向堆叠与纵向堆叠两种模式,其中默认采用纵向堆叠(axis=0)。
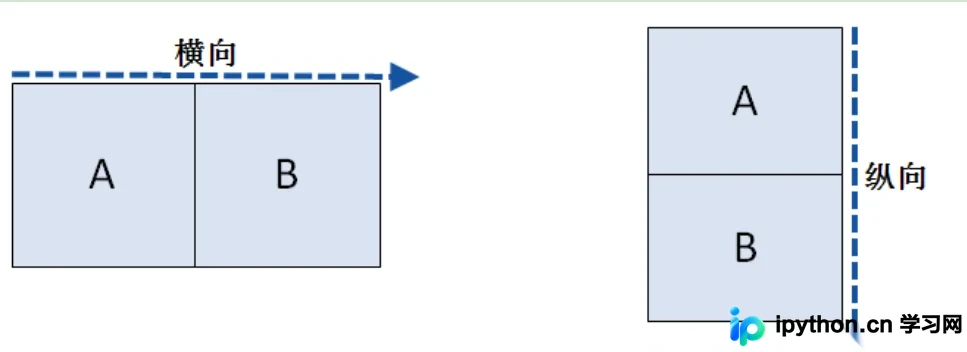
在合并数据时,默认采用外连接(join='outer')方式,即保留所有索引标签;用户也可通过设置join='inner'来启用内连接,仅保留重叠部分的索引。
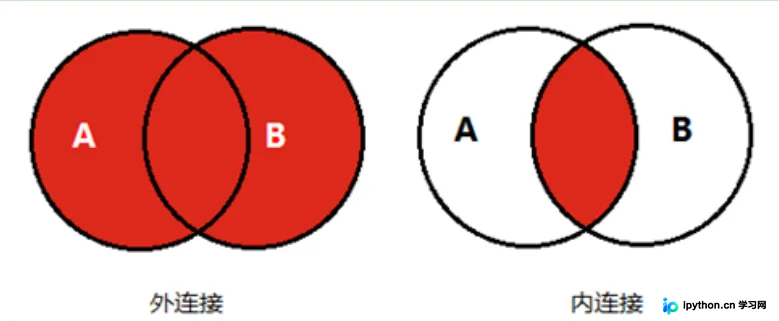
1)横向堆叠与外连接
import pandas as pd
df1=pd.DataFrame({'A':['A0','A1','A2'],
                  'B':['B0','B1','B2']})
df1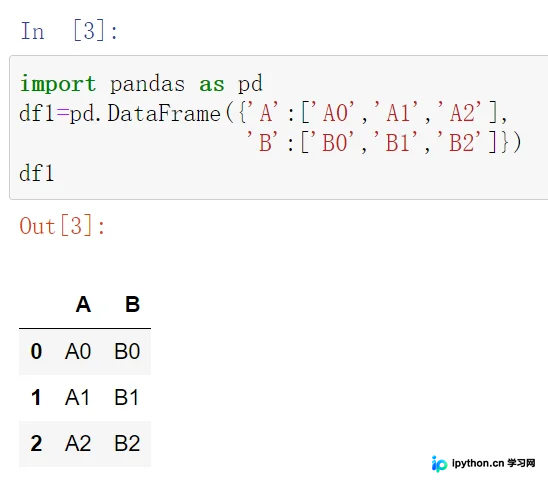
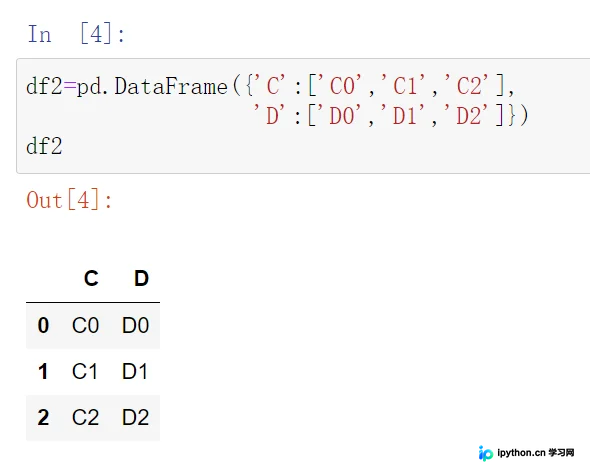
以下示例展示了如何对df1和df2进行横向堆叠合并,并指定使用外连接方式。
pd.concat([df1,df2],join='outer',axis=1)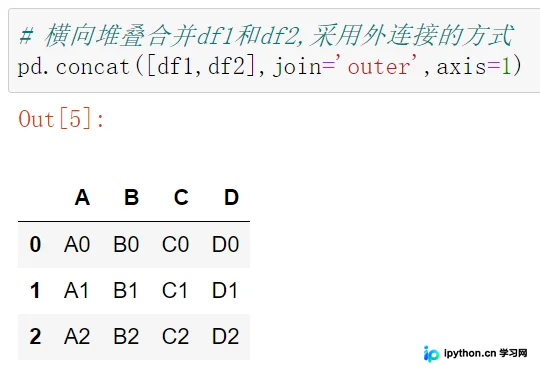
2) 纵向堆叠与内链接
import pandas as pd
first=pd.DataFrame({'A':['A0','A1','A2'],
                   'B':['B0','B1','B2'],
                   'C':['C0','C1','C2']})
first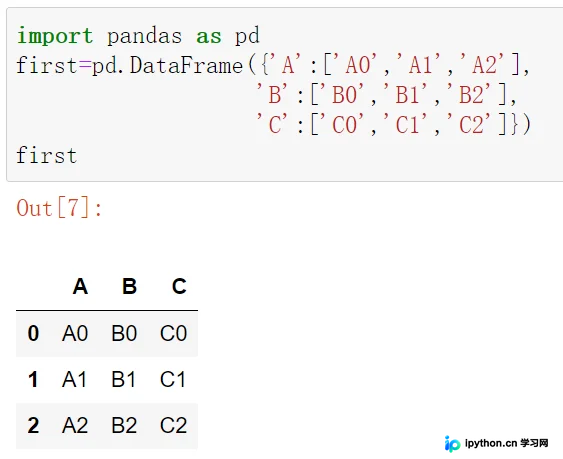
second=pd.DataFrame({'B':['B3','B4','B5'],
                   'C':['C3','C4','C5'],
                    'D':['D3','D4','D5']})
second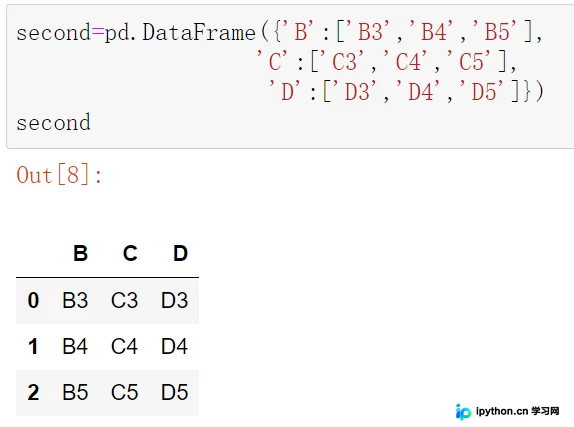
当设置axis=0且join='inner'时,表示采用纵向堆叠配合内连接的方式进行合并,结果仅包含两个DataFrame在指定轴上重叠的索引。
pd.concat([first,second],join='inner',axis=0)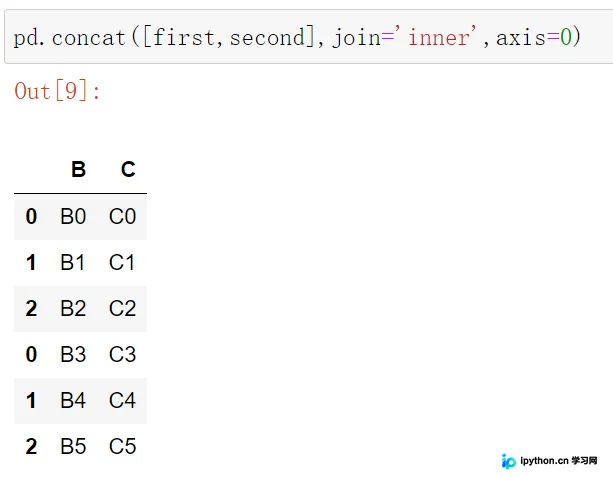
二、merge()函数
1)主键合并数据
使用merge()函数时,默认行为是选取重叠的列索引作为合并键,并采用内连接方式,即仅保留两个数据框中键值匹配的行。
import pandas as pd
left=pd.DataFrame({'key':['K0','K1','K2'],
                  'A':['A0','A1','A2'],
                  'B':['B0','B1','B2']})
left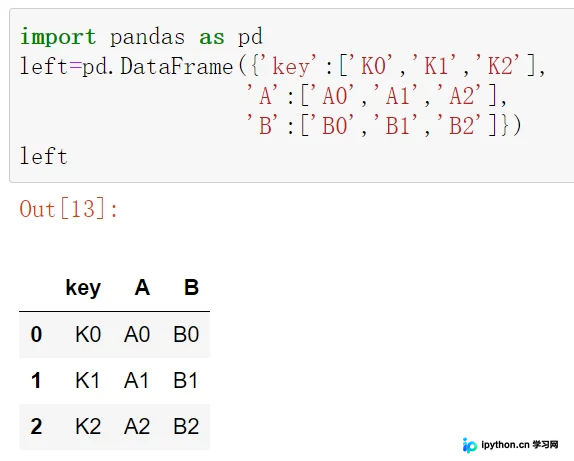
right=pd.DataFrame({'key':['K0','K1','K2','K3'],
                   'C':['C0','C1','C2','C3'],
                   'D':['D0','D1','D2','D3']})
right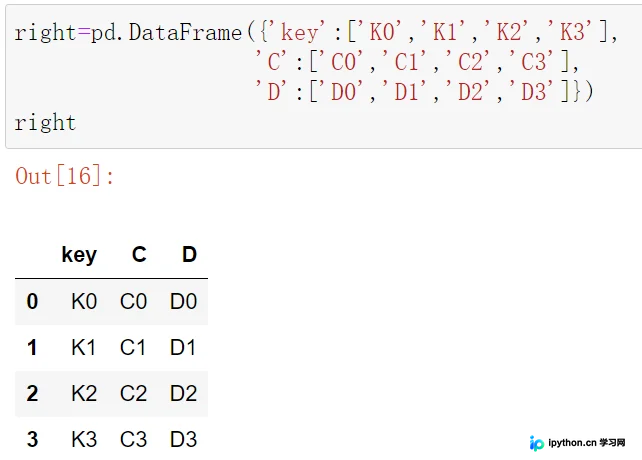
pd.merge(left,right,on='key')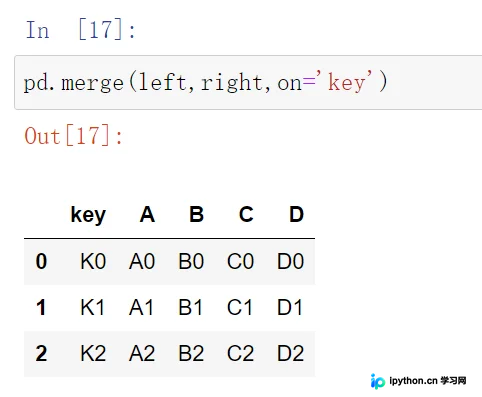
此外,merge()函数还支持对包含多个重叠列的DataFrame对象进行合并,可通过on参数指定多个键列。
import pandas as pd
data1=pd.DataFrame({'key':['K0','K1','K2'],
                  'A':['A0','A1','A2'],
                  'B':['B0','B1','B2']})
data1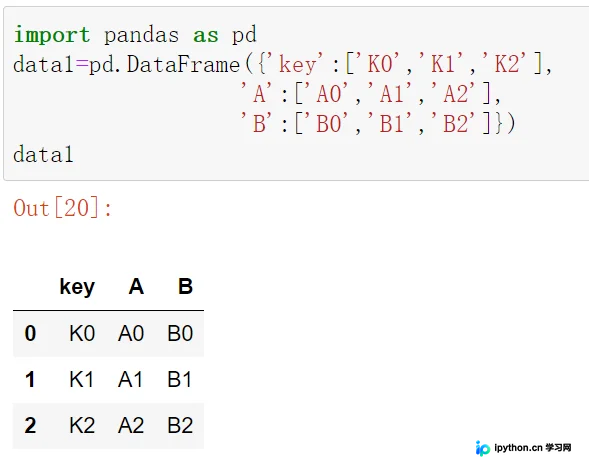
data2=pd.DataFrame({'key':['K0','K5','K2','K4'],
                         'B':['B0','B1','B2','B5'],
                         'C':['C0','C1','C2','C3'],
                         'D':['D0','D1','D2','D3']})
data2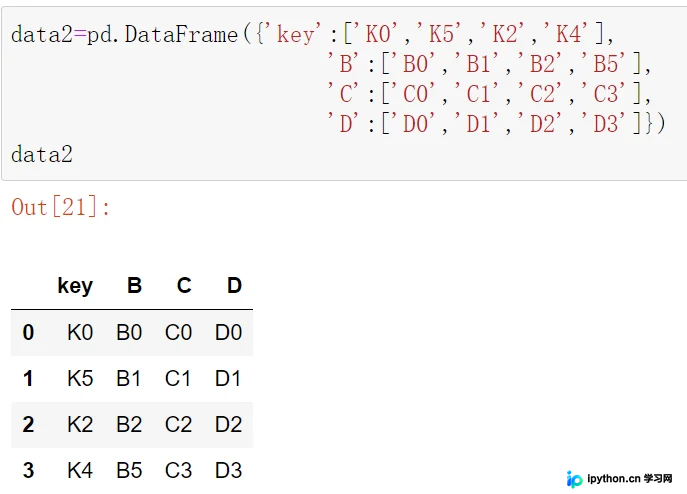
pd.merge(data1,data2,on=['key','B'])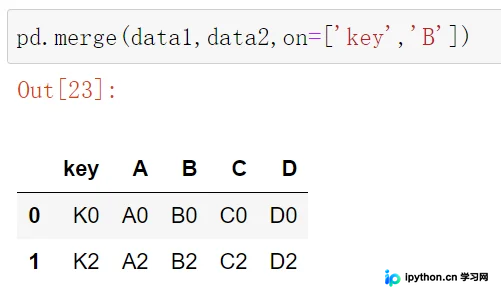
1)根据行索引合并数据
join()方法允许通过索引或指定列来连接多个DataFrame对象,适用于基于索引对齐的场景。
join(other,on = None,how =‘left’,lsuffix =‘’,rsuffix =‘’,sort = False )
| 参数 | 作用 |
|---|---|
| on | 名称,用于连接列名 |
| how | 可以从{‘‘left’’ ,‘‘right’’, ‘‘outer’’, ‘‘inner’’}中任选一个,默认使用左连接的方式。 |
| sort | 根据连接键对合并的数据进行排序,默认为False |
import pandas as pd
data3=pd.DataFrame({'A':['A0','A1','A2'],
                   'B':['B0','B1','B2']})
data3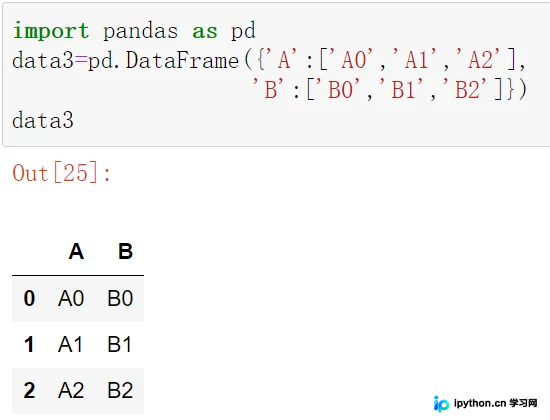
data4=pd.DataFrame({'C': ['C0', 'C1', 'C2'],
                         'D': ['D0', 'D1', 'D2']},
                     index=['a','b','c'])
data3.join(data4,how='outer')  # 外连接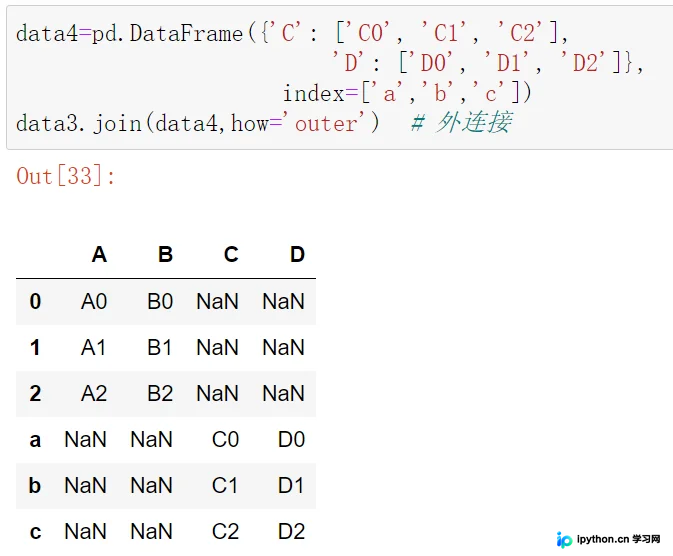
data3.join(data4,how='left') #左连接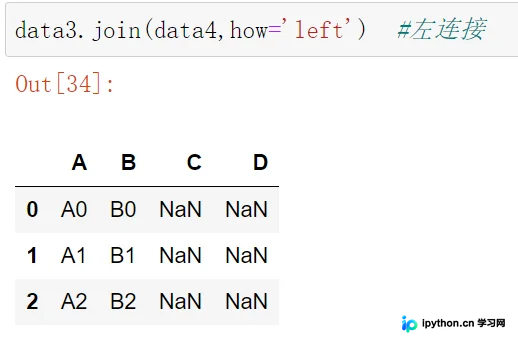
data3.join(data4,how='right') #右连接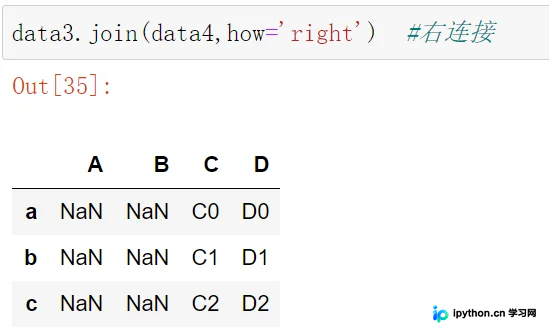
data3.join(data4,how='inner') #内连接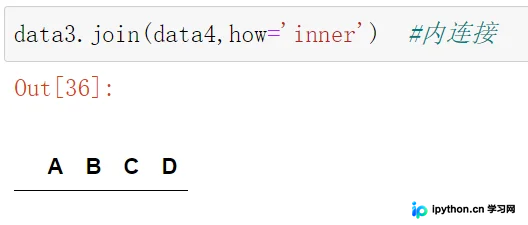
import pandas as pd
left = pd.DataFrame({'A': ['A0', 'A1', 'A2'],
                        'B': ['B0', 'B1', 'B2'],
                      'key': ['K0', 'K1', 'K2']})
left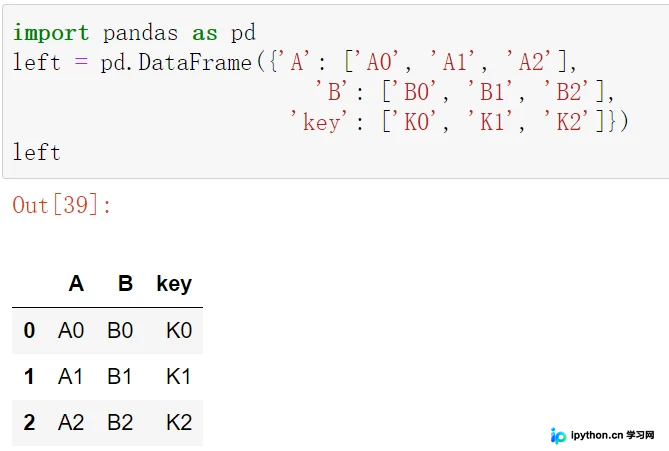
right = pd.DataFrame({'C': ['C0', 'C1','C2'],
                         'D': ['D0', 'D1','D2']},
                        index=['K0', 'K1','K2'])
right
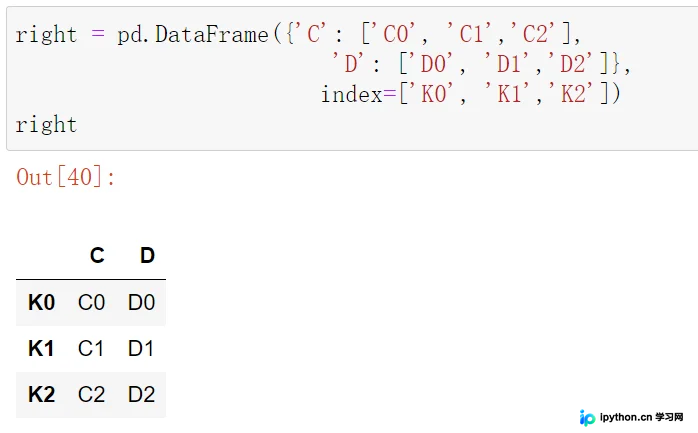
on参数用于明确指定用于连接的列名,若未指定则默认使用索引进行连接。
left.join(right,how='left',on='key') #on参数指定连接的列名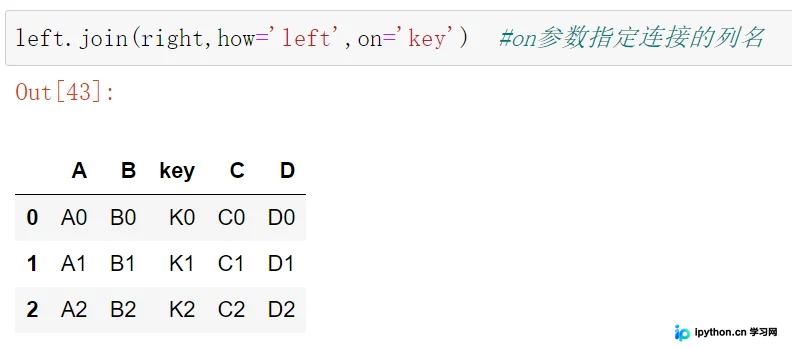
2)合并重叠数据
当DataFrame对象中存在缺失数据,而希望利用另一个DataFrame中的数据来填充这些空缺时,可以使用combine_first()方法。
import pandas as pd
import numpy as np
from numpy import NAN
left = pd.DataFrame({'A': [np.nan, 'A1', 'A2', 'A3'],
                        'B': [np.nan, 'B1', np.nan, 'B3'],
                        'key': ['K0', 'K1', 'K2', 'K3']})
left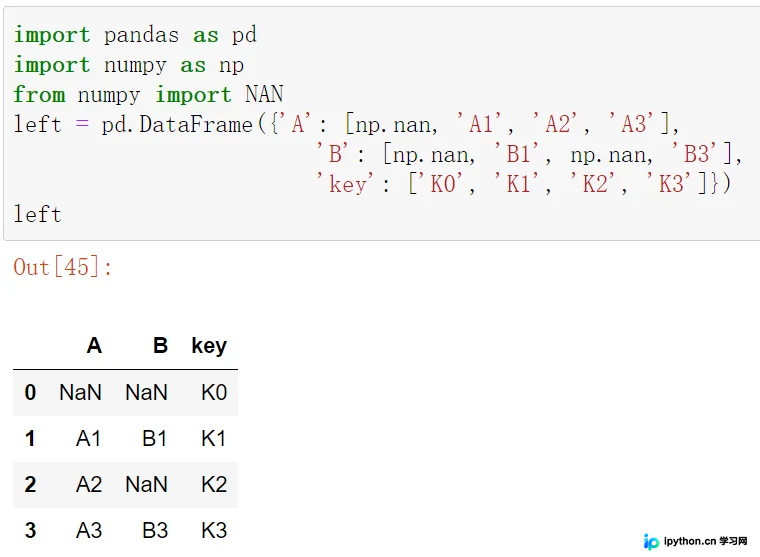
right = pd.DataFrame({'A': ['C0', 'C1','C2'],
                         'B': ['D0', 'D1','D2']},
                         index=[1,0,2])
right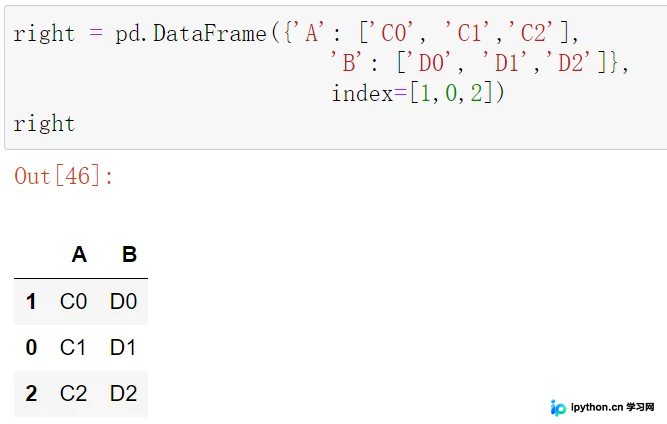
该方法利用right中的数据填充left中的缺失部分,保留left中非缺失的数据。
left.combine_first(right) # 用right的数据填充left缺失的部分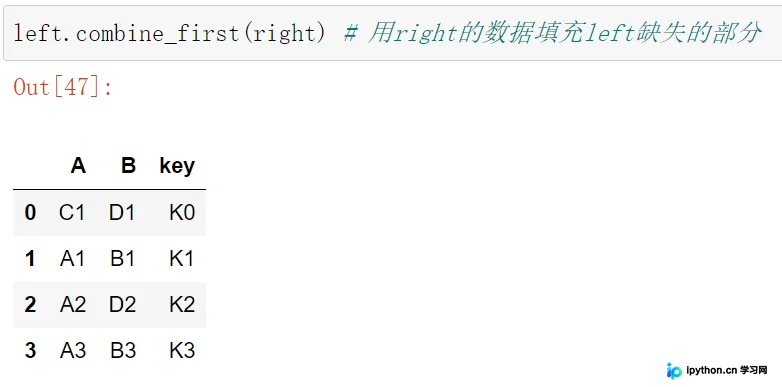
到此这篇关于Python数据合并的concat函数与merge函数详解的文章就介绍到这了,更多相关python 数据合并concat函数与merge函数内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









