

Python Seaborn分布图绘制:10个实战示例详解

本文通过10个具体示例,详细讲解如何使用Python的Seaborn库绘制分布图。内容涵盖直方图、核密度估计(KDE)图和经验累积分布函数(Ecdf)图的创建与参数调整,包括处理异常值、分类变量分组及二维分布等场景,帮助读者掌握数据探索中的关键可视化技巧。
前言
本文将通过10个具体示例,详细介绍如何利用Python中的Seaborn库来创建各类图表。
对于任何数据产品而言,首要任务都是深入理解原始数据。这一环节对于产品的成功与高效至关重要,往往占据了整个工作流程的很大比重。
理解和探索数据的方法多种多样,其中一种有效手段是进行数据可视化。通过可视化,我们能够更直观地探索和解读数据背后的信息。
设计精良且恰当的可视化图表,有助于我们揭示数据中隐藏的结构与内在关系。
在数据分析领域,分布图扮演着极其重要的角色。它们不仅能帮助我们识别异常值和数据的偏态特征,还能提供关于集中趋势(如平均值、中位数和众数)的概览。
为了演示,我们将使用Kaggle平台上提供的墨尔本住房数据集中的一小部分样本。
首先,我们需要导入必要的库,并将数据集读取到Pandas数据框中。
import pandas as pd
import seaborn as sns
sns.set(style="darkgrid", font_scale=1.2)
df = pd.read_csv(
  "/content/melb_housing.csv",
  usecols=["Regionname", "Type", "Rooms", "Distance", "Price"]
)
df.head()
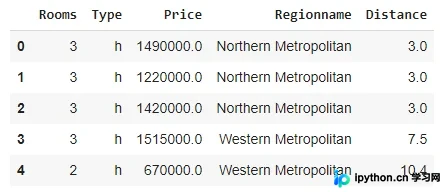
该数据集记录了墨尔本房屋的一些关键特征及其对应的价格信息。
Seaborn提供的离散绘图函数支持生成3种不同类型的分布图,具体包括:
- 柱状图(直方图)
- KDE(核密度估计)图
- Ecdf(经验累积分布函数)图
我们只需调整kind参数即可指定所需的绘图类型。
示例 1
第一个示例演示如何创建一个基本的直方图。该图表将连续变量的取值范围划分为离散的区间(箱子),并展示每个区间内的数值数量。
sns.displot(
  data=df,
  x="Price",
  kind="hist",
  aspect=1.4
)
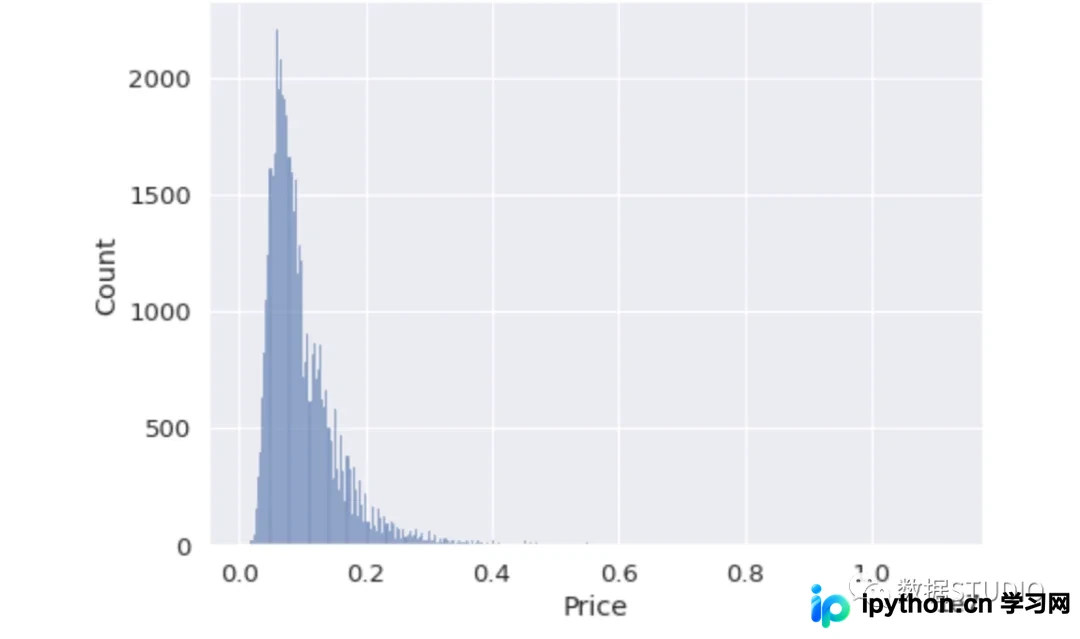
我们将数据框的名称传递给data参数,x参数用于指定要绘制的列名,aspect参数则用于调整图表的宽高比,同时也可通过height参数改变高度。
示例 2
从第一个示例的图表中可以清晰地看到,价格列中存在一些异常值。柱状图右侧呈现出长尾形态,这表明价格极高的房屋数量较少。
为了降低这种异常值对图表的影响,我们可以对数值取对数。displot函数提供了log_scale参数来实现这一操作。
sns.displot(
  data=df,
  x="Price",
  kind="hist",
  aspect=1.4,
  log_scale=10
)
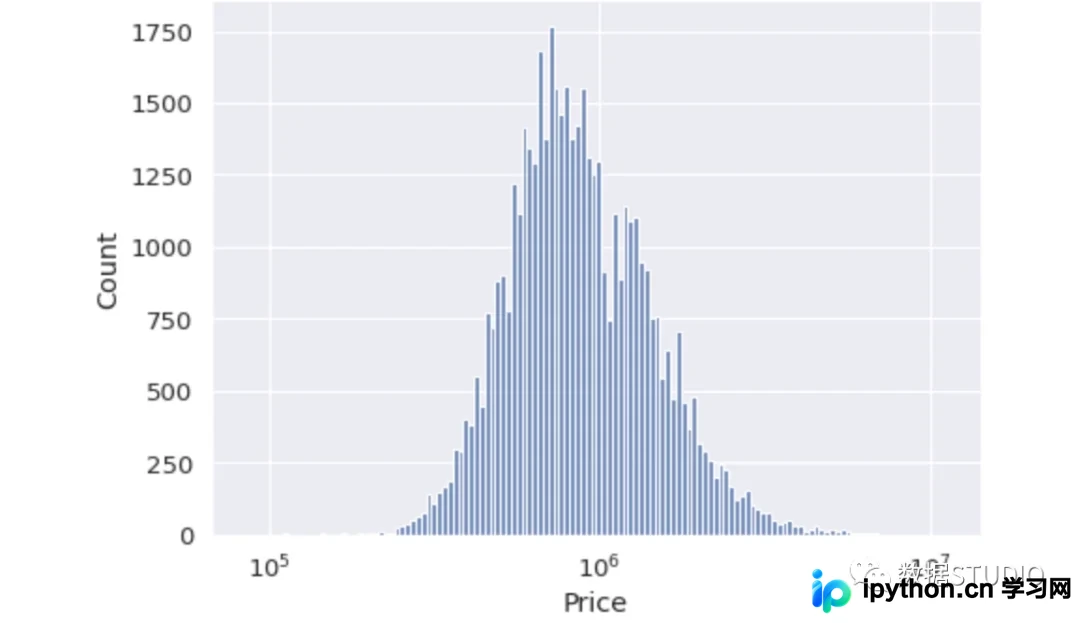
此时,价格以10的幂次方表示,从而让我们对房价分布有了更清晰的概览。
示例 3
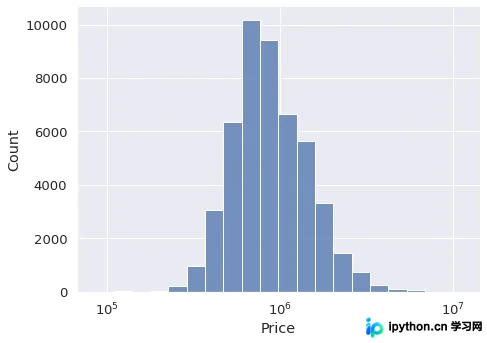
我们还可以调整直方图中的箱子数量。在某些情况下,使用较少的箱子数量能提供更结构化的概览。
用于此调整的参数是bins。
sns.displot(
  data=df,
  x="Price",
  kind="hist",
  aspect=1.4,
  log_scale=10,
  bins=20
)
示例 4
数据集中还包含分类变量。例如,Type列包含3个类别:h(独立房屋)、t(联排房屋)和u(公寓)。我们可能需要分别检查各类别的分布情况。
一种可行的方案是在同一张图表中用不同颜色展示各类别。只需将列名传递给hue参数即可实现。
sns.displot(
  data=df,
  x="Price",
  hue="Type",
  kind="hist",
  aspect=1.4,
  log_scale=10,
  bins=20
)
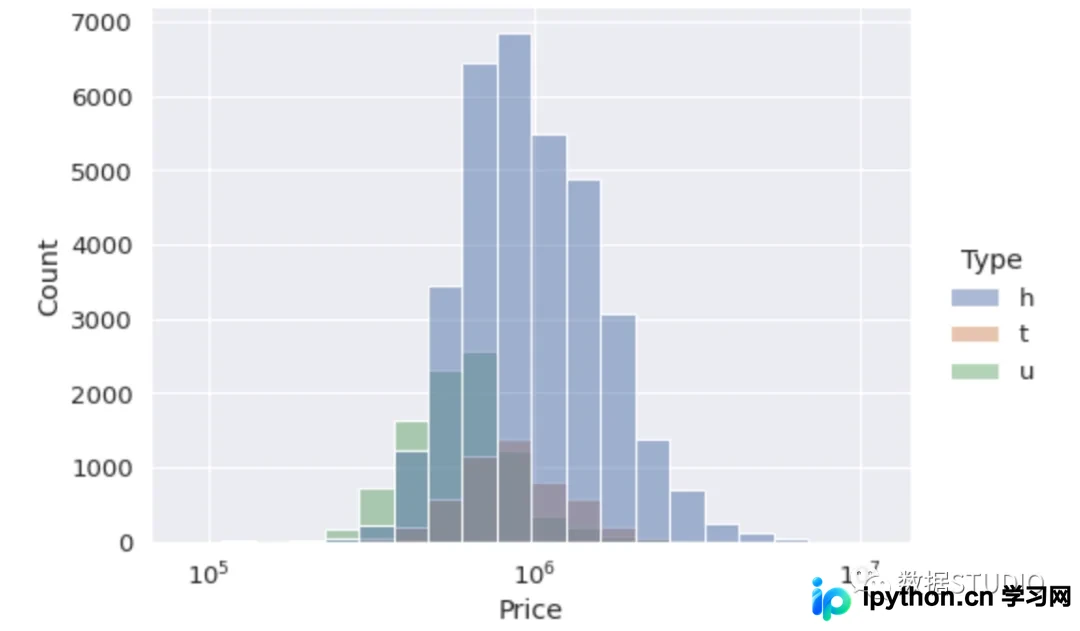
该图表提供了两条关键信息:
- 各类别的大小与房屋数量相关。其中,h类是最大的类别。
- 各类房屋的价格分布情况。
示例 5
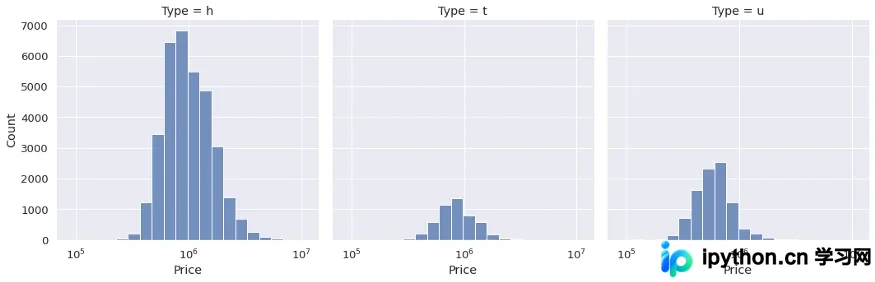
另一种检查各类别分布的方法是创建独立的子图。我们可以利用col或row参数来完成此任务,给定列中的每个类别都会生成一个子图。
sns.displot(
  data=df,
  x="Price",
  col="Type",
  kind="hist",
  aspect=1.4,
  log_scale=10,
  bins=20
)
例子 6
displot函数还支持生成二维直方图,从而提供关于两列中观测值(即行)分布的概览。
我们使用Price和Distance列创建了一个二维直方图,只需将列名分别传递给x和y参数即可。
sns.displot(
  data=df,
  x="Price",
  y="Distance",
  col="Type",
  kind="hist",
  height=5,
  aspect=1.2,
  log_scale=(10,0),
  bins=20
)
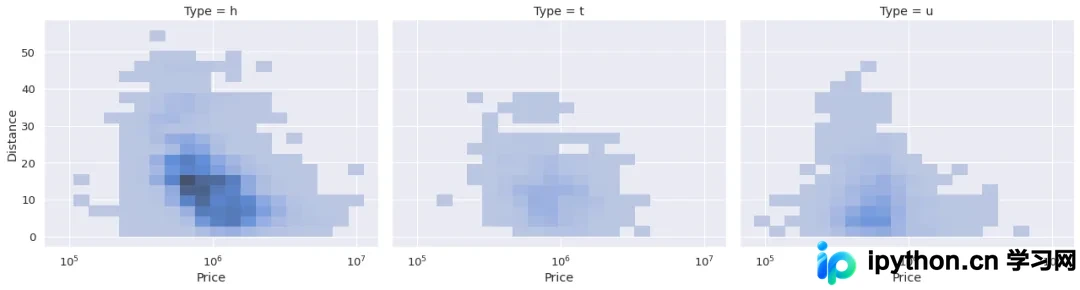
颜色较深的区域密度更大,包含更多的观测数据。由于密集区域位于中心,这两列数据看起来都呈正态分布。
您可能已经注意到,我们将一个元组作为log_scale参数的值。因此,我们可以为每一列传递不同的比例尺。
例子 7
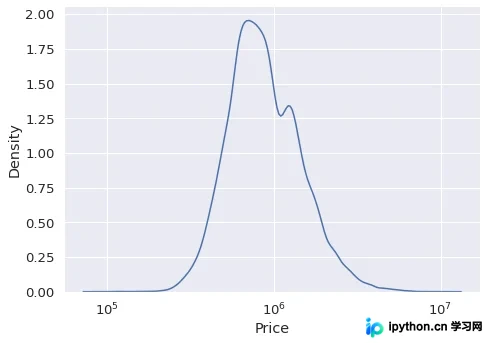
KDE图同样可用于可视化变量的分布。它们与直方图相似,但KDE图使用连续的概率密度曲线来表示分布,而非离散的箱子。
将kind参数设置为“kde”即可生成KDE图。
sns.displot(
  data=df,
  x="Price",
  kind="kde",
  aspect=1.4,
  log_scale=10
)
示例 8
与直方图类似,我们可以为不同的类别分别绘制KDE图。我们的数据集包含房屋的区域信息,接下来我们将观察不同地区的价格变化。
sns.displot(
  data=df,
  x="Price",
  hue="Regionname",
  kind="kde",
  height=6,
  aspect=1.4,
  log_scale=10
)
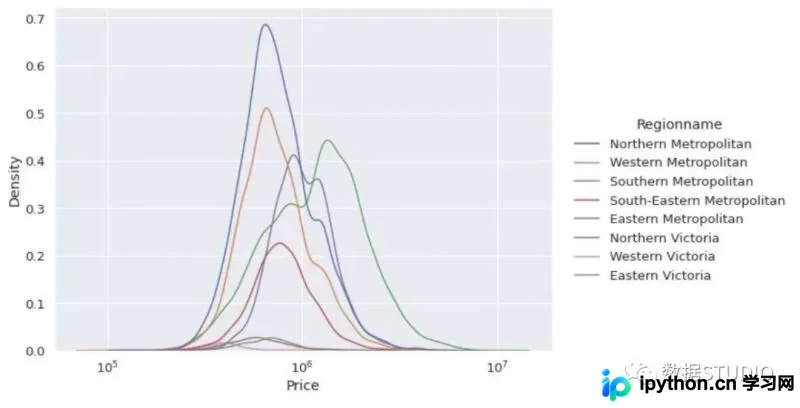
数据显示,南部大都市区的平均房价似乎最高。
示例 9
检查变量分布的另一种方法是使用Ecdf图。它展示了低于给定列中每个唯一值的观测值的比例或计数。
这是一种累积分布的可视化方式,因此我们能够观察到更密集的值范围。
sns.displot(
  data=df,
  x="Distance",
  kind="ecdf",
  height=6,
  aspect=1.4,
  stat="count"
)
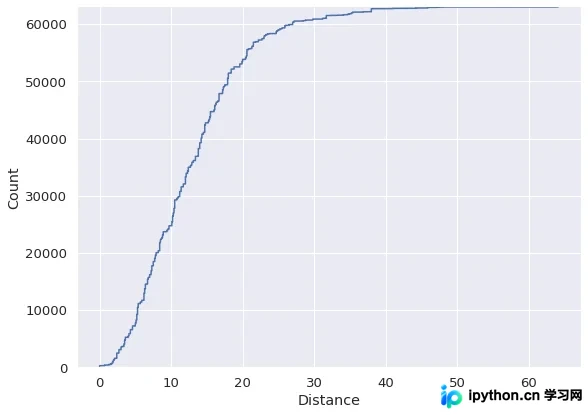
曲线斜率较高的值范围包含更多的观测值。例如,距离超过30的房屋数量并不多;相反,在距离10到15的范围内有大量的房屋。
示例10
Ecdf图同样支持hue、col和row参数。因此,我们可以在单列图表中区分不同类别之间的分布差异。
sns.displot(
  data=df,
  x="Distance",
  kind="ecdf",
  hue="Type",
  height=6,
  aspect=1.4,
  stat="count"
)
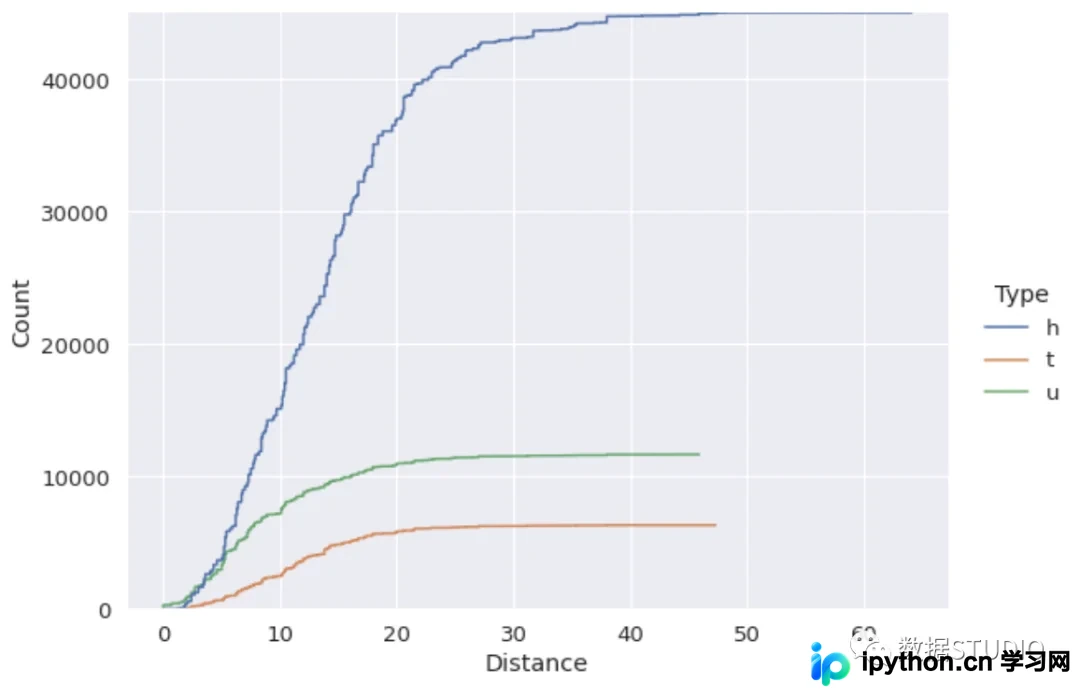
对于数据分析或机器学习任务,了解变量(即特征)的分布至关重要,我们处理特定任务的方式往往取决于数据的分布形态。
在本文中,我们展示了如何利用Seaborn的displot函数来分析Price和Distance列的分布情况。
以上就是Python+Seaborn绘制分布图的示例详解的详细内容,更多关于Python Seaborn分布图的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









