SQL Server T-SQL高级查询实战指南
本文详细解析 SQL Server T-SQL 的高级查询技巧,涵盖基础聚合、嵌套子查询(IN/EXISTS)、集合运算(UNION/INTERSECT)及公用表表达式(CTE)。重点讲解 ROW_NUMBER、RANK 等排序函数在不同场景下的应用,并系统梳理日期、字符串、安全及自定义函数的编写方法,助力高效数据处理。
2026-10-13
7

本文详细解析 SQL Server T-SQL 的高级查询技巧,涵盖基础聚合、嵌套子查询(IN/EXISTS)、集合运算(UNION/INTERSECT)及公用表表达式(CTE)。重点讲解 ROW_NUMBER、RANK 等排序函数在不同场景下的应用,并系统梳理日期、字符串、安全及自定义函数的编写方法,助力高效数据处理。
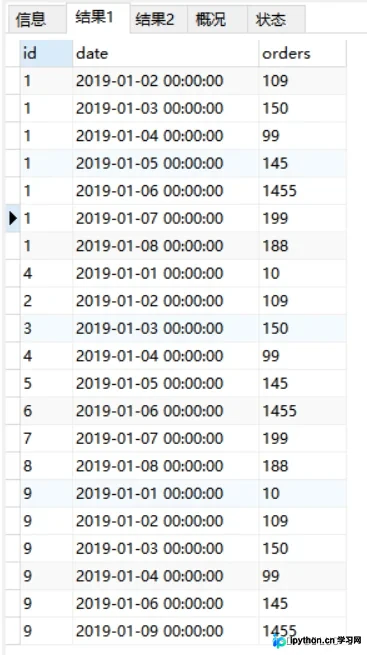
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
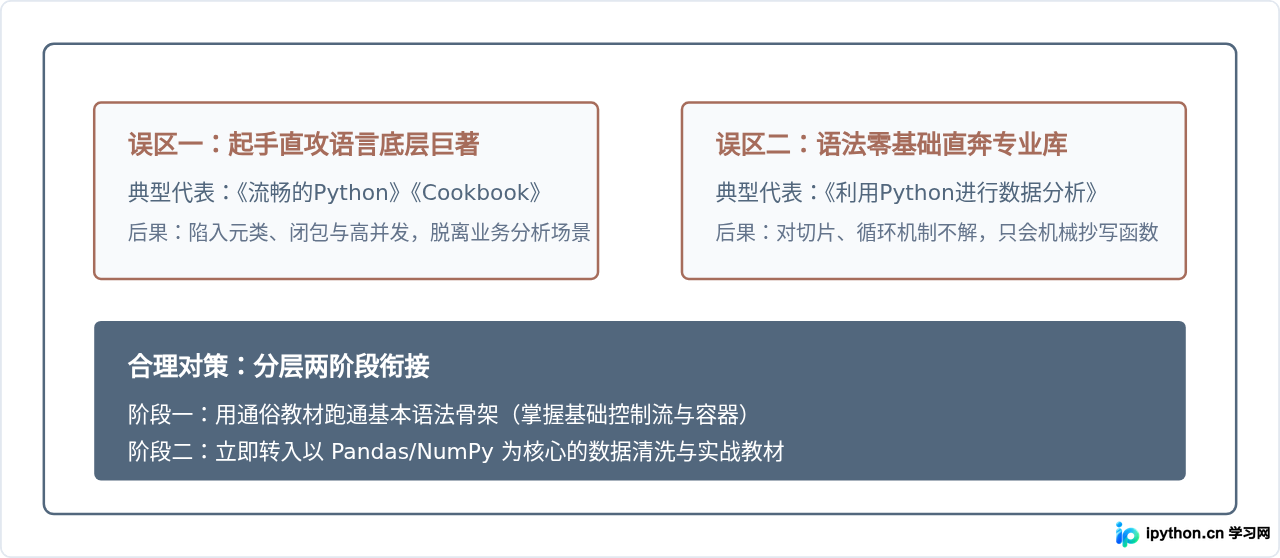
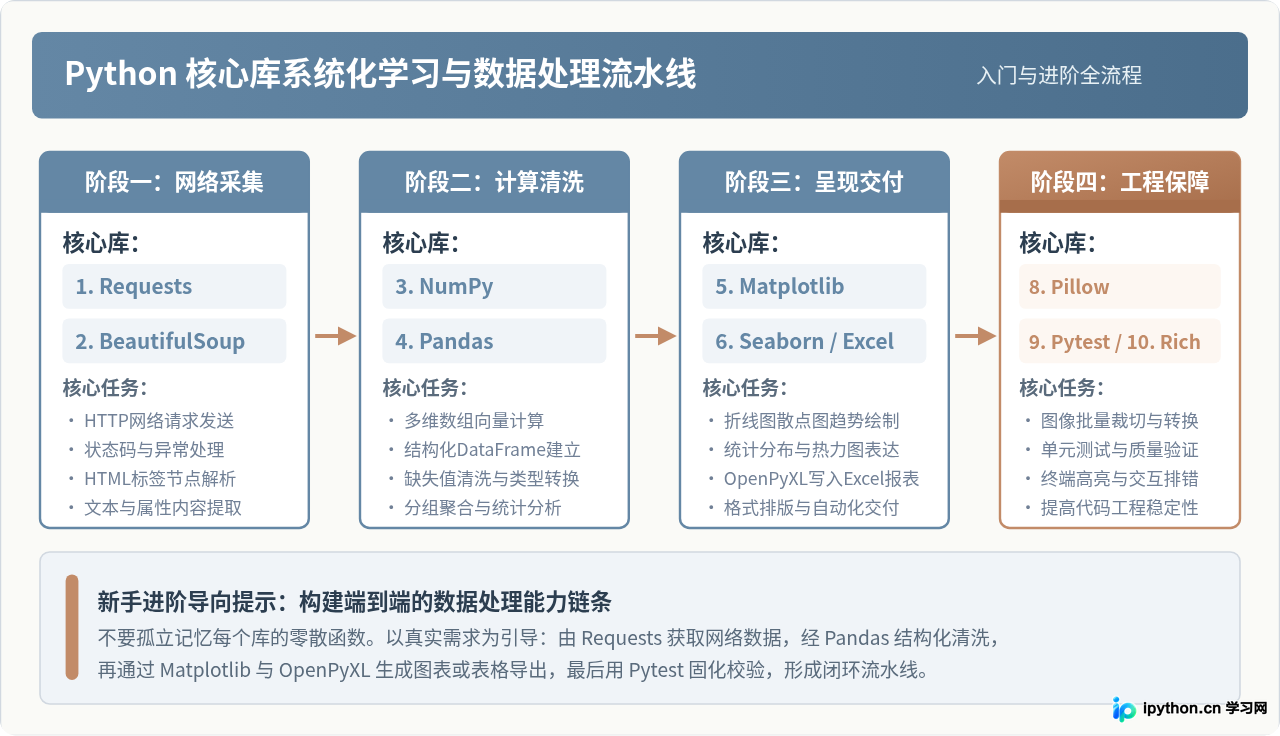
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
本文介绍如何利用Python的unicodedata模块,通过一行代码高效清洗文本中的各类特殊符号。文章解析了Unicode符号的四大分类,提供了针对所有符号及特定类别(如箭头、几何图形)的过滤代码示例,并指导用户通过官方文档查询符号类别,实现精准的数据预处理。
本文详细介绍在Python中按天生成时间范围序列的三种常用方法。首先利用标准库datetime结合timedelta手动计算;其次介绍使用第三方库Arrow简化日期遍历;最后展示Pandas库中date_range和truncate函数在生成不同间隔及截断时间段序列中的高级应用,帮助开发者灵活处理日期数据。
本文介绍pandas处理Excel中超过14位数字自动转换为科学计数法的问题。提供两种解决方案:数据量小时使用to_csv替代to_excel;通用方法是在read_excel时指定dtype=str将所有数据读为字符串。此外,还讨论了将特定字段转为int类型时需先处理空值的注意事项,以避免转换错误。
本文详细介绍Python中Pandas库的两种核心排序方法:sort_index用于按索引或列名排序,sort_values用于按数值大小排序。涵盖单列与多列排序、升降序控制、inplace参数应用及缺失值处理策略,帮助开发者高效完成数据整理任务。
本文介绍了五个使用Python进行数据清理的实用脚本,涵盖从PDF提取表格、合并多个CSV文件、删除重复行、拆分列以及合并不同数据集等常见场景。通过Pandas库实现自动化处理,显著提升机器学习前的数据准备效率,适用于Tableau等可视化工具及各类模型训练前的数据预处理环节。
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
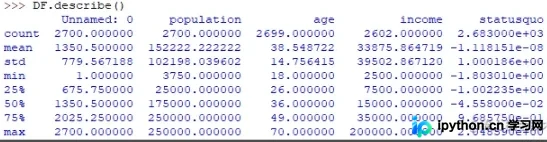
本文详解 Python 中的探索性数据分析(EDA)流程。通过 Pandas 的 describe() 和 value_counts() 快速获取数据分布与分类计数,利用 matplotlib 绘制箱线图识别异常值。进一步使用 groupby 进行分组统计,结合 scipy 的 f_oneway() 执行 ANOVA 方差分析,并通过 Pearson 相关系数评估变量间的相关性,帮助数据分析师深入理解数据特征与变量关系。
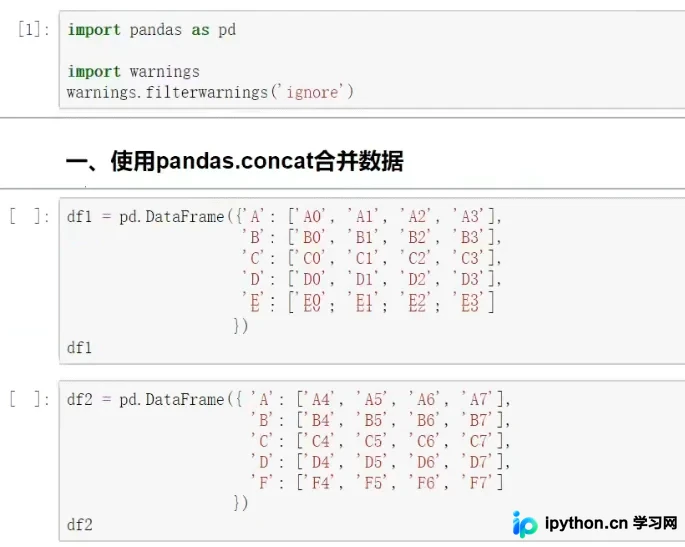
本文详细介绍Python Pandas库中concat和append函数的使用方法。涵盖批量合并Excel、添加行列数据等场景,解析objs、axis、join及ignore_index等核心参数,并通过代码案例演示如何高效合并多个Pandas对象。