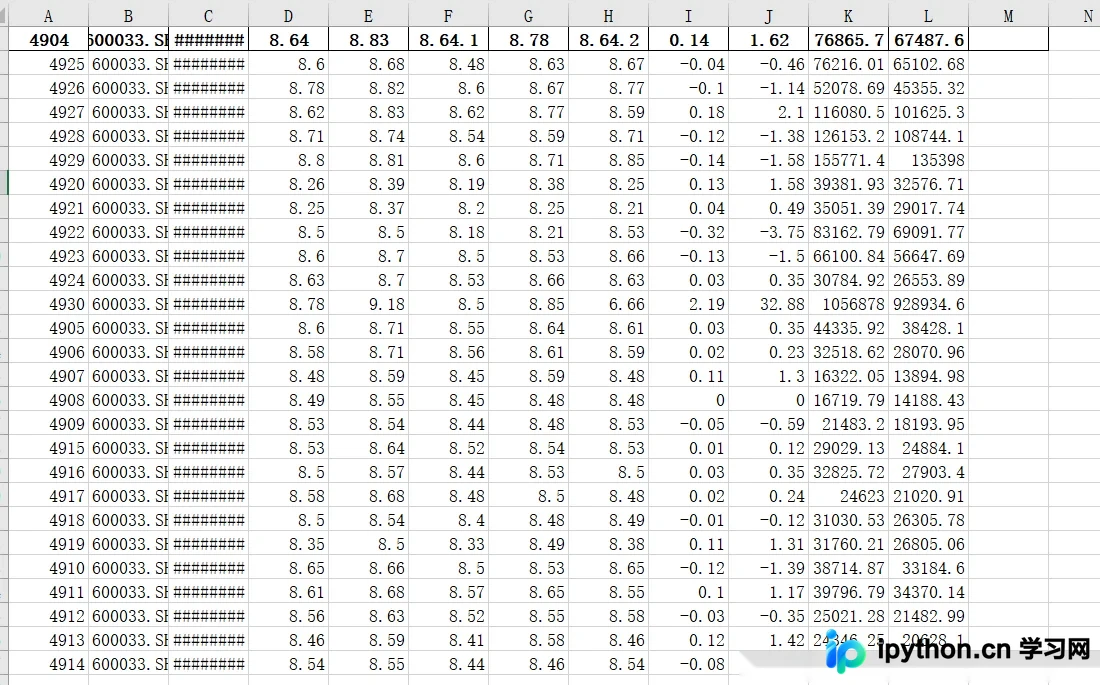
Python读取CSV文件时如何添加或修改表头
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
2026-10-16
7

本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
本文详细解析Pandas中Series的一维数据结构及其核心属性。涵盖index、values、dtype、shape、nbytes、memory_usage等关键属性的定义、返回值类型及实际代码示例,帮助开发者掌握Series在数据清洗与可视化中的应用。
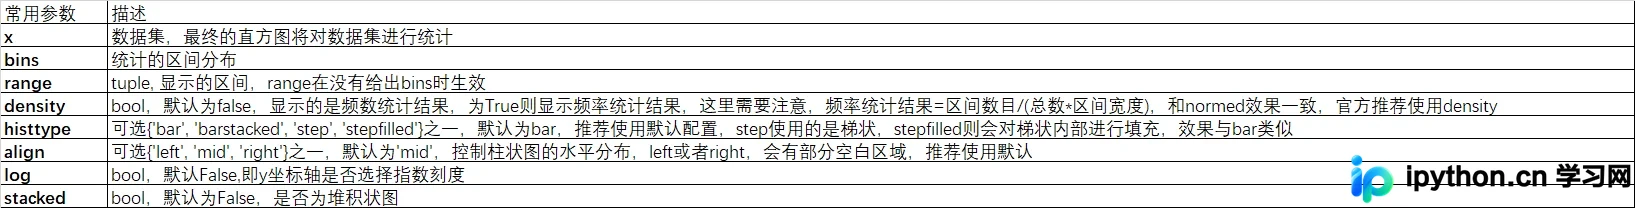
本文详解matplotlib中直方图的绘制方法与核心参数配置。涵盖基础统计直方图、概率密度分布(PDF/CDF)、堆叠直方图及多子图布局技巧。提供连接数据库、DataFrame绘图及复杂数据可视化的完整代码模板,帮助开发者高效实现数据分布分析。
本文深入解析Python中Pyecharts库的使用,涵盖饼图、柱状图、箱线图及热力图等常见图表的创建方法。详细讲解add_xaxis、add_yaxis及set_global_opts等核心API,并提供链式调用与面向对象两种编程风格的代码示例,帮助开发者快速实现交互式数据可视化。
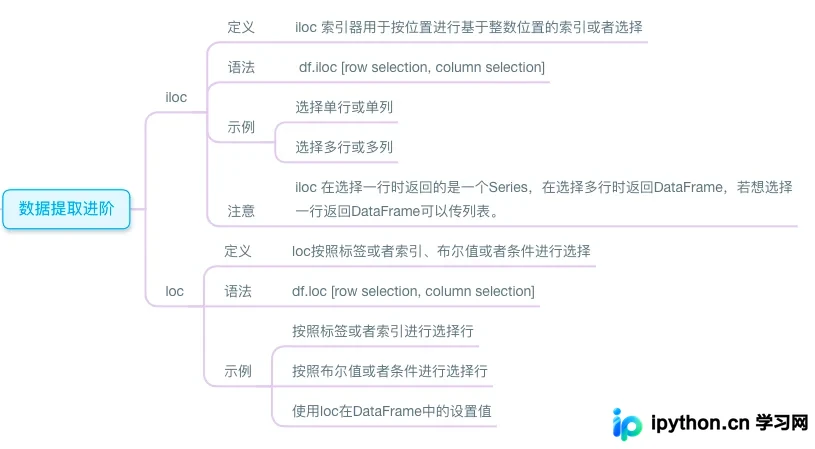
本文详解Python Pandas库中iloc和loc两种核心索引器的用法。iloc基于整数位置进行数据选取,返回Series或DataFrame;loc基于标签、索引或布尔条件进行筛选。通过具体代码示例,展示如何根据位置或标签选择单行、多列及设置值,帮助开发者高效处理数据。
本文深入解析Python Pandas库中loc和iloc两个核心索引函数的区别。loc基于标签(Label)进行数据选取,支持切片包含右边界;iloc基于整数位置(Position)进行索引,遵循左闭右开原则。通过具体代码示例对比两者在行列选取时的不同表现,帮助开发者准确掌握数据筛选技巧。
本文介绍利用Pandas库实现Excel文件的批量拆分与合并操作。通过iloc方法将大文件按行数均分保存,结合os模块遍历读取子文件并添加来源标记,最终使用pd.concat合并为单一Excel。
本文详细介绍Python中matplotlib库的核心绘图函数。涵盖bar()绘制柱形图、barh()绘制条形图、plot()绘制折线图及pie()绘制饼图与圆环图。重点解析width、color、linewidth、marker、explode等关键参数的用法,帮助读者快速掌握基础图表绘制技巧。
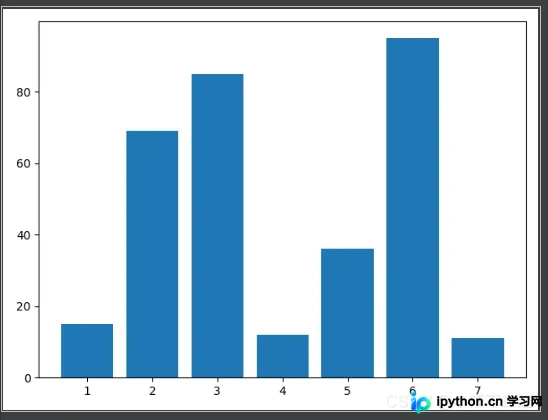
本文详细介绍如何使用Python pandas库计算数据的方差和标准差。内容涵盖对全表、单独行列以及多行列的操作方法,通过具体代码示例展示df.var()和df.std()函数的用法及axis参数的影响,帮助开发者快速掌握统计计算技巧。
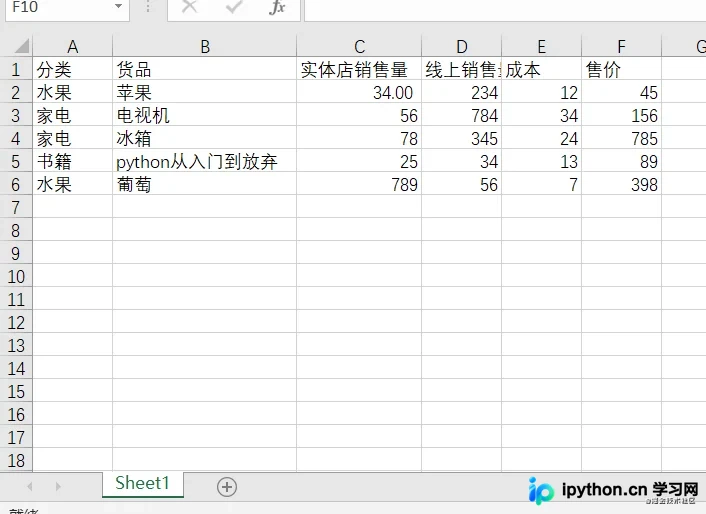
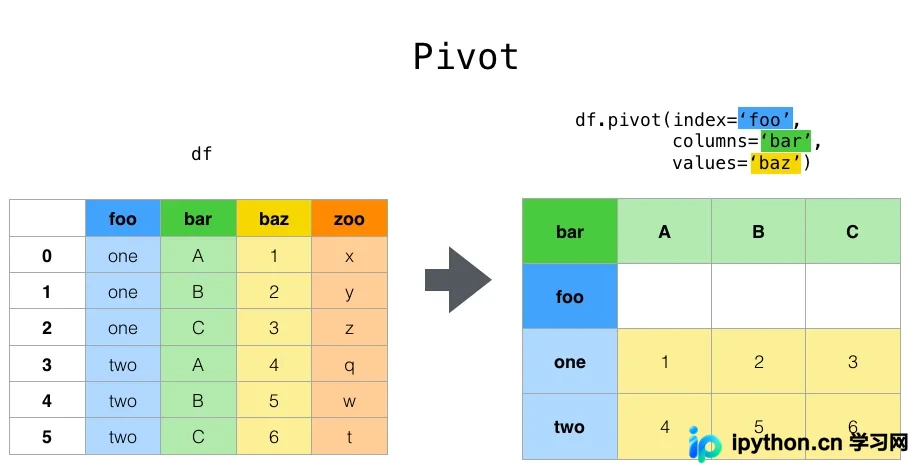
本文深入解析Pandas中DataFrame的重排与旋转技术。详细讲解pivot函数的索引、列及值重组机制,对比stack与unstack在层级索引转换中的反向操作,阐述melt将宽表转为长表的标志变量用法,并介绍pivot_table聚合统计、crosstab交叉计数及get_dummies独热编码的具体实现与参数配置。
本文介绍在Django框架中接收前端上传的xlsx文件后的两种处理方式:一是利用pandas直接读取文件内容转化为DataFrame进行数据处理,二是将文件直接保存至服务器指定路径。文章提供了urls.py路由配置及view.py视图函数的完整代码示例,涵盖文件获取、路径定义及保存逻辑。
本文详细介绍Python数据分析核心库Pandas的基础知识。内容涵盖Pandas的定义、命名由来及主要功能,重点解析Series一维数组与DataFrame二维表格两种核心数据结构。同时提供Pandas在Anaconda环境下的安装方法,并通过具体代码示例演示Series和DataFrame的创建、参数设置、索引操作及数据取值技巧,帮助初学者快速掌握数据处理基础。