

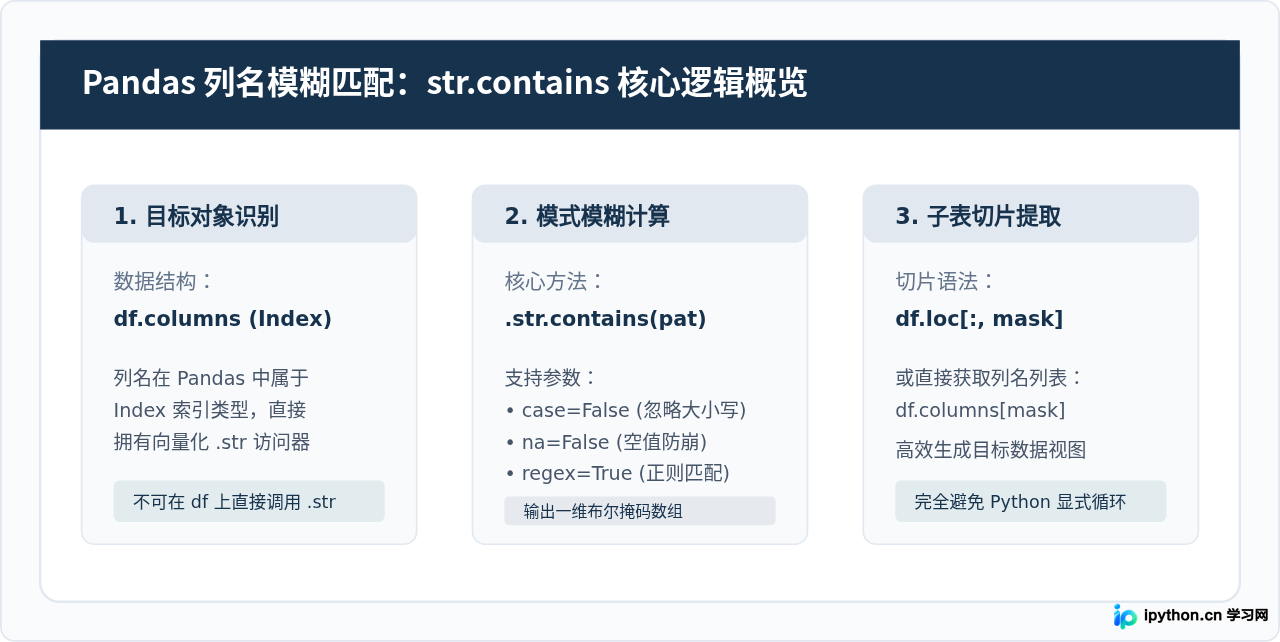
Python Pandas怎么用str.contains模糊匹配列名
详细讲解在Python Pandas中使用str.contains对DataFrame列名进行模糊匹配的实用方法,包含核心语法、布尔掩码筛选、大小写忽略、多条件正则组合及常见避坑指南。
2026-10-10
8

详细讲解在Python Pandas中使用str.contains对DataFrame列名进行模糊匹配的实用方法,包含核心语法、布尔掩码筛选、大小写忽略、多条件正则组合及常见避坑指南。
本文深入解析SQL查询中WHERE与HAVING子句的核心差异。WHERE在分组前过滤行,不支持聚合函数;HAVING在分组后过滤组,常配合GROUP BY及聚合函数使用。通过对比执行顺序与作用对象,掌握高效编写SQL语句的正确姿势,避免性能陷阱。
本文通过一道经典SQL练习题,解析如何查询特定城市且订单数少于3的消费者。重点对比了子查询、内连接与左连接的区别,深入探讨为何在处理可能不存在关联记录的场景下必须使用左连接,并展示了如何通过COUNT统计和GROUP BY分组准确得出结果。
在R语言中,常需将连续数值转换为分类数据。本文介绍三种实现方式:使用attach/detach进行直接索引赋值;使用within()优化作用域管理;以及利用cut()函数配合breaks、labels及区间控制参数(right、include.lowest)进行高效分箱。重点解析cut函数的开闭区间逻辑及极端值处理细节。
本文介绍在R语言中处理TCGA等大规模生物信息数据的技巧,重点解决如何批量读取指定路径下的多个文本文件。通过遍历目录、提取元数据映射ID、使用data.table::fread加速读取,并结合for循环或lapply函数将各文件的第二列(如基因表达量)合并为一个完整的数据框,最终生成包含所有样本的表达式矩阵。
本文详细解析 SQL Server T-SQL 的高级查询技巧,涵盖基础聚合、嵌套子查询(IN/EXISTS)、集合运算(UNION/INTERSECT)及公用表表达式(CTE)。重点讲解 ROW_NUMBER、RANK 等排序函数在不同场景下的应用,并系统梳理日期、字符串、安全及自定义函数的编写方法,助力高效数据处理。
本文介绍使用 MySQL 窗口函数 ROW_NUMBER() 结合日期减法,解决“连续 N 天登录用户”查询的技术方案。通过为每日记录排序并减去天数,生成恒定日期分组,从而利用 COUNT 和 HAVING 筛选出满足连续天数要求的用户及起止时间。
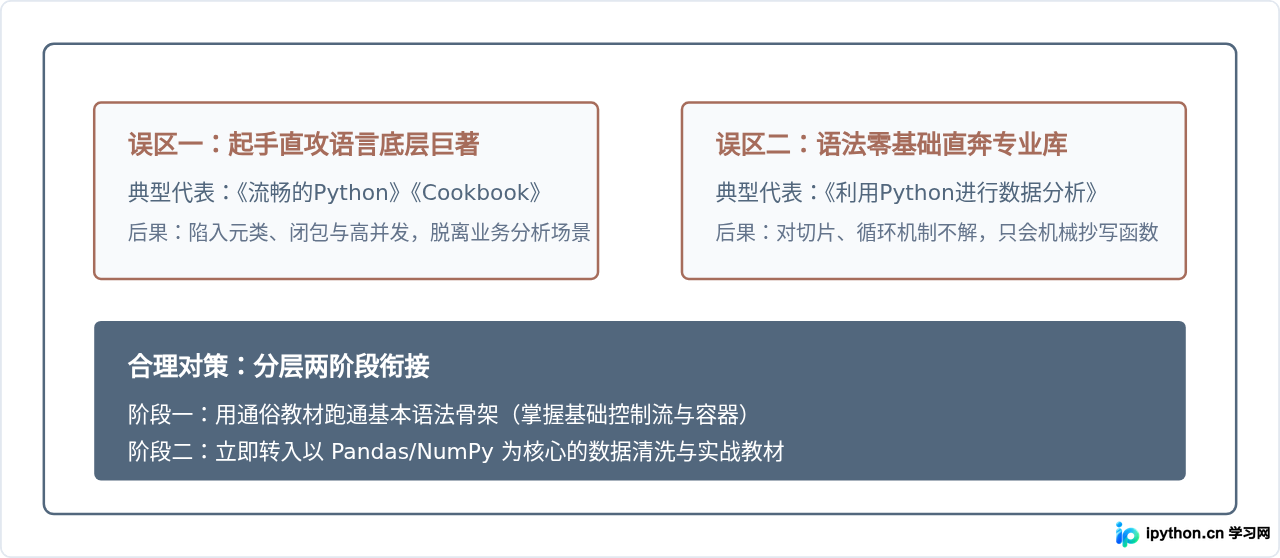
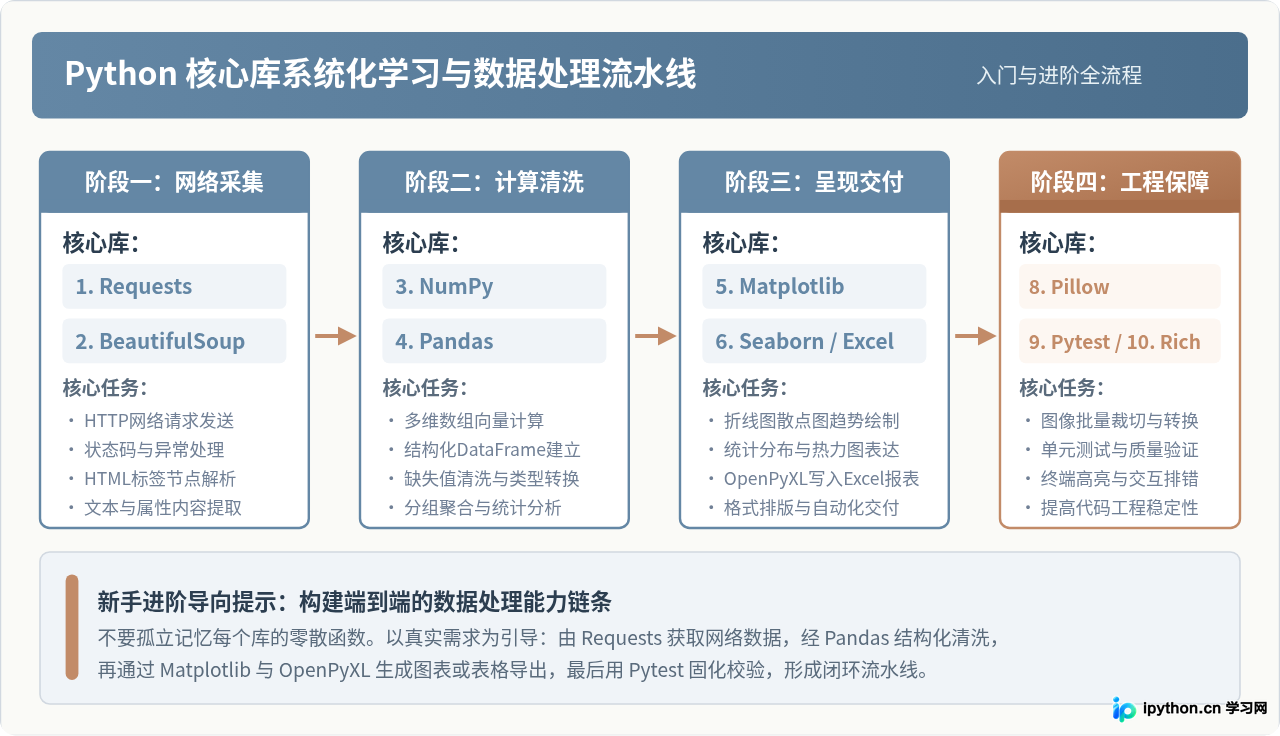
专为Python初学者梳理的10个核心第三方库入门指南,涵盖Requests、Pandas、NumPy、BeautifulSoup等高频库的适用场景、核心用法、示例代码与避坑要点。
本文介绍如何利用Python的unicodedata模块,通过一行代码高效清洗文本中的各类特殊符号。文章解析了Unicode符号的四大分类,提供了针对所有符号及特定类别(如箭头、几何图形)的过滤代码示例,并指导用户通过官方文档查询符号类别,实现精准的数据预处理。
本文详细介绍在Python中按天生成时间范围序列的三种常用方法。首先利用标准库datetime结合timedelta手动计算;其次介绍使用第三方库Arrow简化日期遍历;最后展示Pandas库中date_range和truncate函数在生成不同间隔及截断时间段序列中的高级应用,帮助开发者灵活处理日期数据。
本文介绍pandas处理Excel中超过14位数字自动转换为科学计数法的问题。提供两种解决方案:数据量小时使用to_csv替代to_excel;通用方法是在read_excel时指定dtype=str将所有数据读为字符串。此外,还讨论了将特定字段转为int类型时需先处理空值的注意事项,以避免转换错误。