Python利用pandas将Excel文件转换为TXT文件的方法
本文介绍如何利用Python中已有的pandas库,无需安装额外插件,即可实现Excel文件到TXT文件的转换。通过示例代码展示了具体的转换逻辑及后续的数据清洗步骤,包括去除行首数字和空格以及去重处理,为数据处理提供便捷方案。
2026-10-13
6

本文介绍如何利用Python中已有的pandas库,无需安装额外插件,即可实现Excel文件到TXT文件的转换。通过示例代码展示了具体的转换逻辑及后续的数据清洗步骤,包括去除行首数字和空格以及去重处理,为数据处理提供便捷方案。
本文详解Python处理CSV、Excel、TXT及DAT文件的方法。涵盖csv库与pandas读取写入技巧,对比xlrd与pandas在Excel处理上的差异,演示TXT逐行读取与DAT格式转换。通过代码示例解析数据提取、列表转换及自动化参数化应用,帮助开发者高效处理各类数据文件。
本文介绍在Python数据分析中使用matplotlib库绘制多个子图时,如何有效调整子图间距。通过plt.subplot定义子图位置,并配合plt.tight_layout()自动优化布局,解决子图重叠问题。文章提供三种典型场景的代码示例,包括基础双行布局、5x5网格及10x10大图展示,帮助开发者快速掌握子图排版技巧。
本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
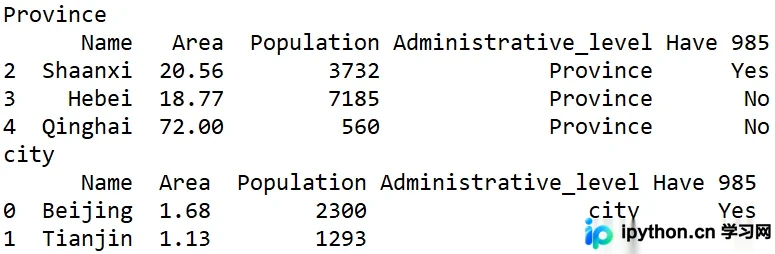
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
在使用pandas读取CSV文件时,常因索引列处理不当出现“Unnamed: 0”列。本文介绍利用列索引重命名或drop方法处理此类冗余列的技巧,并汇总了DataFrame选取行与列的多种常用方法,包括切片、索引器及特定行/列获取函数,帮助提升数据处理效率。
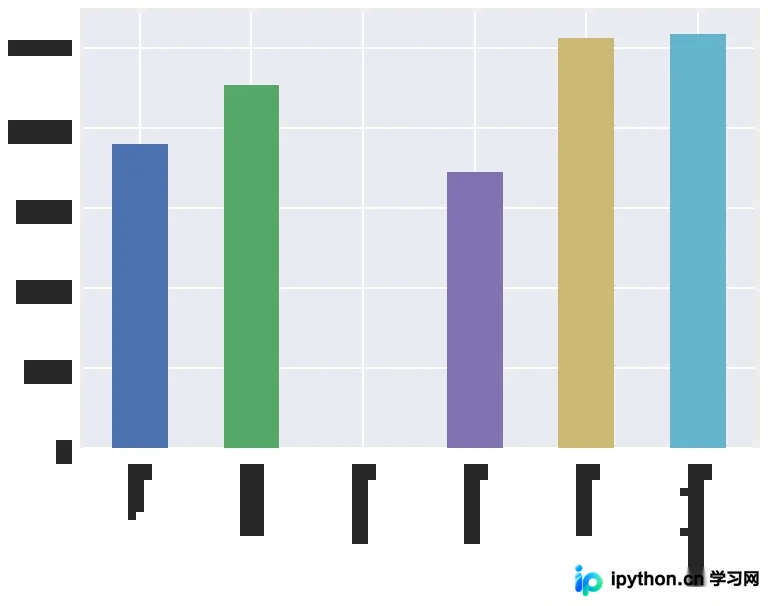
本文介绍如何在pandas中使用groupby进行分组统计后,按照自定义的特定顺序输出结果。通过定义索引列表并应用于groupby对象,可确保数据按期望顺序排列,进而生成符合逻辑的柱状图,便于后续对比分析与绘图展示。
本文介绍在Python Pandas中如何处理DataFrame的多列去重及差集运算。通过drop_duplicates方法指定subset参数实现基于多字段的去重;利用append合并数据后再次调用drop_duplicates并设置keep=False,可高效去除两个数据框中重复的行,保留唯一差异记录。
本文对比了CSV与NumPy .npy格式在存储效率上的差异,并通过实例演示了如何利用NamedTemporaryFile进行临时文件操作。文章详细讲解了使用np.save保存数组、检查.npy文件大小及形状的方法,并进一步介绍了利用pickle格式序列化存储pandas DataFrame的过程及读取方式,展示了.npy文件相比CSV显著更小的体积优势。
本文详解Python中collections.Counter类的四种字典创建方式,包括从可迭代对象、字典及关键字参数构建。重点解析Counter在统计Key出现频次及获取最高频项方面的优势,并深入探讨修改Value时的特殊行为:将Key的Value设为0不会删除该Key,需使用del语句真正移除元素,避免常见编程误区。
在使用pandas读取文件名含中文的csv文件时,常因默认C引擎兼容性问题触发OSError。通过将read_csv函数的engine参数显式设置为'python',可解决中文标题读取错误,尽管速度略慢但功能更完备。
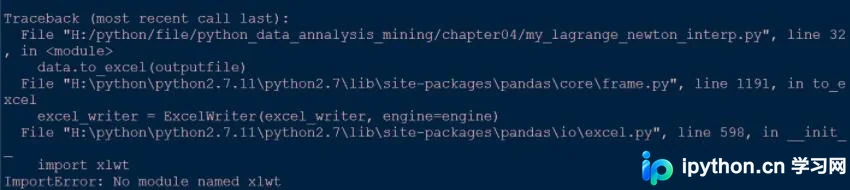
本文针对Python使用pandas库将DataFrame写入Excel时遇到的两个常见错误进行解析。首先介绍如何通过pip安装缺失的xlwt依赖库;其次重点解决因Windows路径中单斜杠导致的to_excel报错,指出需将路径中的单斜杠替换为双斜杠以正确处理转义字符,确保文件成功保存。