

Python调用高德API实现批量地址转经纬度并写入表格的功能
本文介绍如何使用Python调用高德地图Web服务API,实现从CSV文件批量读取地址并转换为经纬度的功能。通过requests发送请求,利用pandas库处理数据,最终将转换结果保存为新的CSV表格,适用于需要批量地理编码的场景。
2026-10-14
6

本文介绍如何使用Python调用高德地图Web服务API,实现从CSV文件批量读取地址并转换为经纬度的功能。通过requests发送请求,利用pandas库处理数据,最终将转换结果保存为新的CSV表格,适用于需要批量地理编码的场景。
本文系统讲解Pandas中缺失数据的处理流程。涵盖isna/isnull统计逻辑、dropna删除策略及thresh参数、fillna填充方法(含ffill/bfill与分组填充)、interpolate插值算法(线性、最邻近、索引插值)。同时解析np.nan与pd.NA的类型差异及Nullable类型优势,结合分类检验与KNN回归示例,提供完整代码实现与参数说明。
本文详细介绍Python中Pandas库的pivot()函数,用于数据重塑。解析index、columns、values三大参数,提供完整代码示例及注意事项,如使用reset_index()处理结果,帮助开发者高效进行数据分析与表格转换。
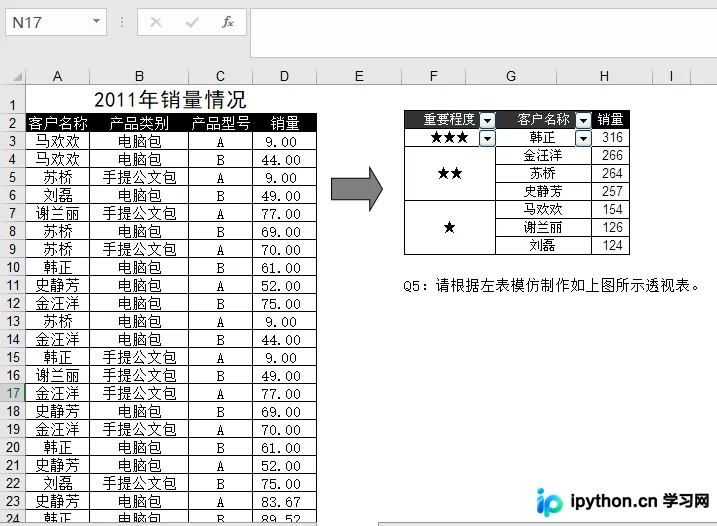
本文详解Python中利用pandas库实现Excel风格数据透视表的两种核心方法。通过pd.pivot_table()函数直接生成透视表,以及使用groupby结合agg进行分组聚合,对比两者的代码实现与适用场景。文章包含读取Excel、按客户名称汇总销量、排序、格式化处理及设置多级索引的完整代码示例,帮助开发者掌握更高效的数据处理技巧。
本文详细介绍如何使用Python读取xlsx文件。通过安装xlrd和pandas两个常用库,分别演示了基于工作表对象的数据提取方式以及DataFrame的高效读取方法。内容涵盖安装步骤、核心代码示例及行列操作技巧,帮助开发者快速掌握Excel数据处理技能。
本文介绍如何利用 pandas 的 read_csv 函数中的 chunksize 参数,实现对大型 CSV 文件的逐块读取与处理。通过示例代码演示了 TextParser 对象的迭代使用、Series 对象的 value_counts 统计以及 add 方法的累加合并技巧,有效解决内存溢出问题,适用于海量数据清洗与分析场景。
本文介绍在Pandas中交换DataFrame列顺序的两种常用方法。第一种通过获取列名列表,利用list的pop和insert方法调整顺序后,使用loc重新选取列;第二种直接通过赋值操作交换指定两列的值并更新列名。最后演示如何将调整后的数据保存回CSV文件,适用于数据清洗和特征工程场景。
本文介绍在Python Pandas库中如何计算两个Dataframe的交集与差集。通过pd.merge方法结合inner连接获取交集,支持指定列进行匹配。对于差集,演示了利用concat和drop_duplicates去除重复项的方法,分别计算df1-df2及df2-df1的结果,并提供另一种基于append和drop_duplicates的实现思路,帮助开发者高效处理数据差异。
本文介绍如何在Python3中使用Pandas库为Excel表格设置布局背景颜色。通过定义特定的格式对象(如bg_format),可以高亮显示关键数据或标题,提升表格可读性。文章提供了完整的代码示例,展示如何遍历Sheet页并应用背景色、字体及对齐方式等样式设置。
本文深入解析pandas中DataFrame赋值失败的常见场景,涵盖整列直接赋值、单值与多值非整列赋值以及跨列赋值的正确做法。重点阐述使用.loc进行条件赋值时因形状不匹配导致的报错原因,并提供通过.values.tolist()获取列表的正确实现方式,帮助开发者避免常见陷阱。
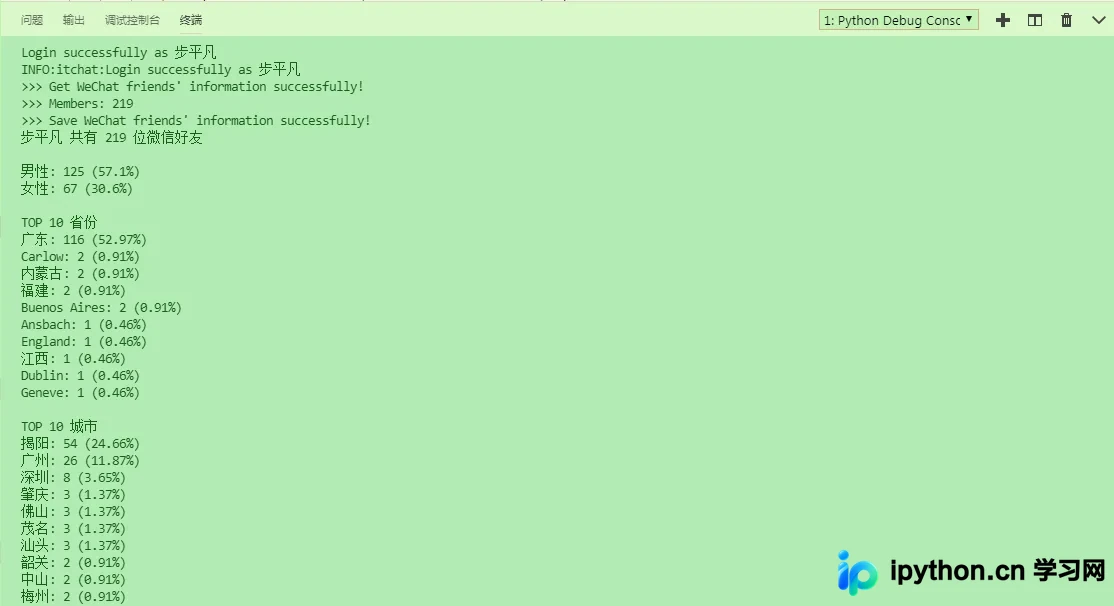
本文详细介绍如何利用Python对微信好友信息进行深度分析。通过wxpy库获取好友基础数据,结合openpyxl导出Excel,并利用pyecharts和wordcloud生成省份分布地图及城市词云。文章涵盖环境配置注意事项、核心代码实现及效果展示,帮助开发者快速掌握社交数据可视化的完整流程。
本文深入解析Pandas中map、apply和applymap三个核心函数的用法与区别。通过实际案例演示如何将Series或DataFrame中的数据批量映射到函数、字典或Series中,并对比传统遍历与list暂存方法的性能。实验表明,使用内置映射函数处理数据可提升500倍以上的速度,是高效数据清洗与转换的关键工具。