

Python数据分析之pandas比较操作
本文详细介绍Python中pandas库的比较操作,涵盖比较运算符与比较方法的使用场景。通过对比两个DataFrame、Series以及标量数据的比较方式,解析索引对齐、形状匹配及数据类型限制等关键细节,帮助开发者高效处理数据比对任务。
2026-10-14
6

本文详细介绍Python中pandas库的比较操作,涵盖比较运算符与比较方法的使用场景。通过对比两个DataFrame、Series以及标量数据的比较方式,解析索引对齐、形状匹配及数据类型限制等关键细节,帮助开发者高效处理数据比对任务。
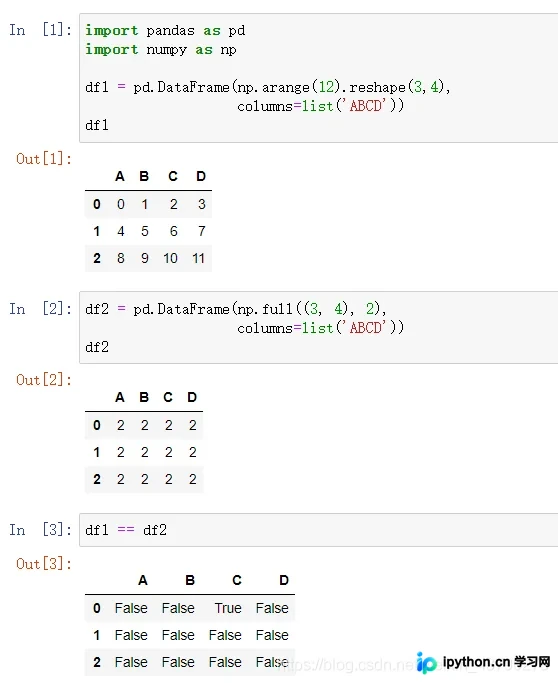
本文介绍在 Python 中读取 .txt 或 .md 格式文本文件的三种常用方式。通过 csv.reader 按行解析为列表,利用 numpy.loadtxt 转换为数值数组,以及使用 pandas.read_csv 直接生成 DataFrame。文章对比了各方法的输出格式与适用场景,并提供了完整的代码示例及注意事项,帮助开发者根据实际需求选择最高效的数据读取方案。
本文详解如何在Pandas中实现Hive的explode函数功能,用于处理员工销售记录统计。通过展开订单角色列表并去重,准确计算每位员工参与的不同订单数量,适用于复杂业务场景下的数据清洗与分析。
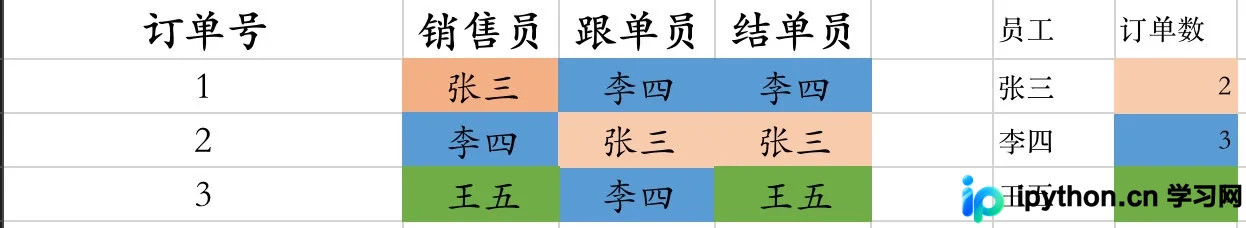
本文介绍在Python中使用pandas将数据中的NaN值转换为None的方法。通过df.where(df.notnull(), None)实现精准替换,解决接口接收数据时的类型兼容问题。同时补充了处理数据库读取后None转0.0时的常见误区,指出需区分NaN与None类型,并给出fillna的正确用法。
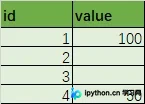
本文详细介绍Pandas库中pd.dropna()函数的用法,用于过滤DataFrame中的缺失数据(NaN)。文章解析了axis、how、thresh、subset和inplace等关键参数的具体含义,并通过多个代码示例演示了按行或列删除含空值数据、设定非空元素最低数量、指定子集判断以及原地修改等操作,帮助开发者高效进行数据清洗。
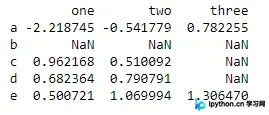
本文详解Pandas中缺失值的处理流程,涵盖np.nan、None及自定义缺失值的识别方法。深入解析isnull、dropna与fillna函数的核心参数(如axis、how、thresh、method),提供删除与填充缺失值的最佳实践及注意事项,帮助开发者高效完成数据清洗。
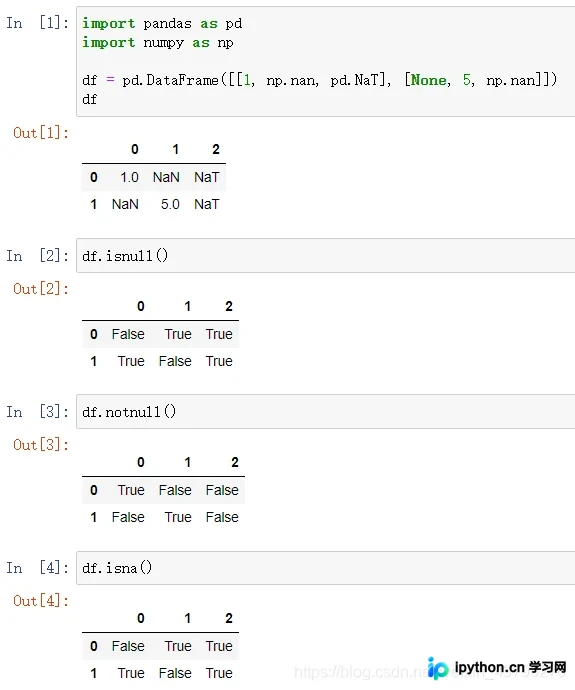
本文介绍如何使用Python实现自动化办公,通过os库遍历文件夹提取文件名,并结合pandas库读取Excel文件。程序将提取的文件名与Excel中的姓名列进行比对,若匹配则自动更新指定列的数值,适用于活动签到、时长统计等场景,有效减少人工核对工作量。
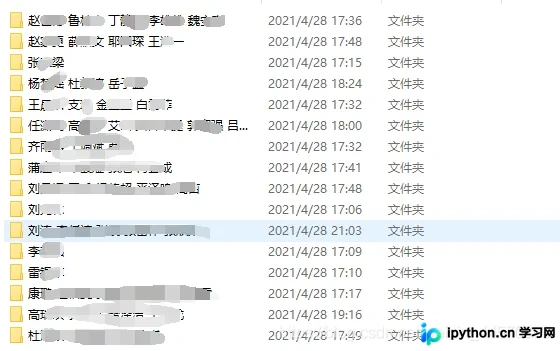
本文详解如何在Python中利用Pandas库高效读写MySQL数据库。通过结合pymysql和SQLAlchemy,实现从数据库读取数据生成DataFrame,以及将DataFrame写入数据库表的操作。包含完整的连接配置、查询及写入代码示例,适用于大数据处理场景。
本文详细介绍Python中Shapely与Geopandas模块在地理数据处理中的应用。通过Shapely处理Point、LineString及Polygon等几何对象,实现距离计算、轨迹插值与Douglas-Pucker算法简化;利用Geopandas进行世界地图绘制、海洋数据预处理及GeoHash编码,结合3-sigma算法处理异常值,提升地理数据爬取与分析效率。
本文深入解析Pandas中merge()函数的核心用法,涵盖inner、outer、left、right四种连接模式。详细讲解how、on、left_on、right_on、suffixes等关键参数的配置方法,并通过具体代码示例演示如何处理多列匹配、索引连接及重复列后缀处理,帮助开发者高效实现数据集合并。
本文详解Pandas中提取单个单元格值的两种方法。使用iloc返回DataFrame对象,而values属性返回嵌套列表。通过示例展示如何结合索引与values[0][0]获取纯数值,并解决将Series写入Excel时的类型报错问题,提供实用的代码参考。
本文介绍如何使用Python的Pandas库对CSV文件进行行列删除操作。通过read_csv读取数据,利用drop函数指定axis参数删除指定列或行,并设置inplace参数控制是否修改原数据。最后通过to_csv保存结果,支持指定编码和索引显示。