

Vaex:秒开100GB+数据集的Python高性能分析库
本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
2026-10-15
6

本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
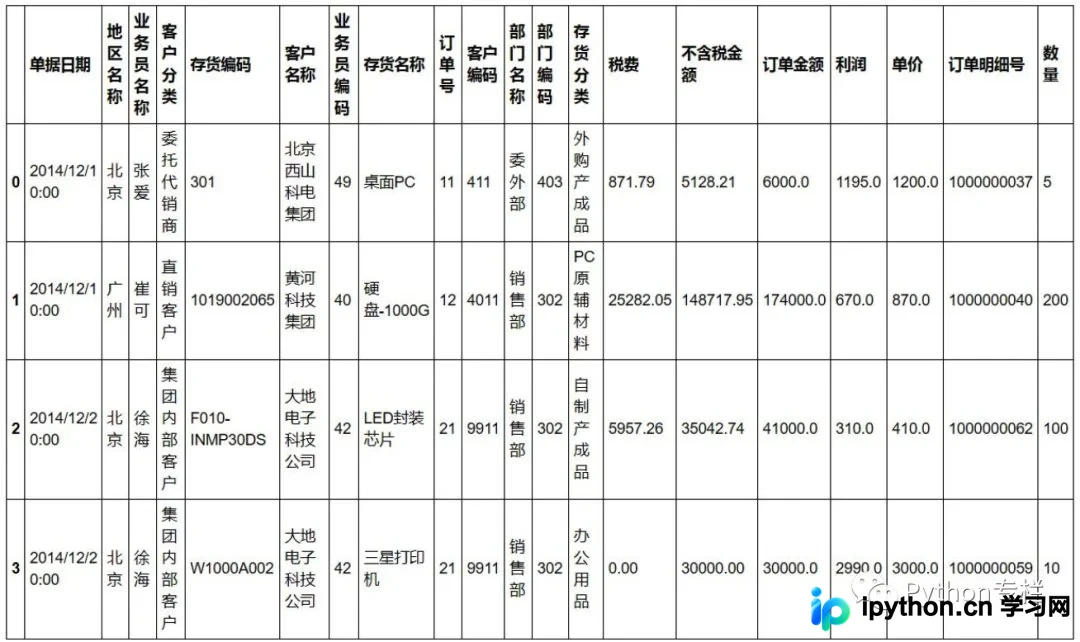
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
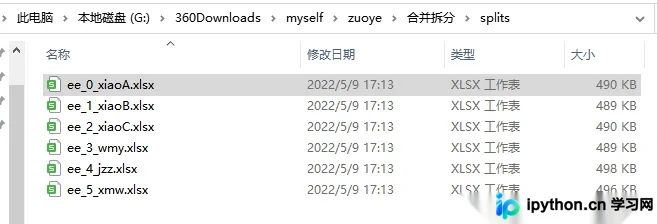
本文介绍如何利用Python Pandas库实现Excel文件的批量拆分与合并。首先演示如何将单个大型Excel按行数等分为多个子文件,并保存至指定目录;接着展示如何遍历文件夹读取多个小Excel,通过添加来源列并使用pd.concat进行合并,最终输出包含来源标记的完整大文件。
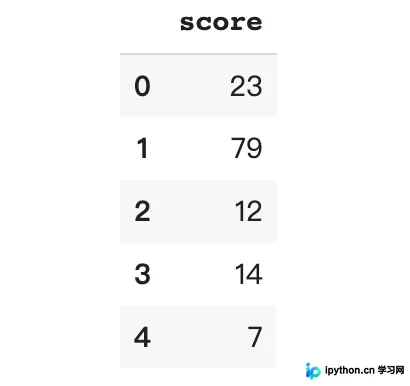
本文详细总结Pandas中对数值变量进行分箱(离散化)的四种常用方法。通过合成学生成绩数据,演示如何使用between结合loc、pd.cut、pd.qcut以及value_counts实现不同场景下的分箱需求,包括固定区间划分、等频分箱及基于统计量的分组,并对比各方法的参数设置与结果差异。
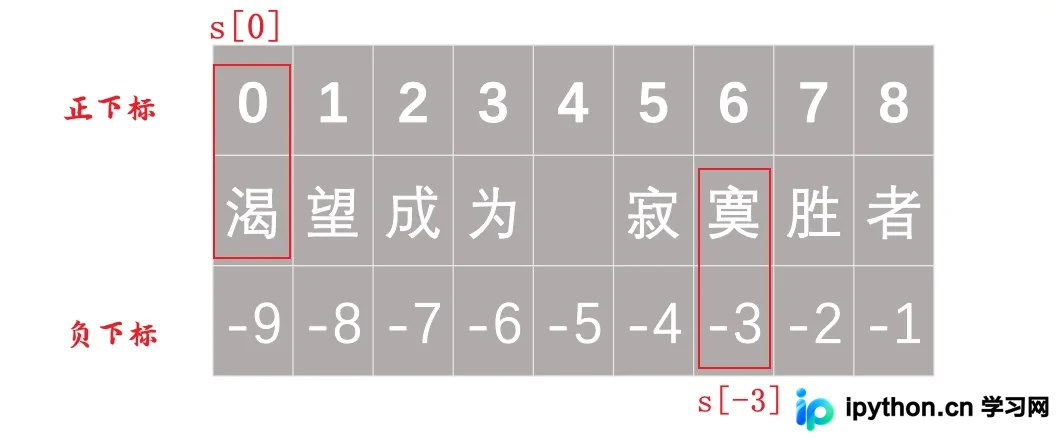
本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
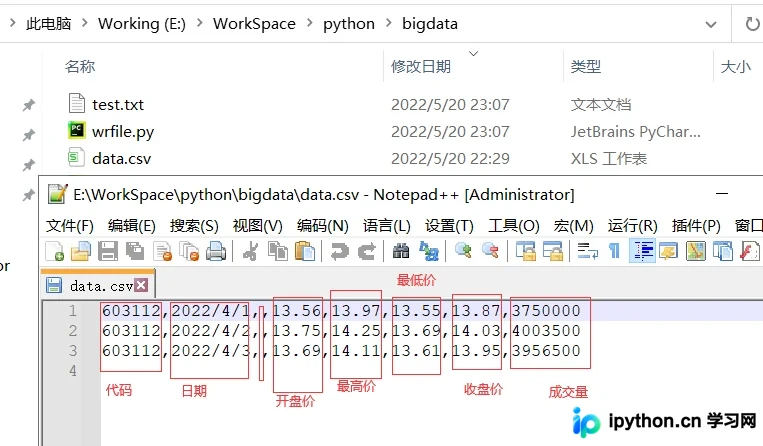
本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。
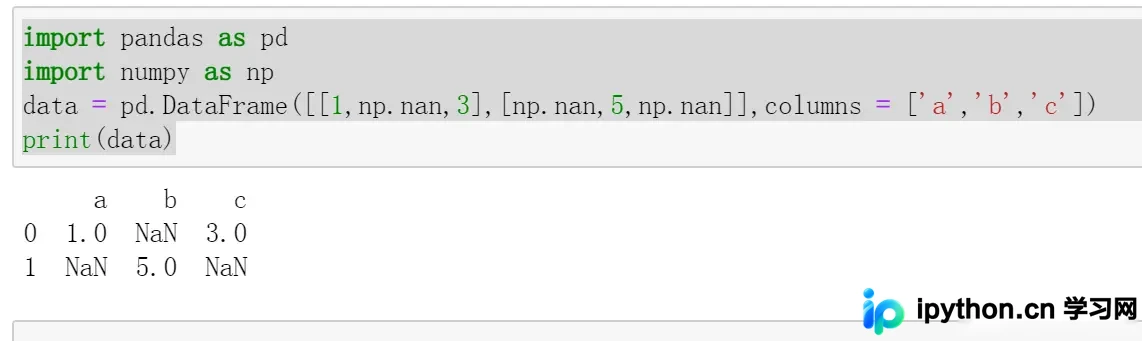
本文详解Python中处理缺失值的两种核心策略:删除与填充。通过演示isnull/isna检测空值,使用dropna按行或阈值删除含NaN数据,以及利用fillna结合均值进行数据补全,帮助开发者掌握Pandas中缺失值处理的关键函数与参数设置。
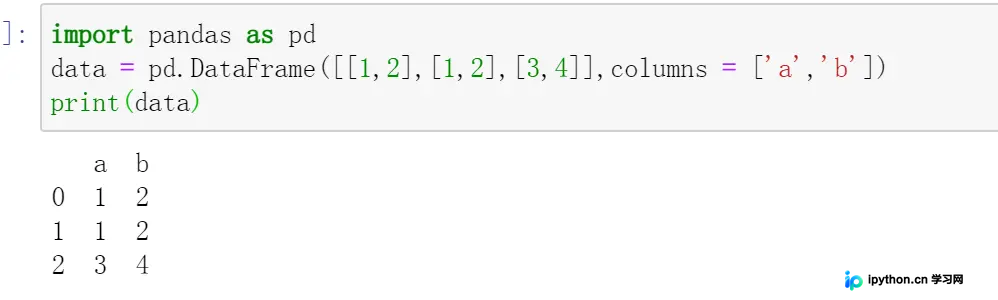
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。