

Vaex:秒开100GB+数据集的Python高性能分析库

本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
前言
面对50GB甚至500GB的庞大数据库,常规工具往往难以打开,更别提进行有效分析。
处理此类海量数据时,业界通常采用三种主流方案。
第一种方案是对数据进行抽样。其显著缺陷在于,抽样结果未必能准确代表整体数据分布。
第二种方案是部署分布式计算。尽管这在某些场景下有效,但集群的管理与维护成本极高。例如,仅为了处理30-50GB略超内存容量的数据而搭建集群,显然资源浪费严重。
第三种方案是租用高性能云服务,如AWS提供TB级内存实例。然而,这带来了云数据管理的复杂性,每次启动都需等待数据传输。此外,还需处理数据上云的合规性问题及远程工作的不便,且随着时间推移,费用会显著增加。
本文将介绍一种全新方法:一种更快速、安全且便捷的数据分析方案,支持处理几乎任意大小的数据,只要数据能存储于本地硬盘(笔记本、台式机或服务器)。
Vaex
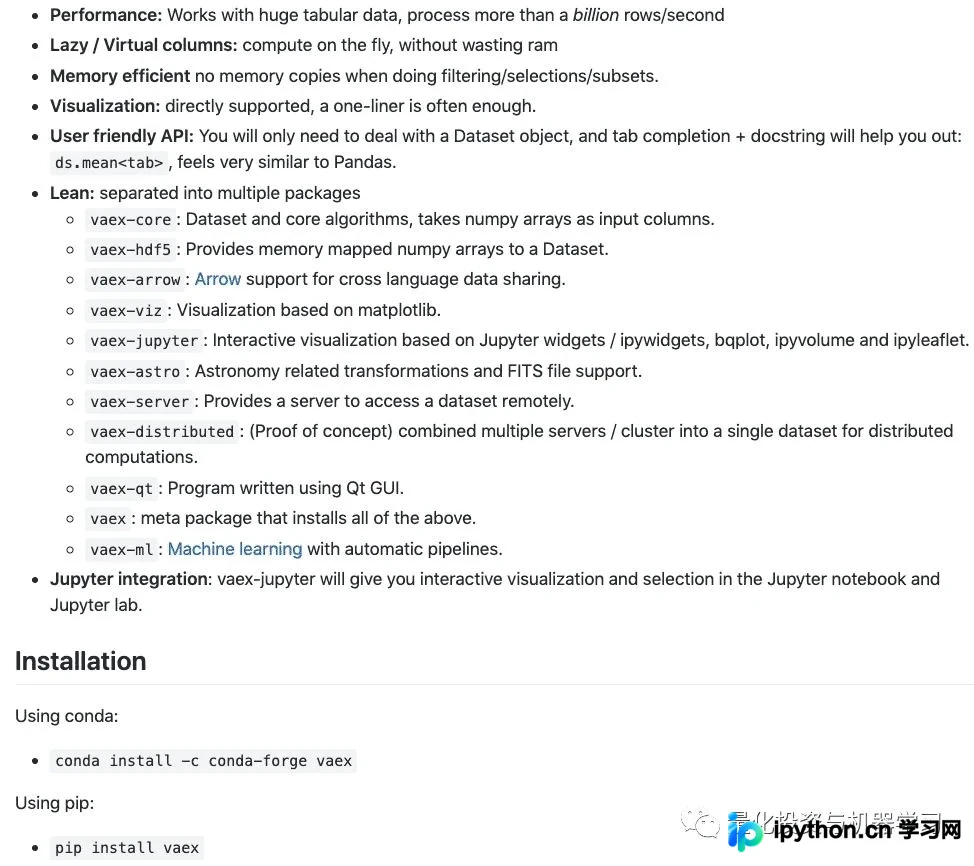
Vaex是一个开源DataFrame库,支持对与硬盘容量相当的表格数据进行可视化、探索、分析及机器学习。它能在n维网格上每秒计算超过10亿(10^9)个对象的平均值、总和、计数、标准差等统计量。可视化方面,支持直方图、密度图和3D立体渲染。Vaex通过内存映射、高效外核算法和延迟计算等机制实现最佳性能(不占用过多内存),并提供类似Pandas的API接口。
GitHub仓库:https://github.com/vaexio/vaex
为展示Vaex的性能,以下通过具体案例进行说明。
数据准备
我们采用纽约市出租车数据集,包含2009年至2015年间超过10亿次出行记录。数据可从以下网站下载,格式为CSV:
https://www1.nyc.gov/site/tlc/about/tlc-trip-record-data.page
数据清洗
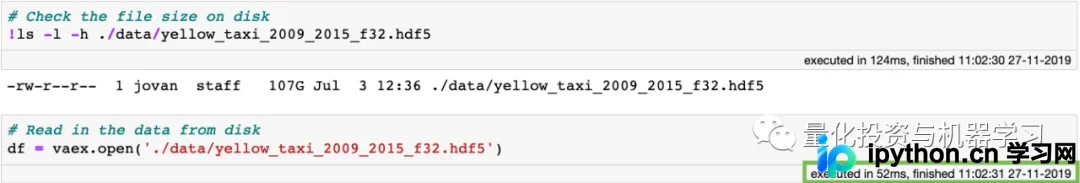
第一步是将数据转换为内存映射文件格式,如Apache Arrow、Apache Parquet或HDF5。一旦转换为内存映射格式,使用Vaex打开数据将是瞬间完成的(即使磁盘大小超过100GB)。具体耗时多少?
0.052秒!
将CSV数据转换为HDF5的代码如下:
为何如此迅速?
当使用Vaex打开内存映射文件时,实际上并未读取数据内容。Vaex仅读取文件元数据,包括磁盘上数据的位置、数据结构(行数、列数、列名和类型)及文件描述等。那么,若需检查或交互数据呢?打开数据集将返回一个标准DataFrame:
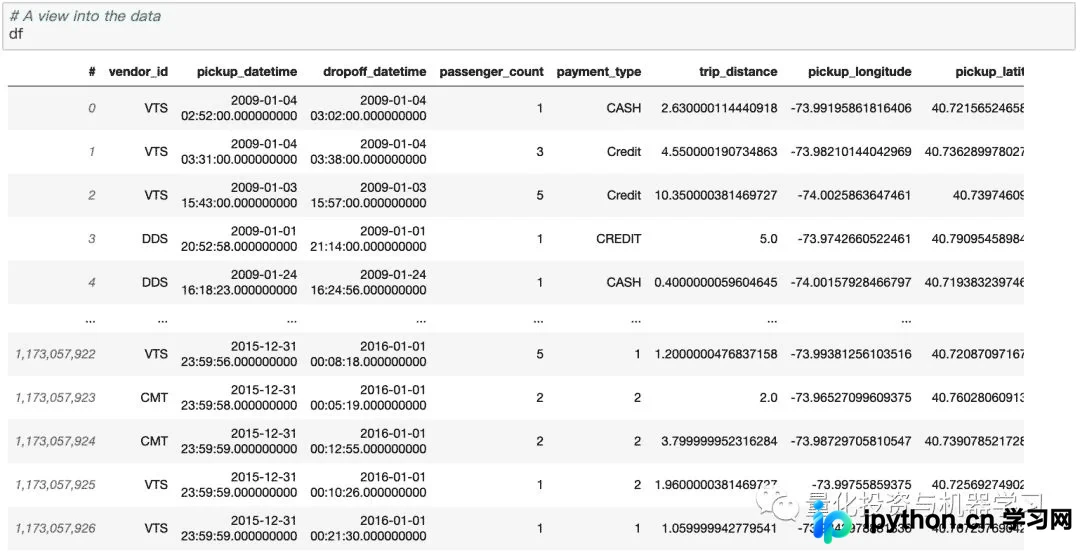
再次注意,单元格执行时间极短。这是因为显示Vaex DataFrame或列仅需从磁盘读取前5行和后5行。这引出一个关键问题:Vaex仅在必要时遍历整个数据集,且尽可能减少遍历次数。
现在开始清理数据集。通过describe方法获取数据概览是一个良好的开端:
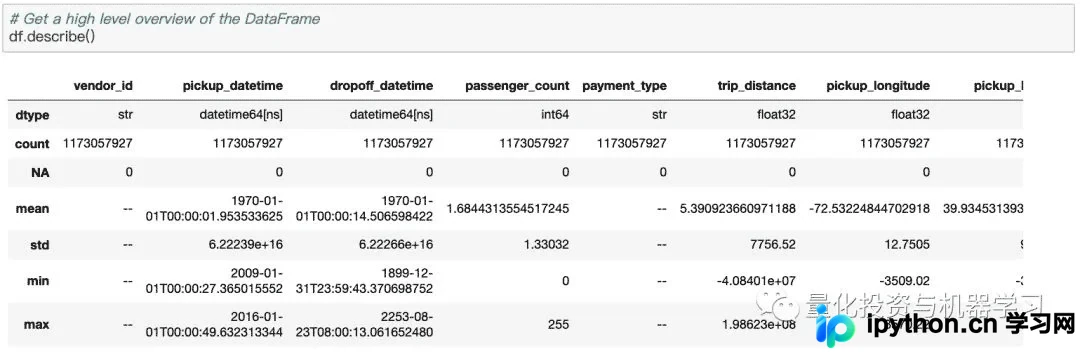
describe方法充分展示了Vaex的性能与效率:所有统计数据在MacBook Pro(15英寸,2018年,2.6GHz Intel Core i7,32GB RAM)上不到3分钟即计算完毕。其他库或方法需分布式计算或超过100GB云资源才能完成相同计算。使用Vaex,仅需数据及几GB内存的笔记本电脑即可。
观察describe输出,易发现数据存在严重异常值。鉴于数据集庞大,直方图是最有效的可视化方式。使用Vaex创建和显示柱状图及热图速度极快,且图表具有交互性!
df.plot_widget(df.pickup_longitude,
               df.pickup_latitude,
               shape=512,
               limits='minmax',
               f='log1p',
               colormap='plasma')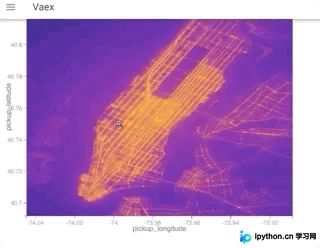
确定关注纽约特定区域后,可简单创建过滤后的DataFrame:
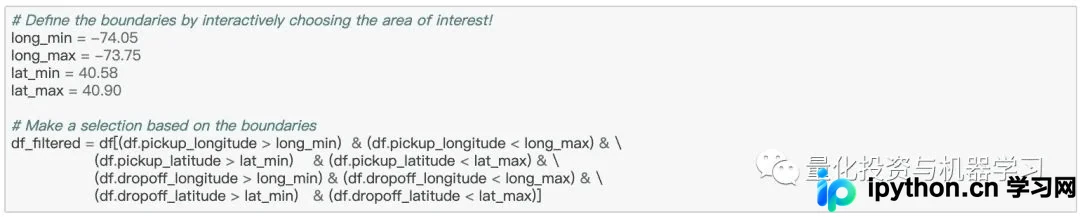
上述代码块的优势在于:所需内存可忽略不计!过滤Vaex DataFrame时,不会生成数据副本,而是创建对原始对象的引用并应用二进制掩码。掩码用于筛选显示哪些行及后续计算,从而节省100GB RAM(若复制数据则需如此,正如许多标准数据分析工具的做法)。
现在检查passenger_count列。单次出租车最高载客记录为255人,这似乎过于极端。让我们统计每位乘客的出行次数。使用value_counts方法可轻松实现:
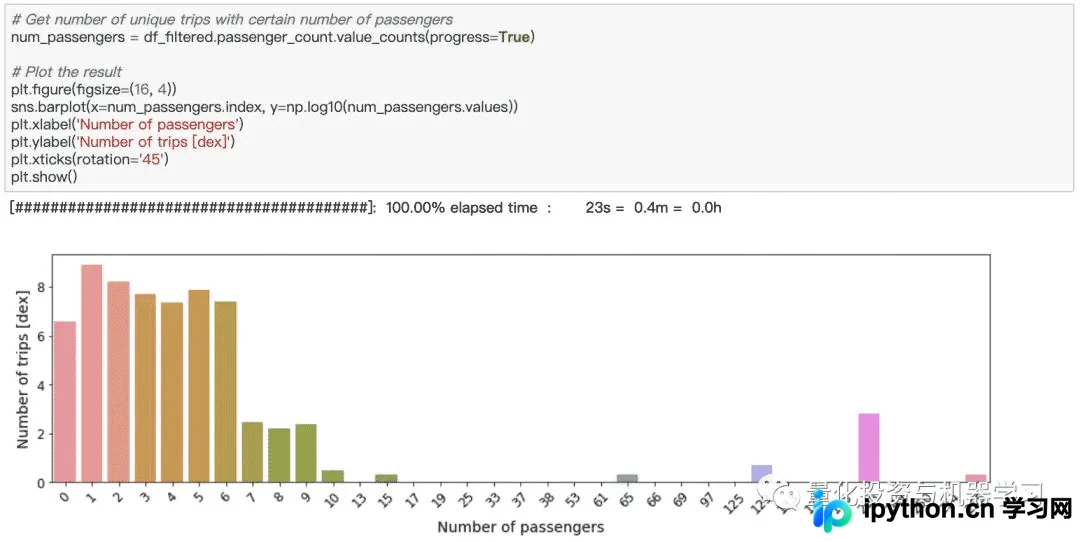
对10亿行应用“value_counts”方法仅需20秒!
从上图可见,乘客超过6人的出行可能是罕见异常值或数据录入错误。此外存在大量无乘客(0名)的行程。既然尚不知这些行程是否合法,让我们将其过滤掉。

对类似出行距离执行相同操作。由于这是连续变量,可绘制出行距离分布。观察最小和最大距离,使用更合理的范围绘制直方图。
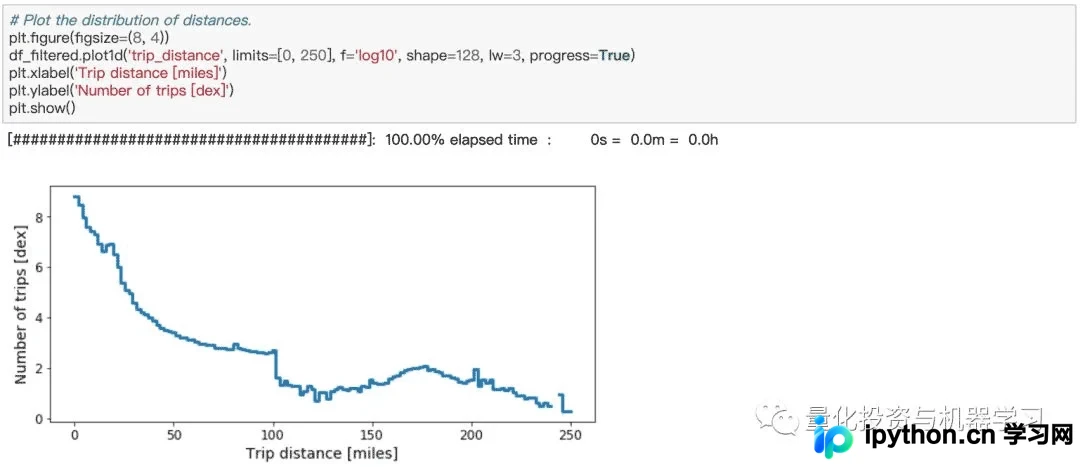
上图显示,出行次数随距离增加而减少。在约100英里处,分布显著下降。现以此作为分界点,消除基于行程距离的极端异常值:

出行距离列中存在的极端离群值是调查出租车出行时间和平均速度的原因。这些特征在数据集中不易直接获取,但计算简单:
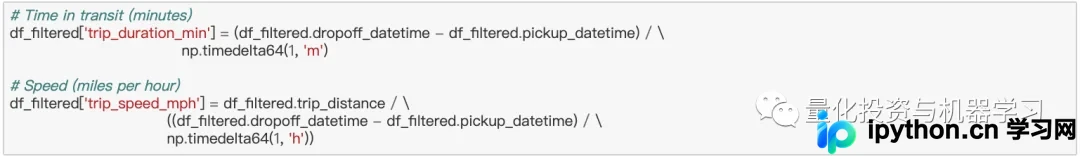
上述代码块需零内存,无需执行时间!因为代码创建的是虚拟列。这些列仅包含数学表达式,仅在需要时计算。否则,虚列行为与其他常规列相同。注意,其他标准库需10GB内存才能完成相同操作。
绘制行程时间分布:
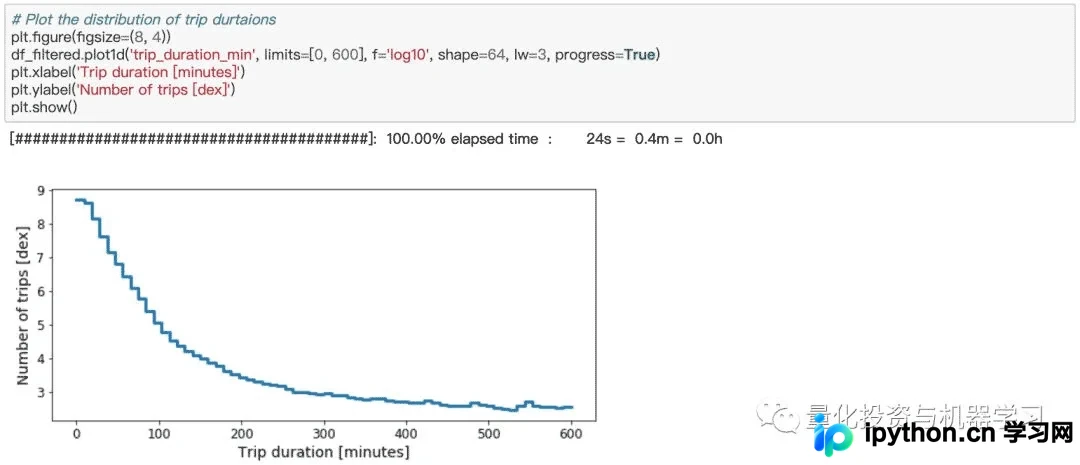
上图显示,95%的出租车行程耗时不到30分钟,尽管部分行程耗时4-5小时。你能想象在纽约被困出租车超过3小时的情景吗?考虑所有总时长不超过3小时的行程:

现在查看出租车平均速度,同时为数据限制选择合理范围:
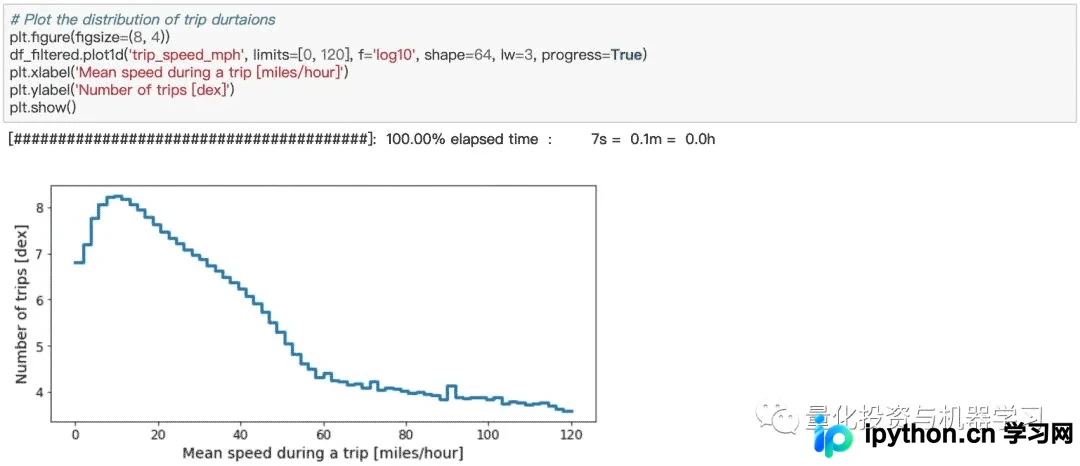
根据分布趋平处,可推断合理出租车平均速度在每小时1到60英里之间,因此可更新过滤后的DataFrame:

将焦点转移至出租车费用。从describe方法输出可见,fare_amount、total_amount和tip_amount列存在异常值。首先,这些列的值不应为负。让我们查看这些数据在相对合理范围内的分布:
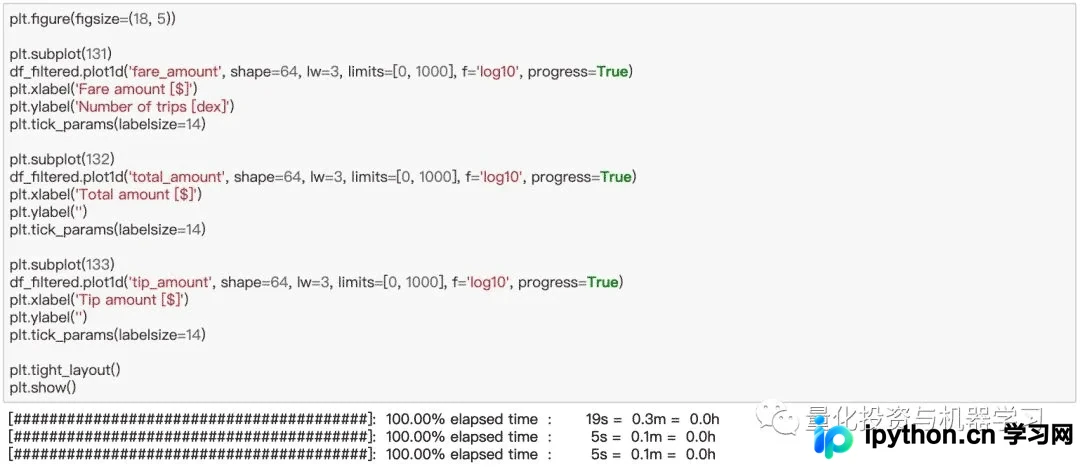
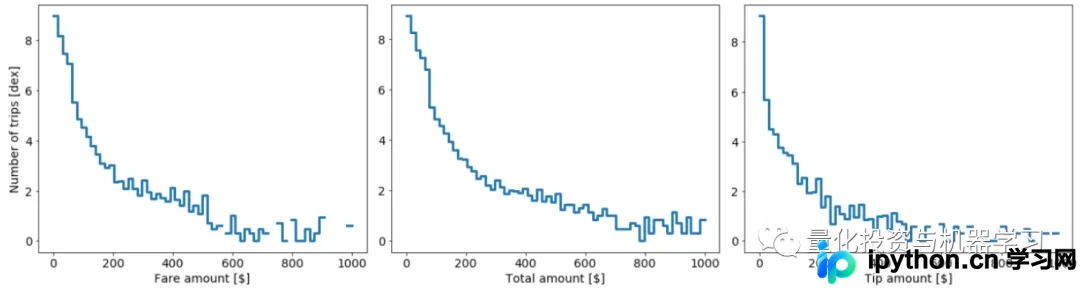
上述三个分布均有较长尾部。部分尾部值可能正确,其他可能是错误数据。无论如何,现保守起见,仅考虑票价fare_amount、total_amount和tip_amount低于200美元的乘客。同时要求fare_amount、total_amount的值大于0。

最后,在所有初始数据清理后,查看剩余供分析的出租车次数:

超过11亿次出行!
具体分析
假设使用此数据集学习如何最大化利润、最小化成本。
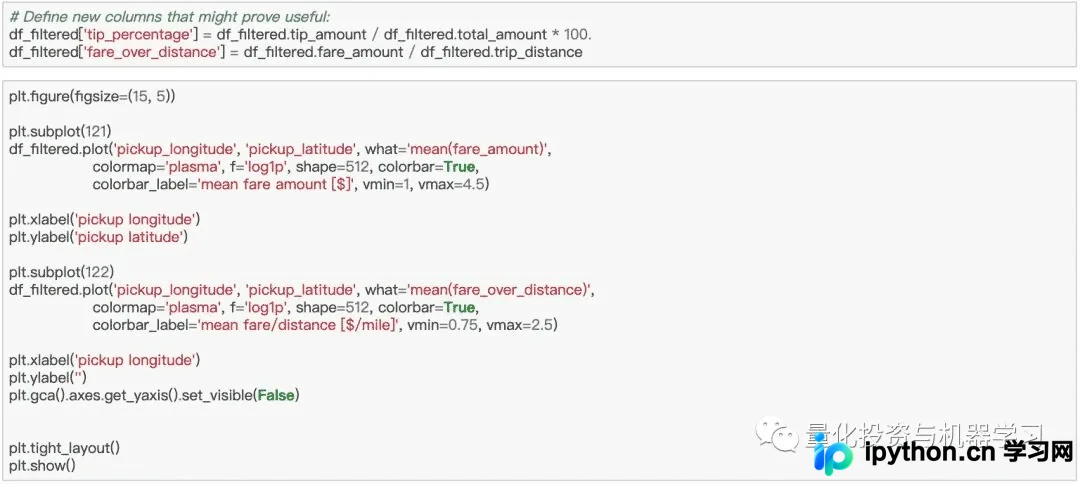
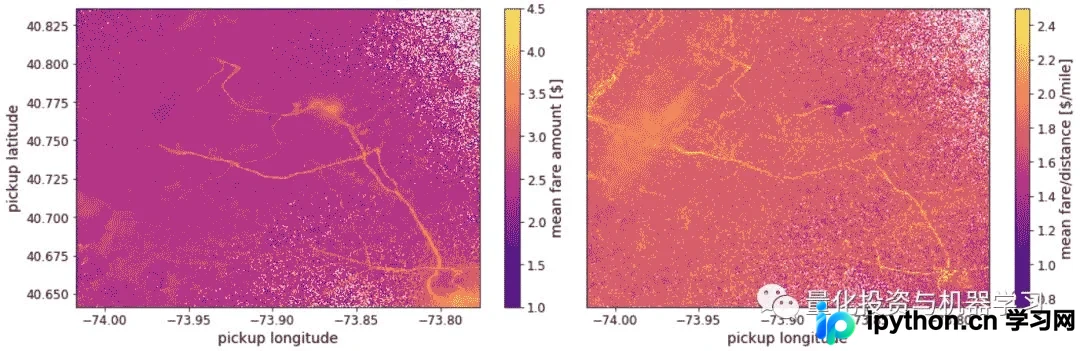
首先找出从平均值而言能带来较好收入的载客地点。只需绘制一张热点地区接送地点的热图,对平均票价进行颜色编码,然后查看热点区域。然而,出租车司机也有成本,如燃油费。因此,将乘客送至远处可能导致更高票价,但也意味着更大的燃油消耗和时间损失。此外,从偏远地方载乘客去市中心可能较难,空车返回可能成本高昂。一种解释方法是,用票价金额与出行距离之比的平均值来表示热图颜色。让我们考虑这两种方法:
出租车工作相对灵活。除知道去哪里外,若能让司机知晓何时开车最赚钱则更有帮助。为回答此问题,制作图表显示每天和每小时的平均票价与行程比率:
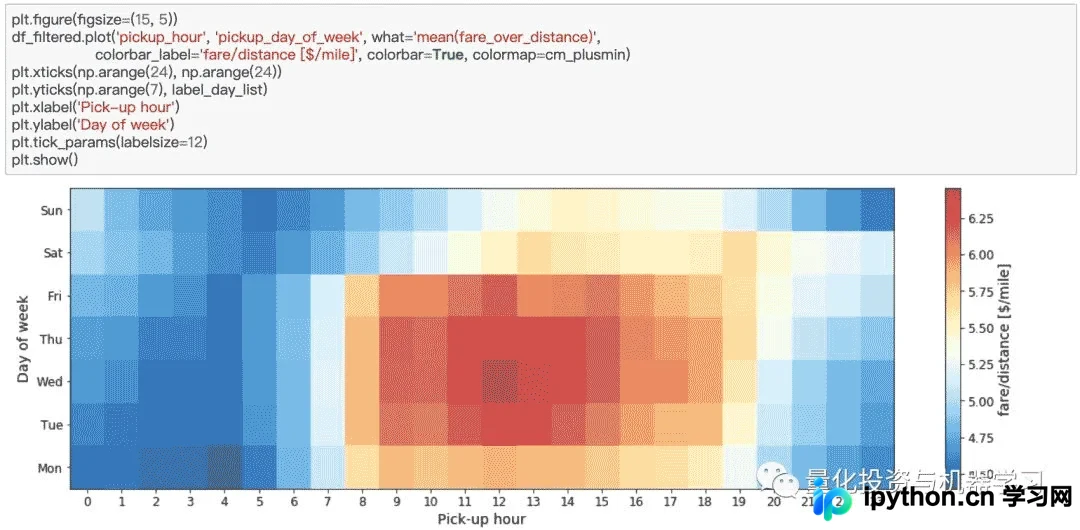
上述数字合理,最佳收入发生在高峰时段,特别是工作日中午。作为出租车司机,部分收入需交给出租车公司,因此可能对哪一天、哪段时间顾客给的小费最多感兴趣。制作类似图表,显示平均小费比例:
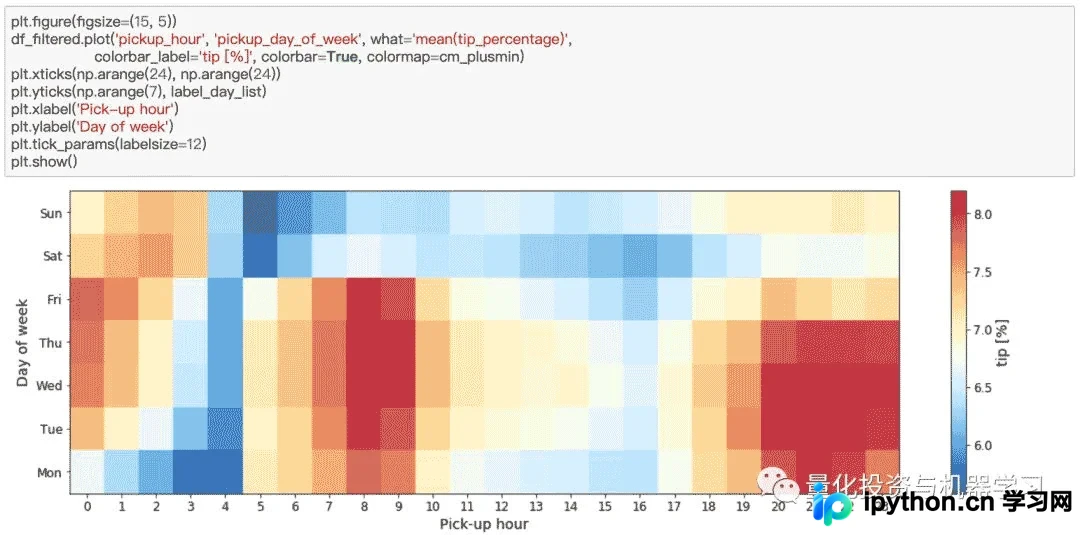
上述结论有趣。它表明,乘客在早上7点到10点之间给出租车司机的小费最多,若在凌晨3点或4点接乘客,不要期望有大额小费。
更深入的分析
在本文前一部分中,我们简要集中讨论了trip_distance列。在去除异常值时,保留了所有值小于100英里的行程。但这仍是较大临界值,尤其考虑到Yellow Taxi公司主要在曼哈顿运营。trip_distance列描述出租车从上客点到下客点的距离。然而,人们常可选择不同路线,在两个确切的上落地点间有不同距离,例如为避免交通堵塞或道路工程。因此,作为trip_distance列的对应项,让我们计算接送位置间可能的最短距离,称之为arc_distance:
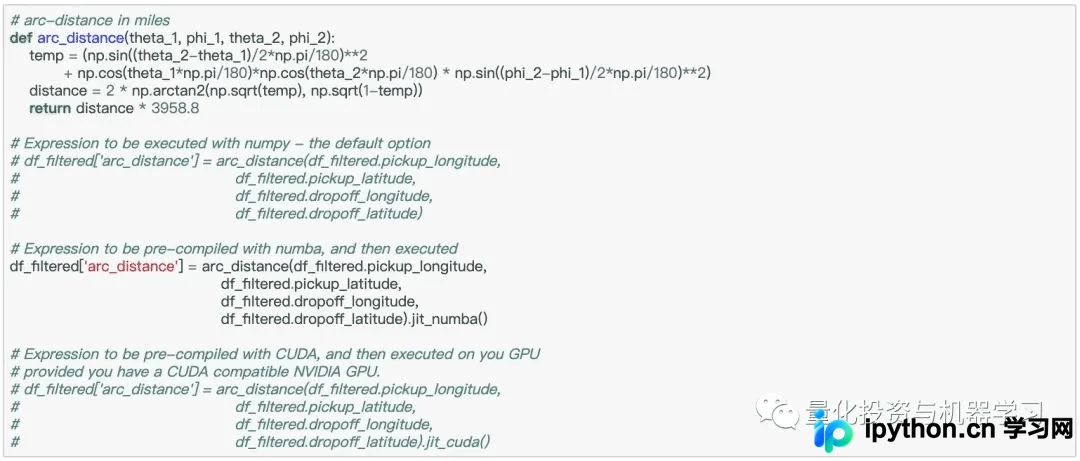
对于用Numpy编写的复杂表达式,vaex可在Numba、Pythran甚至CUDA(若有NVIDIA GPU)帮助下使用即时编译极大提高计算速度。
arc_distance计算公式复杂,包含大量三角函数和算术知识,尤其在处理大数据集时计算量大。若表达式或函数仅使用来自Numpy包的Python操作和方法编写,Vaex将利用计算机所有核心并行计算。此外,Vaex通过Numba(使用LLVM)或Pythran(通过C++加速)支持即时编译,提供更好性能。若有NVIDIA显卡,可通过jit_cuda方法使用CUDA获得更快性能。
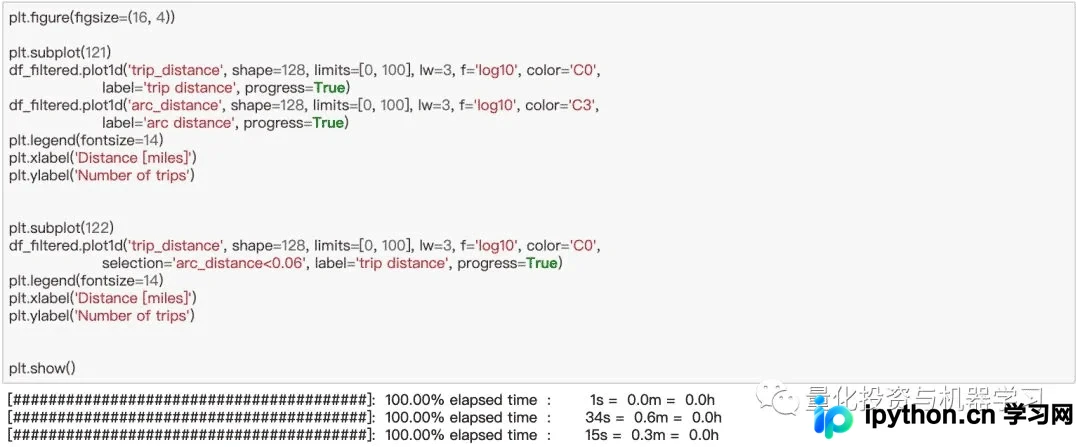
无论如何,绘制trip_distance和arc_distance的分布:
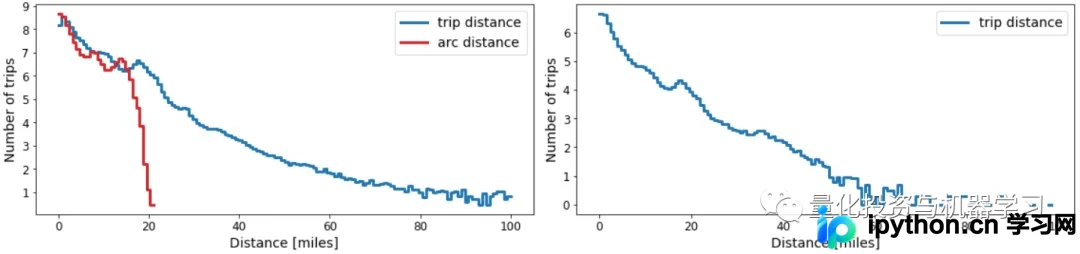
有趣的是,arc_distance从未超过21英里,但出租车实际行驶距离可能是其5倍。事实上,在数百万次出租车行程中,落客点距离接客点仅100米(0.06英里)。
本次试用数据集跨越7年。观察这段时间人们对某些事物兴趣的演变可能有趣。使用Vaex,可进行out-of-core group-by和aggregation操作。让我们查看这7年中票价和旅行距离的变化:
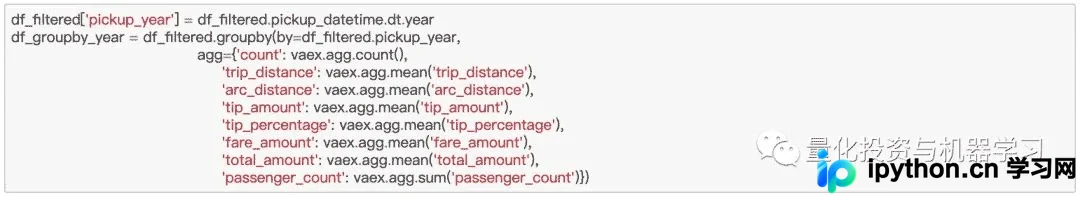
在拥有四核处理器的笔记本电脑上,对包含超过10亿个样本的Vaex DataFrame进行8个聚合的分组操作仅需不到2分钟。
在上述单元格中,执行groupby操作及8个聚合,其中2个位于虚拟列上。上述单元格在笔记本电脑上执行不到2分钟。考虑到数据包含超过10亿个样本,这相当令人印象深刻。不管怎样,查看结果。以下是多年来乘坐出租车的费用演变:
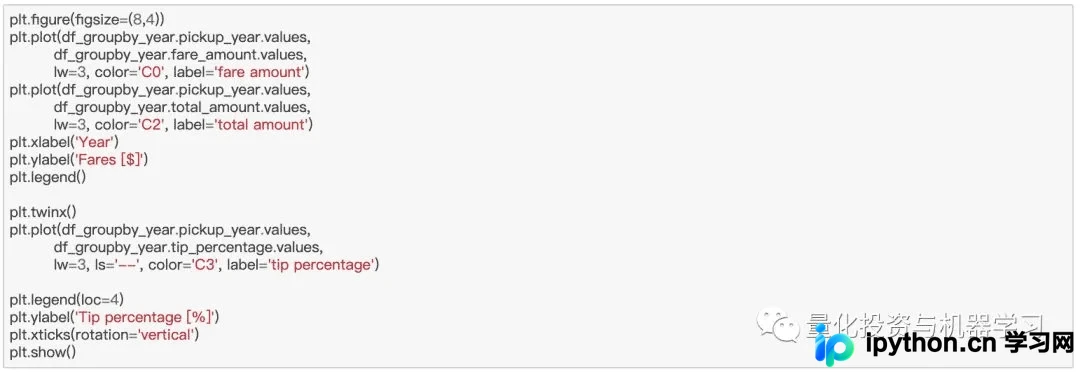
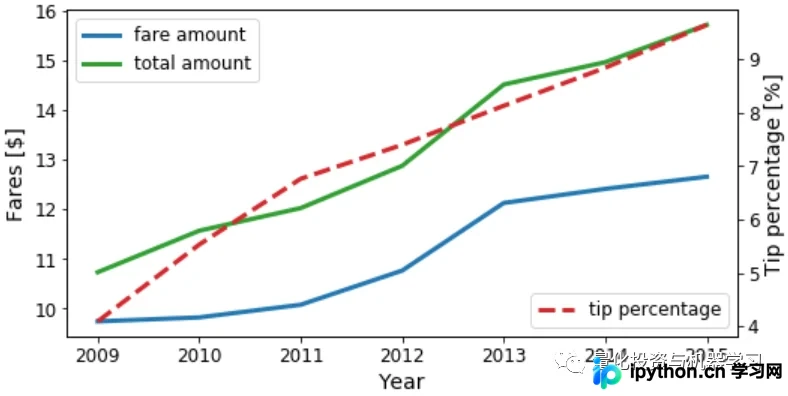
可见,随时间推移,出租车费和小费均在上涨。现在查看出租车的trip_distance和arc_distance作为年的函数:
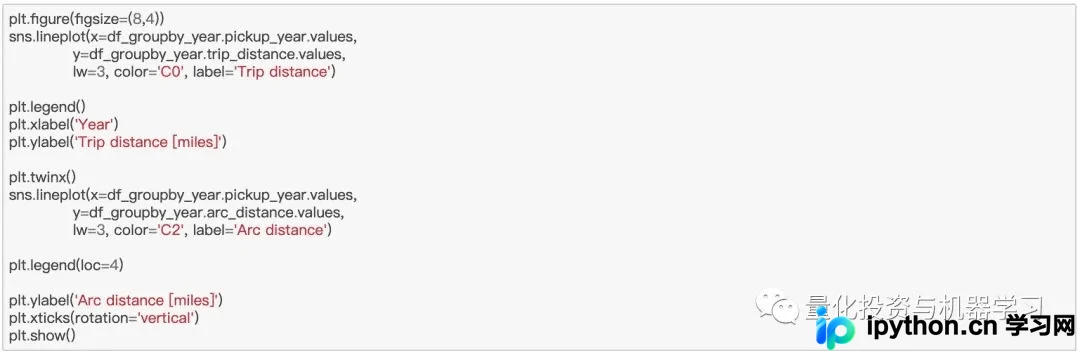
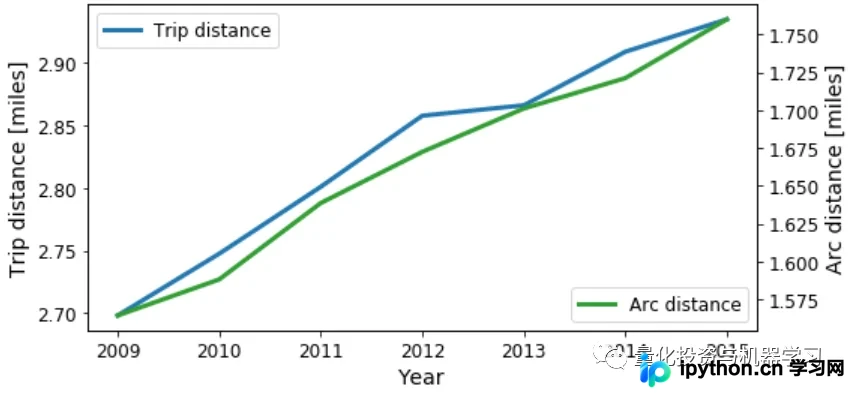
上图显示,trip_distance和arc_distance均有小幅增长,意味着平均而言,人们倾向于每年走得更远一点。
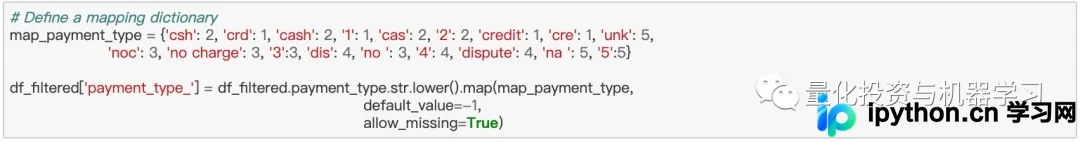
再调查一下乘客如何支付车费:payment_type列,查看其包含的值:
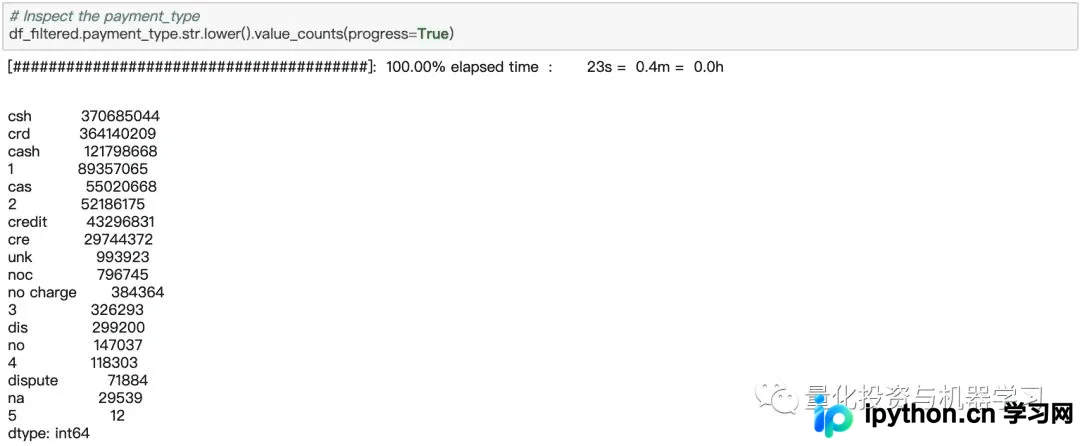
从数据集中,可见仅有6个有效条目:
- 1=信用卡支付
- 2=现金支付
- 3=不收费
- 4=纠纷
- 5=未知
- 6=无效行程
因此,可将payment_type列中的条目简单映射到整数:
现在可根据每年数据进行分组,查看纽约人支付打车费用习惯的变化:
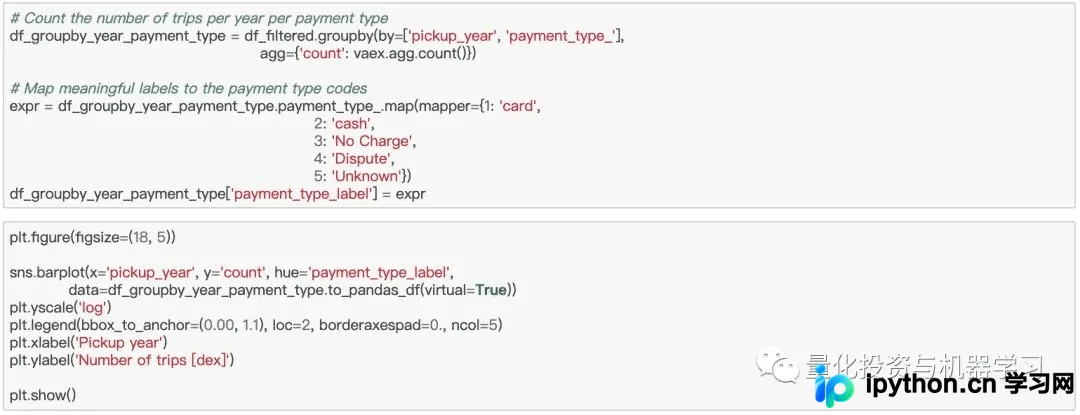
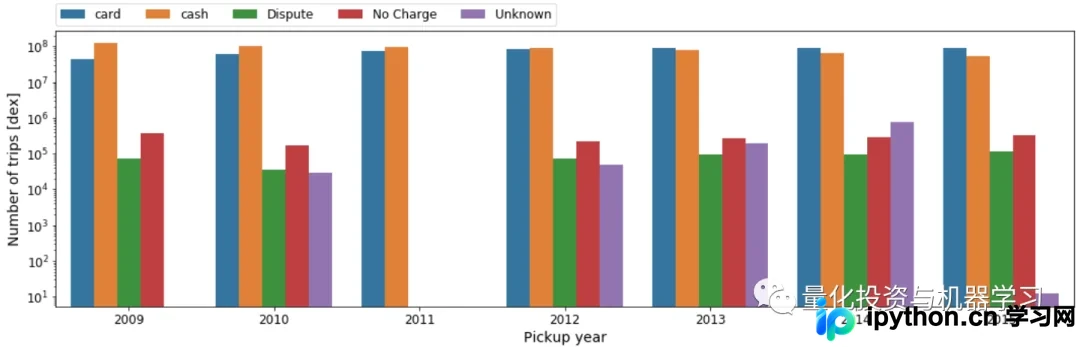
我们发现,随时间推移,信用卡支付逐渐比现金支付更频繁。在上述代码块中,一旦聚合数据,小型Vaex DataFrame可轻松转换为Pandas DataFrame,传递给Seaborn。
最后,通过绘制现金支付与信用卡支付之间的比率,查看付款方式是否取决于当天时间或星期几。为此,首先创建过滤器,仅选择用现金或信用卡支付的行程。下一步是具有Vaex特色功能的操作:带有选择的聚合。其他库要求对每个支付方法分别聚合,然后将这些支付方法后来合并为一个。另一方面,我们可通过在聚合函数中提供的参数,一步完成此操作。这非常方便,只需传递一次数据,即可获得更好性能。然后,可用标准方式绘制最终DataFrame:
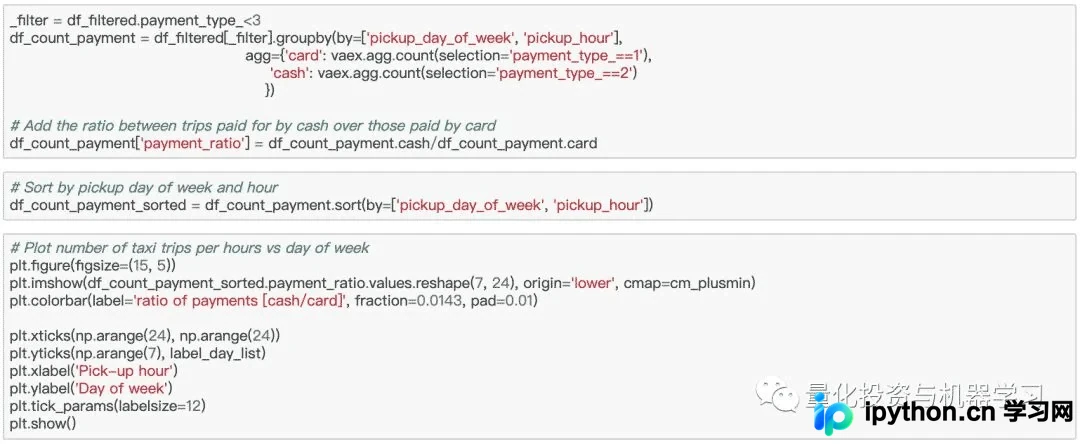
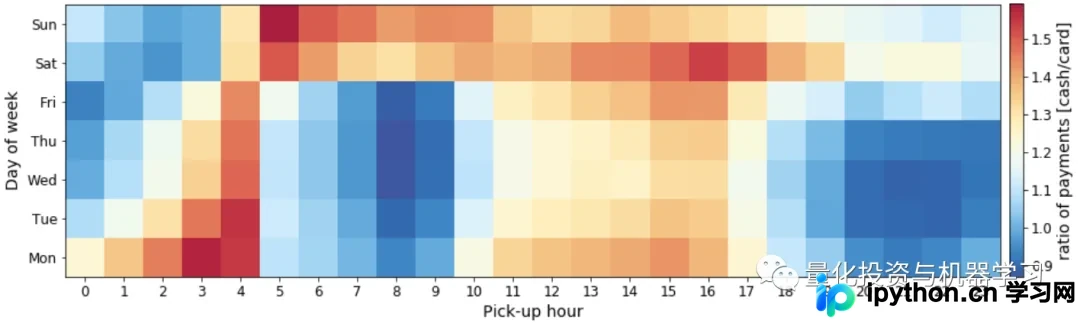
上图显示,小费百分比可作为一周某天或一天某时段的函数。从这两个图表明,用信用卡支付的乘客比用现金支付的乘客更倾向于给小费。查看分布:
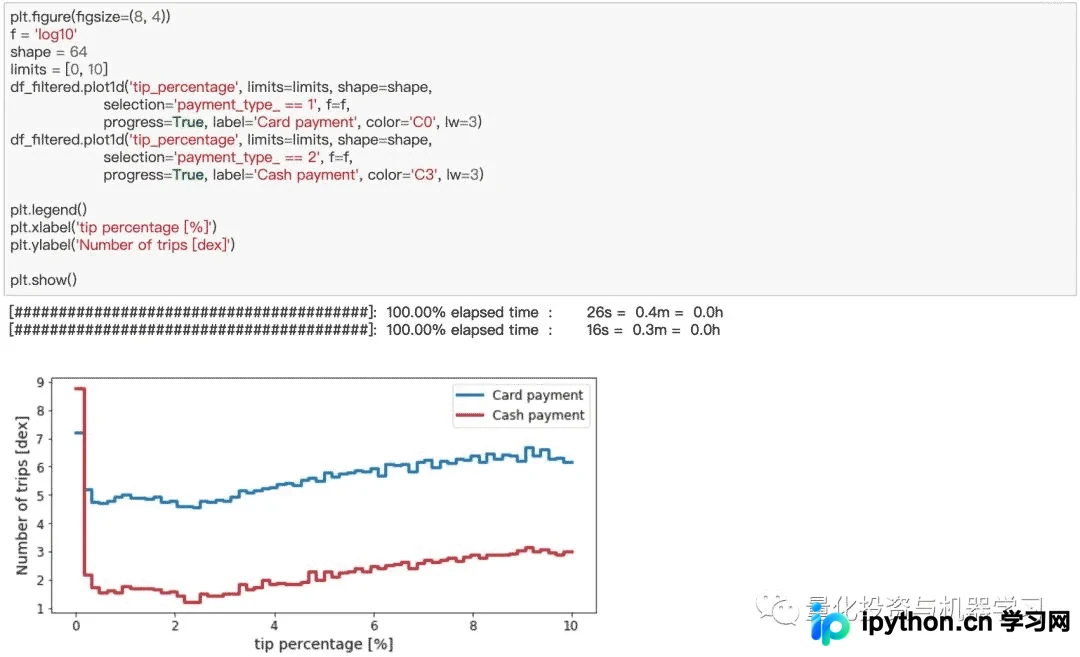
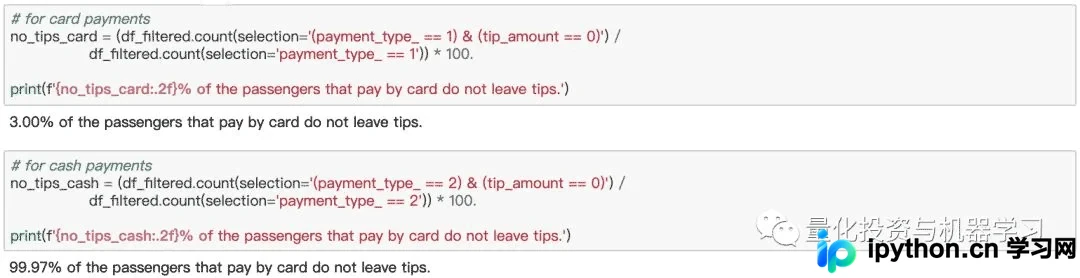
乘客多久付一次小费?
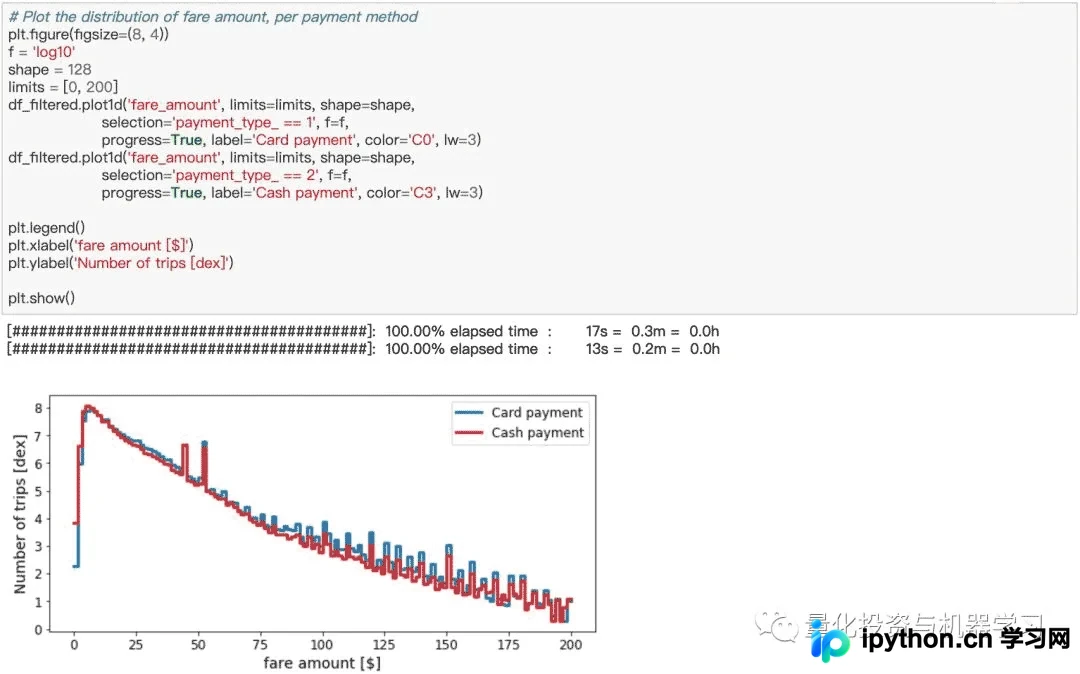
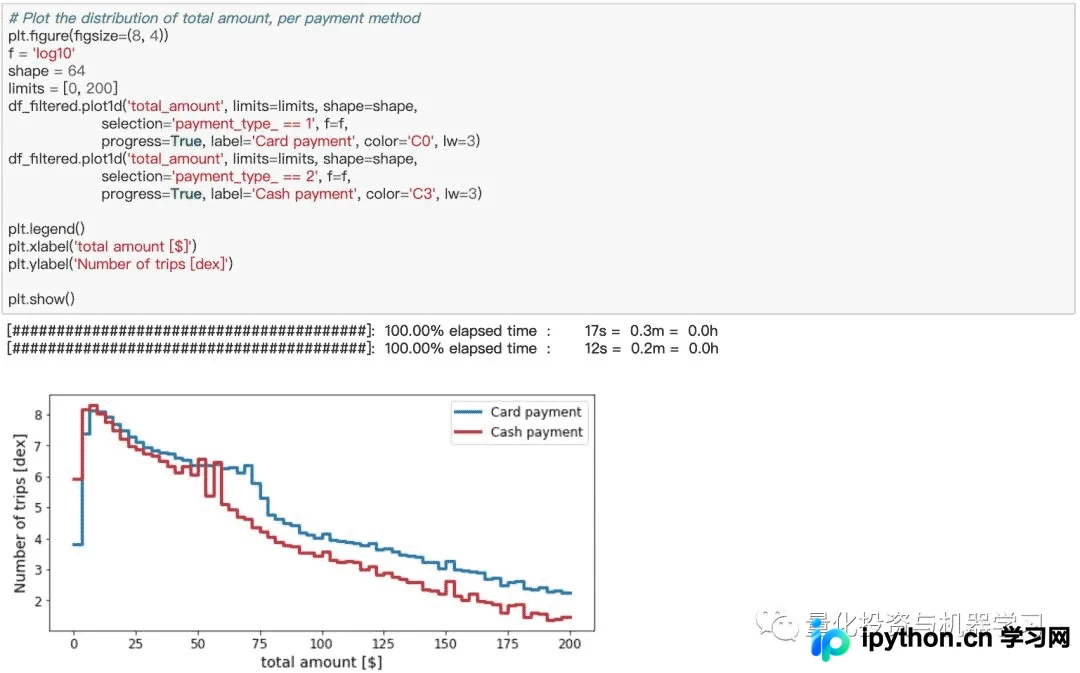
但让我们查看_fareamount和_totalamount的分布,这取决于支付方式是刷卡还是现金。
结论
使用Vaex,可在短短几秒钟内浏览超过10亿行数据,计算各种统计数据、聚合信息,并生成信息图表,且这一切均在你自己的笔记本电脑上完成。而且它是免费和开源的!
以上就是Python数据集库Vaex秒开100GB加数据的详细内容,更多关于Python库Vaex秒开100GB数据的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









