R语言统计检验方法汇总与实战
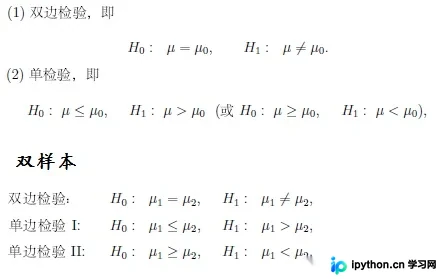
本文系统梳理R语言中常用的数据检验方法,包括正态性检验(W检验、K检验)、相关性检验(Pearson、Spearman)、均值与方差的t检验,以及卡方、Fisher和Wilcoxon等非参数检验。提供各检验的适用场景、R函数调用方式及P值解读,帮助读者快速掌握数据分析中的核心检验逻辑。
2026-10-16
8

本文系统梳理R语言中常用的数据检验方法,包括正态性检验(W检验、K检验)、相关性检验(Pearson、Spearman)、均值与方差的t检验,以及卡方、Fisher和Wilcoxon等非参数检验。提供各检验的适用场景、R函数调用方式及P值解读,帮助读者快速掌握数据分析中的核心检验逻辑。
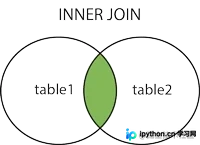
本文详细解析MySQL中的表联结与集合操作。涵盖CROSS、INNER及LEFT/RIGHT OUTER JOIN的原理与示例,讲解UNION与UNION ALL合并结果集的规则与差异,通过具体SQL代码演示如何在开发中正确应用这些核心查询语法以获取精准数据。
本文详解Python与Matlab数据互通技巧,重点介绍SciPy库中scipy.io模块的savemat函数用法。同时系统梳理SciPy核心子模块,包括integrate数值积分、optimize优化器、interpolate插值及linalg线性代数模块,提供具体代码示例与参数说明,助力Python科学计算与数据分析。
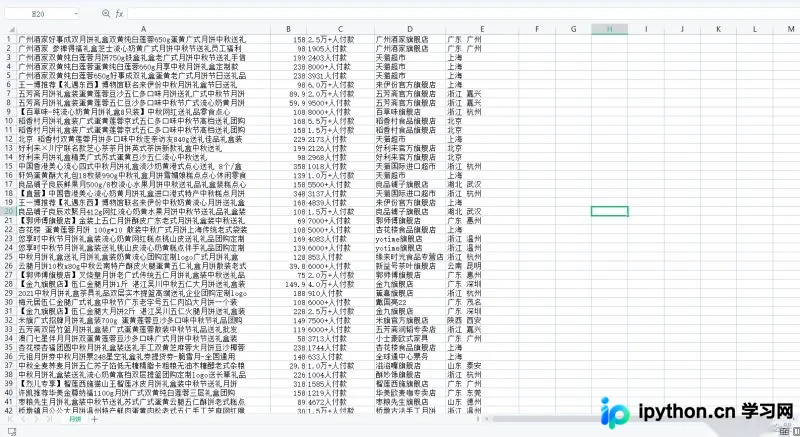
本文介绍如何使用Python对月饼电商数据进行清洗与可视化分析。通过Pandas处理价格、销量及店铺信息,利用Pyecharts生成销量Top10店铺与商品柱状图、不同价格区间销量占比饼图以及各省销量分布地图,帮助直观了解市场趋势与热门产品。
本文详细介绍Pandas中pd.concat函数的用法,涵盖纵向与横向数据连接、关键参数如axis和join的配置,以及处理Series与DataFrame混合连接的示例。通过具体代码演示如何高效合并数据集,适用于数据清洗与分析场景。
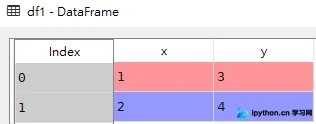
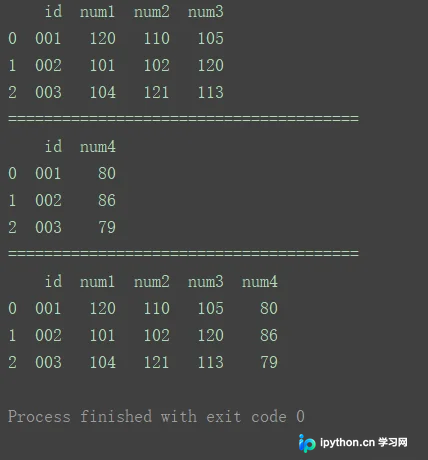
本文详细解析Python中Pandas库的数据合并方法。重点讲解merge()函数的inner、outer、left、right四种连接方式及多对一、多对多场景,并对比concat()在纵向堆叠与横向对齐时的参数配置,通过代码示例展示索引、键值处理及keys标记技巧。
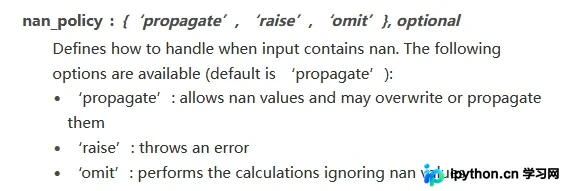
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
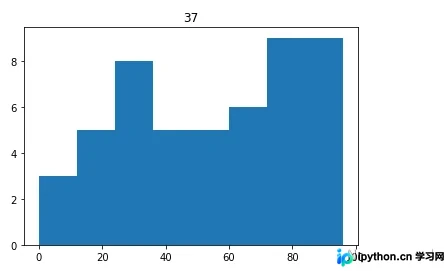
本文介绍Python数据分析中常用的Matplotlib可视化库。通过具体代码示例,详细讲解直方图、堆叠图、饼图、散点图、箱线图及雷达图等多种图表的绘制方法。内容涵盖参数设置、中文显示处理及数据呈现技巧,帮助读者快速掌握数据可视化基础技能。
本文介绍了在 Python 的 Pandas 库中为 DataFrame 添加列名的两种常用方法。第一种是在创建 DataFrame 时通过 columns 参数直接指定;第二种是先创建无列名的 DataFrame,再使用 columns 属性进行赋值。文章提供了具体的代码示例和运行结果,帮助开发者快速掌握相关操作技巧。
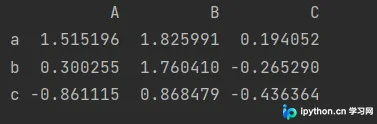
本文详解 Python Pandas 中时间序列数据的处理流程。涵盖 time 模块基础操作、DatetimeIndex 的创建与索引技巧,以及如何利用 pd.to_datetime 清洗日期数据。通过杭州天气数据集实例,演示如何按月份聚合统计并绘制温度变化趋势图,帮助开发者掌握时序数据分析的核心技能。
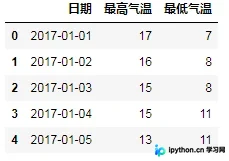
本文介绍在Pandas DataFrame计算中产生inf(无穷大)值的原因及处理方法。通过Numpy库提供的isinf、isposinf等函数定位inf位置,并演示如何将Series或整个DataFrame中的正负无穷大替换为指定数值或NaN,以适配机器学习算法对数据完整性的要求。
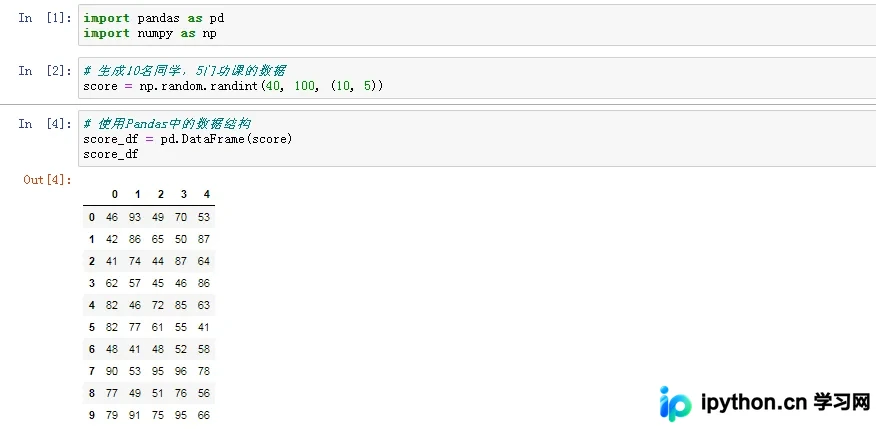
本文详细解析Python Pandas库中的核心数据结构,包括一维的Series和二维的DataFrame。内容涵盖两者的创建方法、关键属性(如index、values、shape)以及索引设置与重置技巧,帮助开发者掌握高效的数据处理基础。