

Python Pandas数据结构详解:Series与DataFrame核心用法

本文详细解析Python Pandas库中的核心数据结构,包括一维的Series和二维的DataFrame。内容涵盖两者的创建方法、关键属性(如index、values、shape)以及索引设置与重置技巧,帮助开发者掌握高效的数据处理基础。
1 Pandas介绍
该库由Wes McKinney于2008年开发。
它是一个专为数据挖掘设计的开源Python库。
Pandas以Numpy为基础,充分利用了Numpy在计算性能方面的优势。
同时基于matplotlib,提供了简便的绘图功能。
其核心优势在于拥有独特的数据结构。
虽然Numpy能处理数据并结合matplotlib展示部分结果,但Pandas的学习价值何在?
- 提升图表的可读性。
- 提供便捷的数据处理能力。
- 支持方便的读取文件操作。
- 封装了Matplotlib和Numpy的绘图与计算功能。
2 Pandas数据结构
Pandas主要包含三种数据结构:Series、DataFrame以及MultiIndex(在旧版本中称为Panel)。
其中,Series是一维数据结构,DataFrame是二维表格型数据结构,而MultiIndex则是三维数据结构。
2.1 Series
Series是一种类似于一维数组的数据结构,能够存储任意类型的数据,例如整数、字符串或浮点数。它主要由两部分组成:一组数据以及与之关联的索引。
2.1.1 Series的创建
# 导入pandas
import pandas as pd

pd.Series(data=None, index=None, dtype=None)
创建时需关注以下参数:
- data:传入的数据,可以是ndarray、list等格式。
- index:索引,必须唯一且与数据长度一致。若未指定索引,系统将默认生成从0到N的整数索引。
- dtype:指定数据的类型。
可以通过指定索引来创建Series。
pd.Series([6.7,5.6,3,10,2], index=[1,2,3,4,5])
也可以通过字典数据来创建Series。
color_count = pd.Series({'red':100, 'blue':200, 'green': 500, 'yellow':1000})
color_count
2.1.2 Series的属性
为了更便捷地操作Series对象中的索引和数据,Series提供了index和values两个主要属性。
1. index
color_count.index

# 结果
Index(['blue', 'green', 'red', 'yellow'], dtype='object')
2. values
color_count.values

# 结果
array([ 200,  500,  100, 1000])
此外,还可以直接使用索引来获取数据。
color_count[2]

# 结果
100
2.2 DataFrame
DataFrame是一个类似二维数组或表格(如Excel文件)的对象,它同时具备行索引和列索引。
- 行索引用于区分不同行,即横向索引,称为index,对应0轴(axis=0)。
- 列索引用于区分不同列,即纵向索引,称为columns,对应1轴(axis=1)。
2.2.1 DataFrame的创建
# 导入pandas
import pandas as pd

pd.DataFrame(data=None, index=None, columns=None)
创建时需关注以下参数:
- index:行标签。若未指定,默认生成从0到N的整数索引。
- columns:列标签。若未指定,默认生成从0到N的整数索引。
示例:创建一个学生成绩表。
# 生成10名同学,5门功课的数据
score = np.random.randint(40, 100, (10, 5))

# 结果
array([[46, 93, 49, 70, 53],
       [42, 86, 65, 50, 87],
       [41, 74, 44, 87, 64],
       [62, 57, 45, 46, 86],
       [82, 46, 72, 85, 63],
       [82, 77, 61, 55, 41],
       [48, 41, 48, 52, 58],
       [90, 53, 95, 96, 78],
       [77, 49, 51, 76, 56],
       [79, 91, 75, 95, 66]])
然而,这种数据形式难以直观看出存储的具体数据类型,可读性较差。
问题:如何让数据显示得更有意义?
# 使用Pandas中的数据结构
score_df = pd.DataFrame(score)
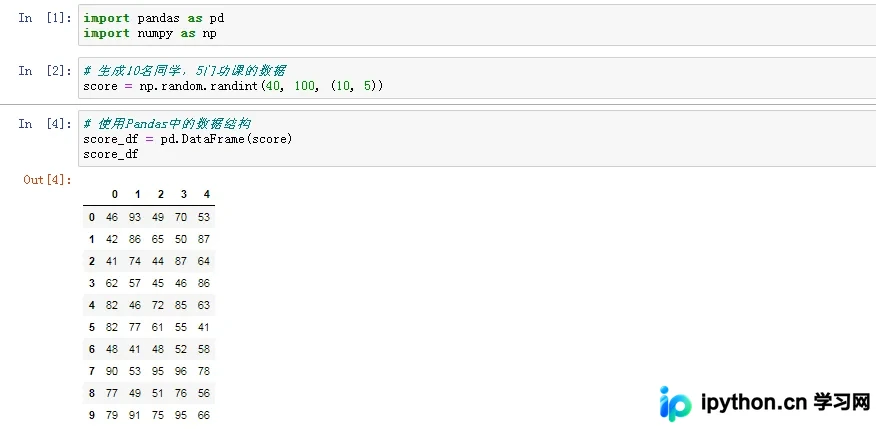
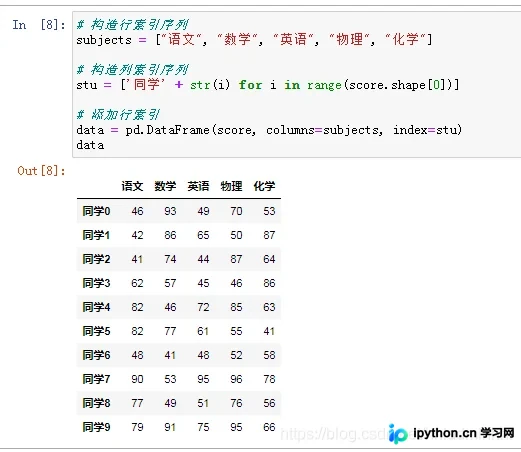
可以通过增加行和列索引来解决。
# 构造行索引序列
subjects = ["语文", "数学", "英语", "物理", "化学"]

# 构造列索引序列
stu = ['同学' + str(i) for i in range(score.shape[0])]

# 添加行索引
data = pd.DataFrame(score, columns=subjects, index=stu)
2.2.2 DataFrame的属性
1. shape
data.shape

# 结果
(10, 5)
2. index
DataFrame的行索引列表。
data.index

# 结果
Index(['同学0', '同学1', '同学2', '同学3', '同学4', '同学5', '同学6', '同学7', '同学8', '同学9'], dtype='object')
3. columns
DataFrame的列索引列表。
data.columns

# 结果
Index(['语文', '数学', '英语', '政治', '体育'], dtype='object')
4. values
直接获取其中的数组值。
data.values

array([[46, 93, 49, 70, 53],
       [42, 86, 65, 50, 87],
       [41, 74, 44, 87, 64],
       [62, 57, 45, 46, 86],
       [82, 46, 72, 85, 63],
       [82, 77, 61, 55, 41],
       [48, 41, 48, 52, 58],
       [90, 53, 95, 96, 78],
       [77, 49, 51, 76, 56],
       [79, 91, 75, 95, 66]])
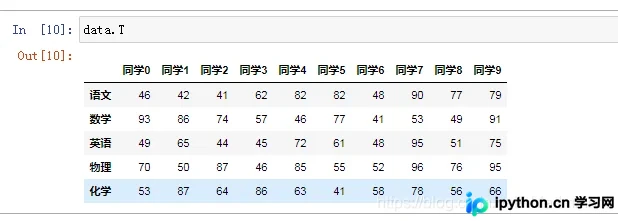
5. T
用于转置操作。
data.T
输出结果:
6. head(5):显示前5行内容(非常常用)。
若不补充参数,默认显示5行。若填入参数N,则显示前N行。
data.head(5)
7. tail(5):显示后5行内容。
若不补充参数,默认显示5行。若填入参数N,则显示后N行。
data.tail(5)
2.2.3 DataFrame索引的设置
1. 修改行列索引值。
stu = ["学生_" + str(i) for i in range(score_df.shape[0])]

# 必须整体全部修改
data.index = stu
注意:以下修改方式是错误的。
# 错误修改方式
data.index[3] = '学生_3'  #  错误
2. 重设索引。
reset_index(drop=False)
- 设置新的下标索引。
- drop:默认为False,不删除原索引;若为True,则删除原索引值。
# 重置索引,drop=False
data.reset_index()
3. 以某列的值设置为新索引。
set_index(keys, drop=True)
- keys:列索引名或列索引名称的列表。
- drop:boolean,默认True。作为新索引时,删除原来的列。
df = pd.DataFrame({'month': [1, 4, 7, 10],
                    'year': [2012, 2014, 2013, 2014],
                    'sale':[55, 40, 84, 31]})

 df = df.set_index(['year', 'month'])
注:经过上述设置,DataFrame将变为具有MultiIndex的DataFrame。
到此这篇关于Python Pandas学习之Pandas数据结构详解的文章就介绍到这了,更多相关Python Pandas数据结构内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









