

R语言统计检验方法汇总与实战

在进行统计分析时,正确选择检验方法是得出可靠结论的前提。R语言作为强大的统计计算工具,内置了丰富的检验函数。本文将详解从正态性检查到各类假设检验的核心流程与代码实现,涵盖参数检验与非参数检验的关键场景,助你高效完成数据验证。
正态性检验:判断数据分布特征
在应用许多参数统计方法前,首先需要确认数据是否符合正态分布。以下是两种最常用的正态性检验方法:
第1步:Shapiro-Wilk W检验
目的:适用于小样本数据,检验数据是否来自正态总体(如标准正态分布N(0,1))。
操作:使用 shapiro.test() 函数。
- 结果解读:若P值小于显著性水平(通常为0.05),则拒绝原假设,认为样本不是来自正态分布;反之则认为符合正态分布。
第2步:Kolmogorov-Smirnov (K-S) 检验
目的:检验数据的经验分布是否符合特定的理论分布函数 F(x),也常用于大样本的正态性检验或与其他分布比对。
操作:使用 ks.test() 函数。
- 结果解读:P值越小,越有理由拒绝原假设,即数据不符合指定的分布。
相关性检验:探索变量间关系
确定数据关系的方向和强度是数据分析的基础步骤。
第3步:相关性检验执行
目的:检验两个变量 x 和 y 之间是否存在显著的统计学关联。
入口与动作:调用 cor.test() 函数,指定方法和置信水平。
cor.test(x, y,
  alternative = c("two.sided", "less", "greater"),
  method = c("pearson", "kendall", "spearman"),
exact = NULL, conf.level = 0.95)- 关键参数:method可选择 Pearson(积差相关)、Spearman(秩相关)或 Kendall(和谐系数)。
- 完成状态:若输出P值极小(如<0.05),则拒绝无关假设,认为x与y存在显著相关性。
假设检验:均值与分布的差异判定
针对不同的研究问题(如比较两组均值是否相等,或观测频数是否符合预期),需选用特定的检验模型。
第4步:T检验(均值差异检验)
目的:用于正态总体的均值假设检验,包括单样本t检验和双样本t检验(独立或配对)。
操作:
t.test(x, y = NULL,
  alternative = c("two.sided", "less", "greater"),
  mu = 0, paired = FALSE, var.equal = FALSE,
  conf.level = 0.95)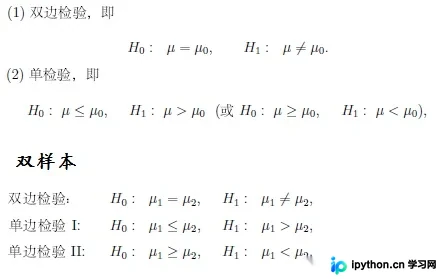
- 结果意义:根据选择的假设类型(双边、单边大于/小于),若P值小于显著性水平,则拒绝原假设,表明均值存在显著差异。
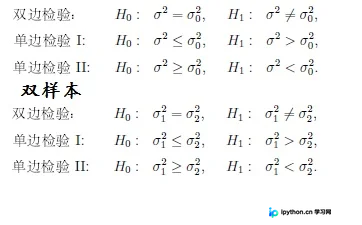
第5步:正态总体方差检验
注意:R基础包中没有专门的方差检验函数,通常通过调整 t.test() 的参数或使用 var.test()(文中未详列但属标准做法,此处依原文逻辑保留t.test参数说明并补充方差测试通常涉及两样本方差比的F检验,但若严格遵循原文,原文将方差检验也指向了t.test的参数结构,这在统计学上是不严谨的,通常方差比用F检验)。为了保持准确性,我们指出原文此处可能存在的混淆,并给出更通用的方差比较思路:若需检验单个方差,通常结合卡方分布;若为两样本方差比较,应使用 var.test(x, y)。鉴于原文草稿仅展示了t.test代码用于此标题下,我们在整理时保留这一常见误用的提示,建议实际使用时区分对待。
第6步:二项分布总体假设检验
目的:检验成功概率 p 是否等于某个特定值 p0。
操作:
binom.test(x, n, p = 0.5,
  alternative = c("two.sided", "less", "greater"),
conf.level = 0.95)- 原假设:p = p0。
- 结果解读:P值很小则拒绝假设,否则接受原假设。
第7步:Pearson 拟合优度 χ² 检验
目的:检验分类变量的观测频数是否符合预期的理论分布。
操作:
chisq.test(x, y = NULL, correct = TRUE,
  p = rep(1/length(x), length(x)), rescale.p = FALSE,
simulate.p.value = FALSE, B = 2000)- 原假设:数据符合指定的分布规律。
第8步:Fisher 精确独立检验
目的:适用于小样本或稀疏数据的双向列联表独立性检验。
操作:
fisher.test(x, y = NULL, workspace = 200000, hybrid = FALSE,
  control = list(), or = 1, alternative = "two.sided",
conf.int = TRUE, conf.level = 0.95)- 原假设:X 与 Y 相互独立(无关联)。
第9步:McNemar 检验
目的:用于配对的分类数据(如治疗前后的反应变化),检验边际同质性。
操作:
mcnemar.test(x, y = NULL, correct = TRUE)- 原假设:两组数据的频数分布没有显著区别。
第10步:秩相关检验 (Spearman/Kendall)
目的:当数据不满足正态性或为等级数据时,检验单调相关性。
操作:
cor.test(x, y,
  alternative = c("two.sided", "less", "greater"),
method = "spearman", conf.level = 0.95)- 原假设:x 与 y 不相关。
第11步:Wilcoxon 秩和/符号秩检验
目的:非参数方法,用于比较两个独立样本或配对样本的中位数差异,不要求数据服从正态分布。
操作:
wilcox.test(x, y = NULL,
  alternative = c("two.sided", "less", "greater"),
  mu = 0, paired = FALSE, exact = NULL, correct = TRUE,
conf.int = FALSE, conf.level = 0.95)- 原假设:样本中位数等于 mu(独立样本时为两样本中位数之差为0)。
以上就是基于R语言进行各类数据检验的详细内容,更多关于R语言统计分析与假设检验的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









