8段Python数据清洗代码:从删除列到时间戳转换
本文整理了8段高效Python数据清洗代码,涵盖删除多列、内存优化、分类变量数值化、缺失值检查、字符串清理及时间戳转换等核心场景。所有代码均封装为独立函数,无需修改参数即可直接复用,旨在帮助数据科学家和开发者快速提升数据处理效率。
2026-10-13
7

本文整理了8段高效Python数据清洗代码,涵盖删除多列、内存优化、分类变量数值化、缺失值检查、字符串清理及时间戳转换等核心场景。所有代码均封装为独立函数,无需修改参数即可直接复用,旨在帮助数据科学家和开发者快速提升数据处理效率。
本文介绍如何使用 Python 3.7 版本,结合 os 和 shutil 库进行文件操作,利用 Pandas 读取 Excel 中的门店与大区对应关系。通过 VLOOKUP 匹配逻辑,程序自动将二维码图片文件按所属小区名称分类并移动至指定文件夹,实现批量自动化管理。
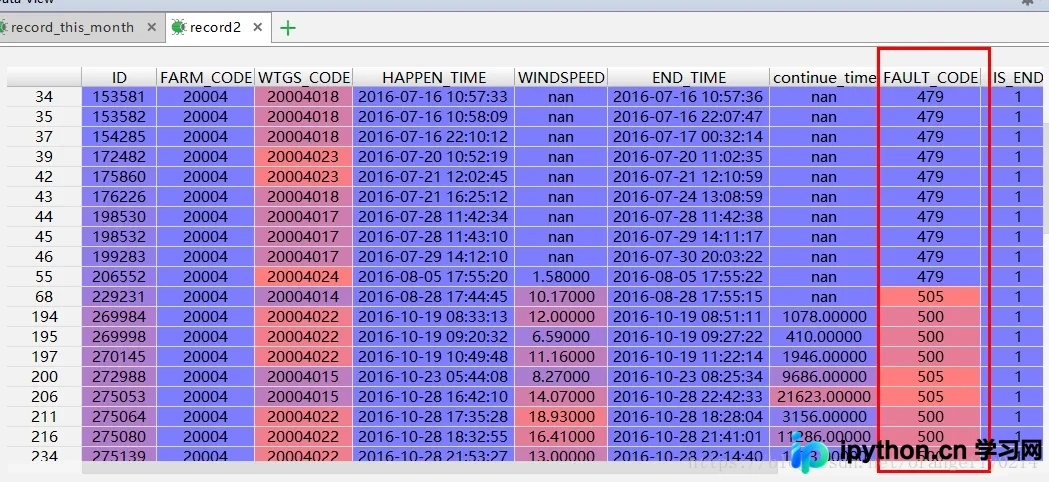
本文详解pandas中利用isin函数进行范围筛选的正确用法,避免使用in导致的逻辑错误。通过WTGS_CODE与FAULT_CODE的组合示例,演示多条件筛选时括号使用的必要性,提供完整代码片段供参考。
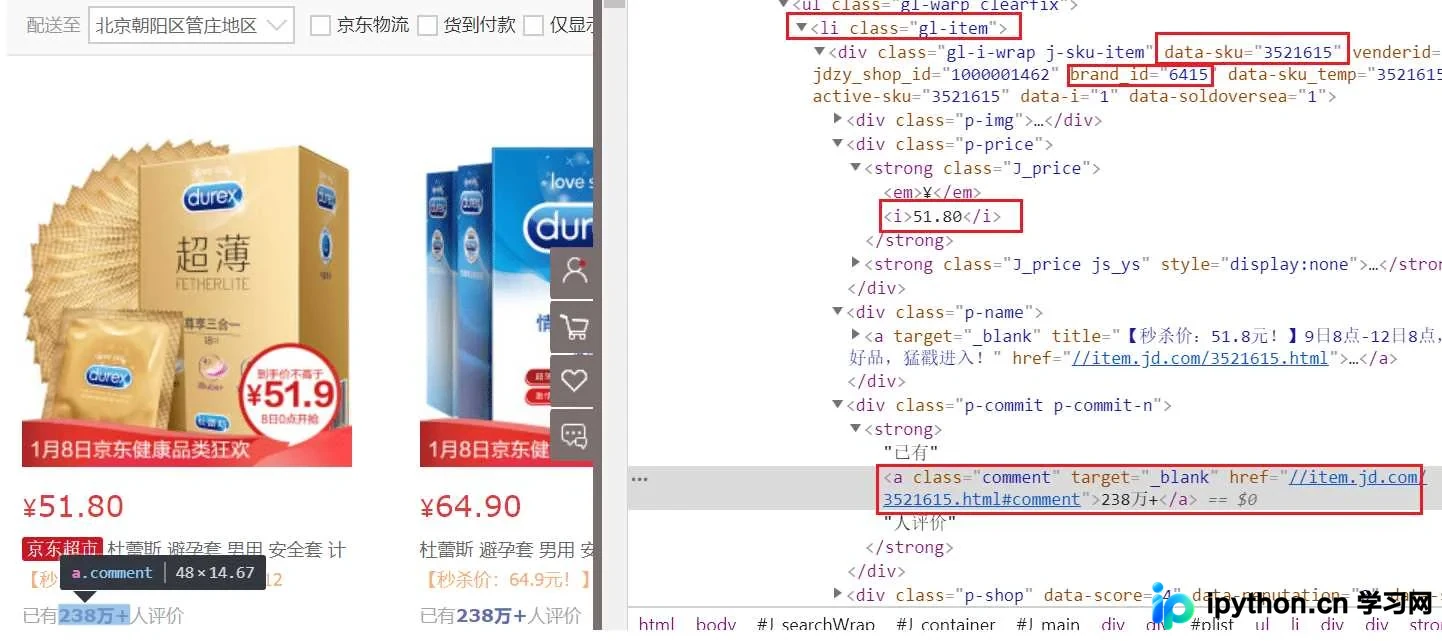
本文详解如何利用Selenium技术抓取京东平台成人用品的产品信息与评论数据,并存入MongoDB数据库。通过对8934款产品及17万条评论的分析,揭示了销量领先的品牌分布、热门产品特征及购物节对销量的显著影响,为电商数据分析提供实战参考。
本文详解如何使用Python和Pandas库构建基于Item的简易推荐系统。通过加载MovieLens数据集,利用pivot_table生成用户-电影评分矩阵,并计算电影间的Pearson相关系数。文章涵盖数据清洗、阈值设定以过滤低评分数量电影,以及通过计算相似度进行电影推荐的具体代码实现与结果分析。
本文详解Python Pandas库中利用iloc、loc及icol选取特定列与行的方法。通过对比标签索引与位置索引的区别,解析切片操作后返回Series与DataFrame类型的差异,并演示多列数值计算的注意事项,帮助开发者避免常见类型错误。
本文详细介绍如何使用 pandas 的 drop 函数删除 DataFrame 中的指定行或列。通过设置 axis 参数区分操作对象,并重点讲解 inplace 参数在原地修改数据时的应用,同时提及不同 pandas 版本中参数用法的差异及注意事项。
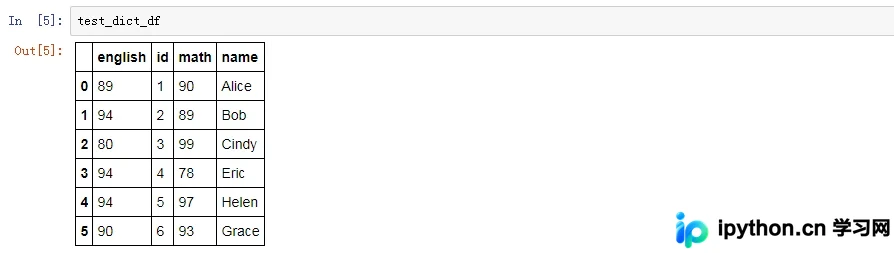
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文详解Python Pandas库中时间序列处理的核心功能。涵盖使用pd.date_range和pd.period_range生成日期序列的区别,通过pd.Timestamp和pd.to_datetime创建及转换时间戳对象,解析Period对象的时间间隔计算,以及利用asfreq和resample进行频率转换与数据重采样统计。
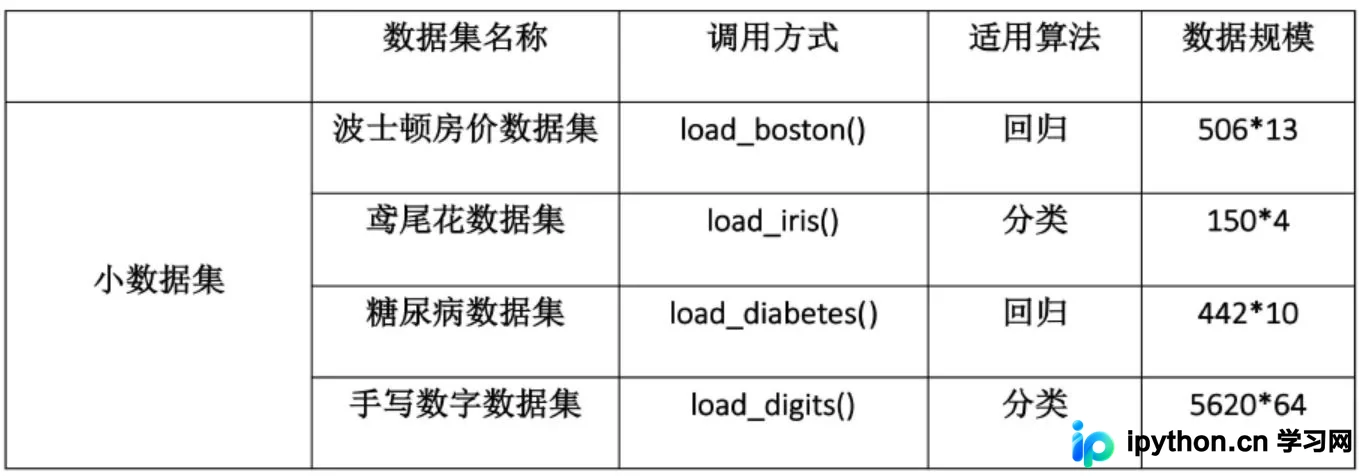
本文详细介绍Python中两大核心库NumPy与Scikit-learn的基础应用。涵盖NumPy数组创建、内存优势及常用数值计算方法,并系统讲解Sklearn的监督与无监督学习模块、数据变换工具及标准API调用流程,助力快速上手机器学习实践。
本文详解在pandas中读取CSV文件时如何查看和修改各列的数据类型。通过对比Numpy的dtype与Pandas的dtypes,介绍使用astype、to_numeric及infer_objects等方法进行类型转换的技巧,包括处理无效值和批量转换多列的实用方案。
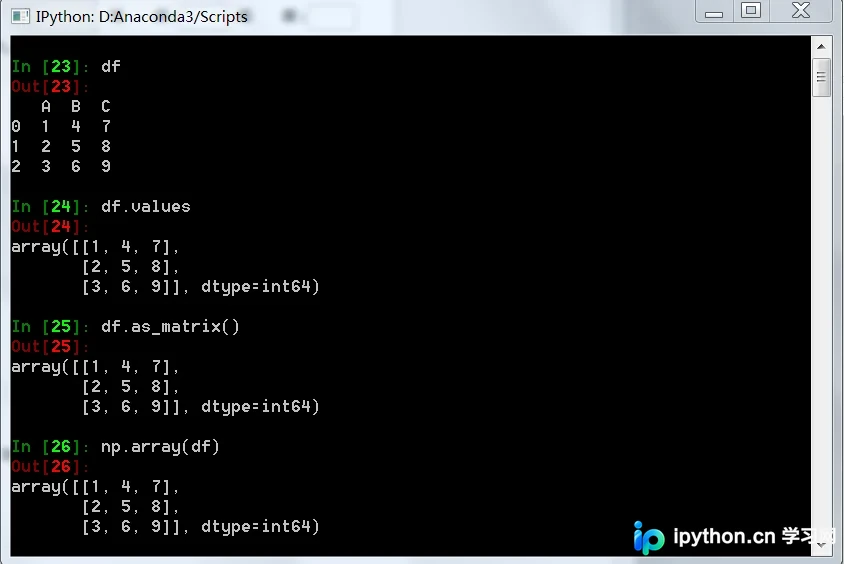
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。