pandas DataFrame append方法详解与使用示例
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
2026-10-13
7

本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文详解Python Pandas库中时间序列处理的核心功能。涵盖使用pd.date_range和pd.period_range生成日期序列的区别,通过pd.Timestamp和pd.to_datetime创建及转换时间戳对象,解析Period对象的时间间隔计算,以及利用asfreq和resample进行频率转换与数据重采样统计。
本文详细介绍Python中两大核心库NumPy与Scikit-learn的基础应用。涵盖NumPy数组创建、内存优势及常用数值计算方法,并系统讲解Sklearn的监督与无监督学习模块、数据变换工具及标准API调用流程,助力快速上手机器学习实践。
本文详解在pandas中读取CSV文件时如何查看和修改各列的数据类型。通过对比Numpy的dtype与Pandas的dtypes,介绍使用astype、to_numeric及infer_objects等方法进行类型转换的技巧,包括处理无效值和批量转换多列的实用方案。
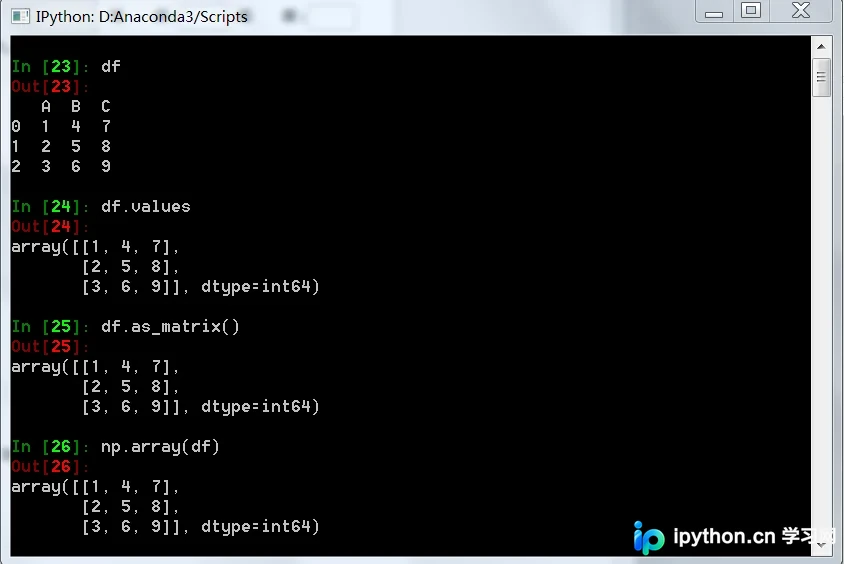
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
本文深入解析pandas中的Series数据类型,涵盖由列表、NumPy数组及字典创建Series的多种方法。详细阐述Series的索引机制、与数组的区别,以及shape、index、values等核心属性。同时介绍非空值过滤、name属性设置及isnull/notnull等常用操作,帮助开发者高效掌握Series数据结构。
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
本文介绍如何使用Python的Pandas库生成指定范围内的日期列表。通过pd.date_range函数,可以灵活设置起始与结束日期,并自定义频率参数(如天、月等)。示例展示了如何将日期对象转换为字符串格式,适用于数据分析和时间序列处理场景。
本文介绍如何使用Python pandas库创建DataFrame,并通过指定列名列表调整列的显示顺序。同时演示如何将默认从0开始的索引(index)修改为从1开始,适用于需要特定数据展示格式的场景。
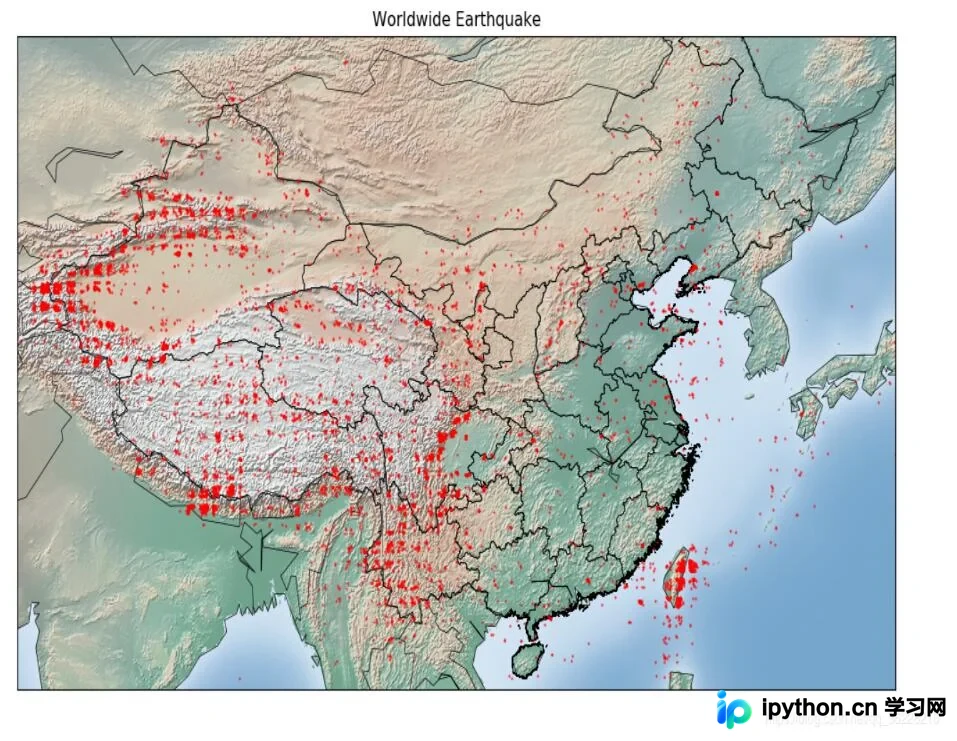
本文介绍如何使用Python的Pandas、Matplotlib及Basemap库,对约五年的全球地震数据进行可视化处理。通过解析Excel数据,筛选中国省份,转换经纬度格式,并利用Basemap绘制带有震级大小映射的全球地震散点图,展示地震分布情况。
本文详细介绍Python3.5中Pandas模块Series的核心用法。涵盖通过numpy数组、字典及直接赋值创建Series的方法,演示索引与数据类型的自定义设置。深入解析Series值的获取、算术运算、缺失值检测(isnull/notnull)以及基于索引的自动对齐机制,并提供完整代码示例与运行结果分析,帮助开发者掌握Series数据结构的基础操作。