

Python使用pymysql连接数据库并将查询结果转换为DataFrame
本文介绍了如何使用Python的pymysql库连接MySQL数据库,并通过pandas库将查询结果转换为DataFrame对象。文章提供了完整的代码示例,展示了从建立连接、执行SQL查询到关闭连接的完整流程,以及如何遍历和访问DataFrame中的元素。
2026-10-14
7

本文介绍了如何使用Python的pymysql库连接MySQL数据库,并通过pandas库将查询结果转换为DataFrame对象。文章提供了完整的代码示例,展示了从建立连接、执行SQL查询到关闭连接的完整流程,以及如何遍历和访问DataFrame中的元素。
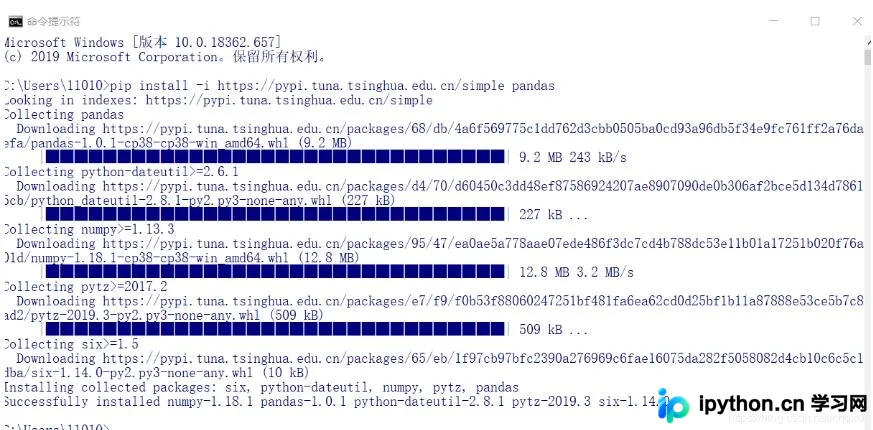
本文详细解决PyCharm中导入Pandas包失败的常见问题。涵盖通过cmd使用清华源pip加速安装、验证安装状态,以及当包未自动识别时,手动配置Project Interpreter、指定pythonw.exe路径及切换Existing environment的完整操作步骤,帮助初学者快速恢复开发环境。
本文详细介绍如何使用Python的pandas库读取CSV文件,通过指定列条件筛选特定数据行,并将结果保存为新的CSV文件。教程涵盖从导入库、读取文件、处理DataFrame结构到执行筛选逻辑及导出文件的完整步骤,适合初学者参考。
本文详细介绍如何在Python中使用Pandas进行分组求和与分组累加求和,涵盖groupby、count、cumsum及merge等关键操作。同时解析Django中利用aggregate与annotate函数对数据库字段进行条件求和的正确姿势,对比两种实现方式的输出差异,帮助开发者准确获取统计结果。
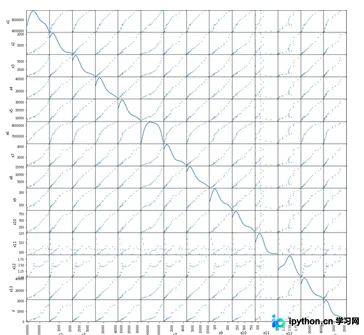
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
本文详解Pandas中read_csv读取CSV文件时常见的两类错误:因字段数不匹配导致的ParserError及KeyError。通过设置error_bad_lines=False跳过异常行,并区分Series与DataFrame赋值差异,提供针对EOF字符串错误及类型比较错误的实用解决方案。
本文详细介绍pandas中数据拼接的多种方法,包括使用join()合并无重复列的DataFrame、利用concat()按行或列拼接Series及DataFrame,以及通过combine_first()处理索引重复的情况。此外,还演示了stack()与unstack()在行列转换中的应用,帮助开发者高效处理数据整合任务。
本文介绍利用pandas库将宽表转换为窄表以及反向操作的具体实现。通过示例演示如何使用melt函数将多列数据重塑为键值对形式,并展示手动构建宽表的逻辑。适用于处理如体检数据等多条目记录,帮助开发者高效完成数据格式转换任务。
本文详细介绍Pandas中时间序列处理的两种核心方法:resample()重采样与asfreq()频度转换。重点解析降采样时的closed与label参数对区间闭合及标签的影响,以及升采样时利用ffill和bfill进行缺失值填充的策略,并对比asfreq不进行聚合仅转换频率的特性,附带分组重采样示例。
在Python开发中,当输出内容过多时,PyCharm控制台常以省略号截断显示。本文介绍如何通过pandas库的set_option方法,调整display.max_columns和display.max_rows参数,强制显示所有列和行,从而解决输出内容不完整的问题,确保数据查看的完整性。
本文介绍在 Pandas 中调整 DataFrame 列顺序的两种常用方法。通过操作列名列表或使用 insert 函数,可以将特定列(如 Mid)移动至第一列。示例展示了从读取 CSV 文件到重新排列列并保存结果的完整流程,适用于数据预处理和特征工程场景。
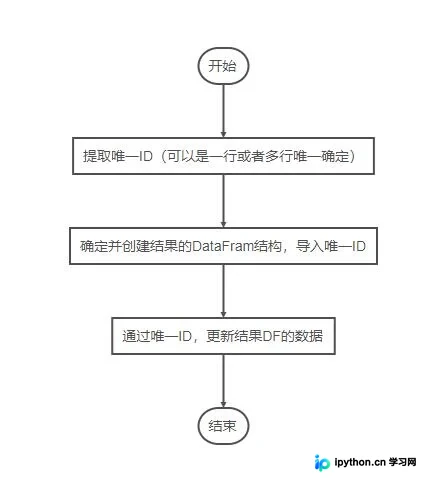
本文介绍在Python Pandas中处理DataFrame NaN值的方法。通过示例展示如何合并数据产生NaN,并使用where方法结合notnull()将NaN替换为None或其他指定值,帮助开发者进行数据清洗。