

Python使用pandas将Excel按列拆分为多个文件
本文介绍如何使用Python的pandas库将一个Excel文件按指定列(如销售部门)拆分为多个独立的Excel文件。通过读取数据、提取分类并循环处理,将不同类别的数据分别保存为新的Excel文件,实现数据的分类管理。
2026-10-11
6

本文介绍如何使用Python的pandas库将一个Excel文件按指定列(如销售部门)拆分为多个独立的Excel文件。通过读取数据、提取分类并循环处理,将不同类别的数据分别保存为新的Excel文件,实现数据的分类管理。
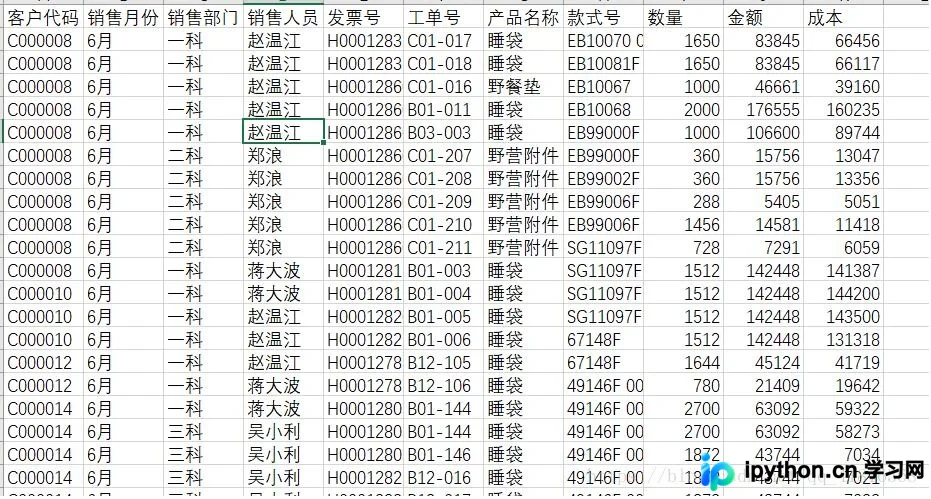
Pandas 创建透视表后会自动生成多级索引,影响后续导出或下游分析。本文基于实际运行环境,演示如何使用 reset_index() 完整展平索引、通过 level 参数选择性剥离层级、配合 unstack 保留单行索引结构,以及利用 melt 转换为长格式明细。各方案附完整代码与完成状态校验,适配不同业务场景。
本文介绍如何使用pandas的iloc方法结合列表推导式,通过行索引表达式进行等距抽样。核心步骤包括生成目标索引列表,然后利用iloc选取对应行,最终实现数据的高效分割与提取。
在数据分析实践中,缺失值常以 NaN 或误导性零值形式出现。本文梳理 Pandas 缺失数据检测机制,详细演示按列过滤、整行剔除及均值/中值填充的具体代码,并说明如何将无效零统一转码为 NaN,确保聚合运算不受干扰。
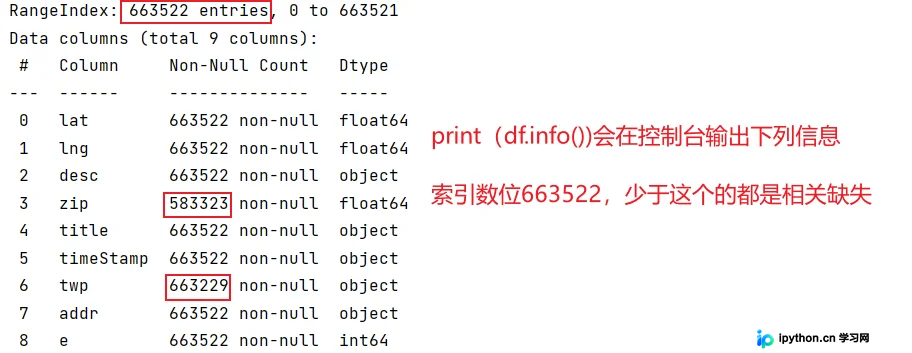
数据清洗是数据分析的核心环节。本文整理Python处理字符串、数值、日期及缺失值的18种高效方法,涵盖基础语法技巧,并深入讲解正则提取、Pandas批量操作、异常捕获与函数封装等进阶流程,帮助开发者快速规范数据格式、提升处理效率。
本文总结了Python中保存文件的几种常用方法,包括使用pickle模块保存为二进制文件、使用numpy保存为npz格式以及使用pandas保存为csv格式。文章提供了具体的代码示例,帮助读者快速掌握这些技术。
面对GB级文本、CSV或二进制文件,一次性加载极易引发内存溢出。本文系统梳理Python中高效处理大型文件的7种核心方案,涵盖逐行迭代、固定分块读取、内存映射、Pandas/Numpy分批解析及随机访问技巧。提供完整代码模板与适用场景对照,帮助开发者根据数据类型灵活选型,显著提升I/O性能与程序稳定性。
在数据预处理中,将类别属性转化为数值属性是常见需求。本文介绍两种基于pandas的处理方法:针对无大小意义的离散特征使用get_dummies进行One-Hot编码;针对有大小意义的特征,通过字典映射将其转换为有序的数值。
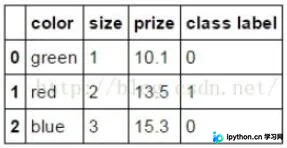
在数据分析与建模前,原始数据常伴随缺失、重复、异常及格式混乱等问题。本文基于Python生态,系统梳理数据清洗的标准流程:涵盖缺失值的删除与多维填充、重复记录的清除与标记、异常值的阈值控制、类型转换与文本清洗,以及分组统计、连续变量分箱和特征归一化。掌握这些操作可快速提升数据质量,保障后续分析结果的可靠性。
针对日常办公中重复繁琐的任务,本文提供10个基于Python的自动化办公脚本方案。涵盖Excel批量处理、数据清洗、自动发邮件、文件重命名与备份、PPT生成、报表可视化及任务调度等核心场景,附带关键库安装说明、完整代码示例及参数配置方法,助你快速搭建个人提效工具链。
在使用 pandas.read_csv() 读取 CSV 文件时,若遇到中文乱码,通常是因为文件编码与读取参数不匹配。本文介绍通过设置 encoding 参数(如 'gbk' 或 'utf-8')解决乱码的方法,并详细说明当直接指定编码报错时,如何利用记事本将文件另存为指定编码格式,从而确保数据正确读取。
数据分析前需统一格式并剔除无效记录。本文基于pandas库演示完整的数据清洗流水线,涵盖多格式读写、空值插补、去重、类型转换、离群点过滤及特征归一化,提供可直接运行的预处理代码,助力快速构建高质量数据集。