

Pandas数据缺失处理:NaN检测、过滤与填充实操

在数据分析实践中,缺失值常以 NaN 或误导性零值形式出现。本文梳理 Pandas 缺失数据检测机制,详细演示按列过滤、整行剔除及均值/中值填充的具体代码,并说明如何将无效零统一转码为 NaN,确保聚合运算不受干扰。
一、检测与识别 NaN 缺失值
Pandas 中的缺失值默认以 NaN 表示。在处理前,首先需要确认特定列是否存在此类数据。可通过 isnull() 结合 any() 方法快速判断:
has_nan = df['age'].isnull().any()
print(has_nan)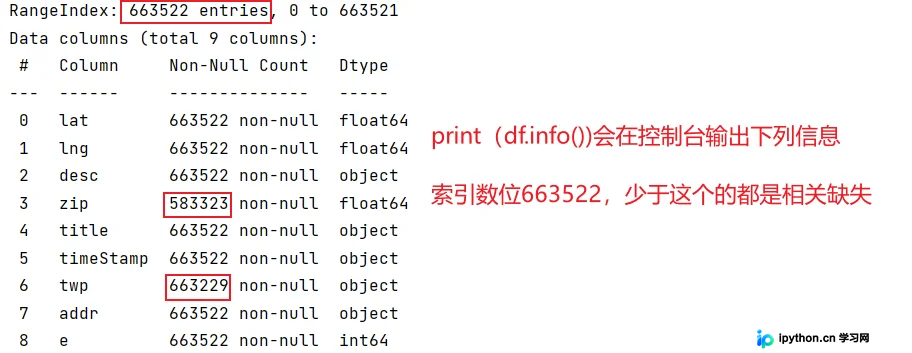
二、针对 NaN 数据的清理策略
发现缺失值后,可根据业务需求选择保留有效样本或删除不完整记录。以下以 original_publication_year 列为示例进行操作。
第1步:按单列条件过滤数据
目的:仅移除指定列含有 NaN 的行,生成纯净子集 DataFrame。
入口与动作:在 DataFrame 对象上直接使用布尔索引,配合 pd.notnull() 对目标列执行有效性校验并返回筛选结果。
df2 = df[pd.notnull(df["original_publication_year"])]重要参数与完成状态:无需额外参数,执行后生成新对象 df2。通过打印 df2.shape 或比对行列数变化,可直观确认所有原 original_publication_year 含空值的记录已被剔除。
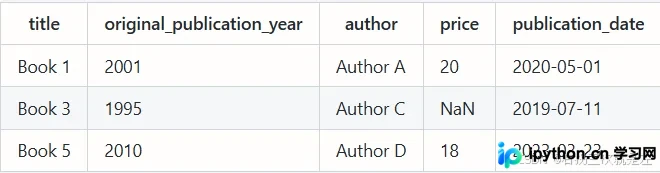
第2步:直接删除含缺失值的行
目的:一次性清除 DataFrame 中包含任何 NaN 的行。
入口与动作:调用 DataFrame 内置的 dropna() 方法遍历行数据进行拦截。
df.dropna(axis=0, how='any', inplace=False)重要参数与完成状态:axis=0 指定沿行方向操作;how='any' 代表只要行内存在至少一个 NaN 即删除,若改为 'all' 则需全为空才删;inplace=True 可原地覆盖原表。建议操作前先备份 DataFrame,完成后检查总行数是否下降至预期阈值。
第3步:使用统计值或常数填充
目的:在保留全部样本的前提下,用合理数值替代空白以保证后续建模或计算连贯。
入口与动作:定位到目标列后,调用 fillna() 传入预设的标量或动态计算序列。
# 计算全局均值并填充
mean_val = df["original_publication_year"].mean()
df["original_publication_year"] = df["original_publication_year"].fillna(mean_val)

# 单列独立填充示例(均值 / 中值 / 固定值)
t["col"] = t["col"].fillna(t["col"].mean())
t["col"] = t["col"].fillna(t["col"].median())
t["col"] = t["col"].fillna(0)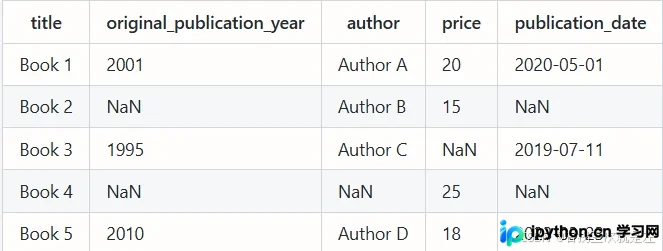
三、将无效零值作为缺失值处理
在实际收集中,部分字段会用 0 代替未填写的状态。由于 0 会干扰均值、方差等聚合计算(NaN 会自动被忽略),需先将其转为标准缺失标识:
t[t == 0] = np.nan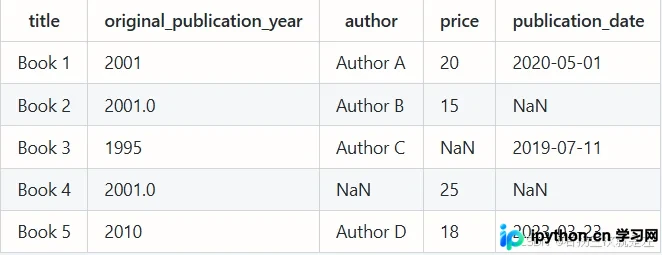
完成类型统一后,直接套用第一部分的过滤、删除或填充逻辑即可。操作完毕后务必运行 .describe() 或再次检查 .isnull().sum() 验证清洗效果。
以上就是 Pandas 数据缺失处理的详细内容,更多关于 Python 数据分析清洗的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









