

Python合并拆分Excel的实操方法
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
2026-10-11
6

使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。
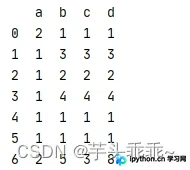
本文介绍在 Python Pandas 中删除指定列值或多列内容的几种方法。通过 Series 的 isin 反函数(使用 - 号)处理大批量数据,利用 != 比较运算符处理少量指定内容,以及结合 dropna() 处理 DataFrame 的多条件删除。
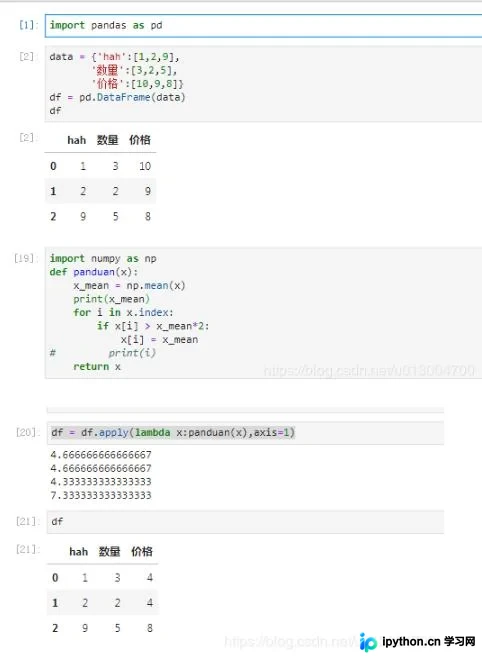
本文介绍如何利用Numpy处理传感器数据中的异常值与缺失值。通过字符串替换、类型转换、指定列阈值替换以及基于均值的条件替换,实现数据清洗。示例涵盖将'nan'替换为固定值、按列上下限替换,以及利用apply函数按行判断并替换超过均值指定倍数的值。
本文深入解析Python的核心应用场景。从Web后端开发(Django/Twisted)到系统运维自动化,从科学计算(NumPy)到网络爬虫,详细阐述Python在各类技术栈中的具体作用与优势,帮助开发者理解其广泛适用性。
本文系统梳理在 Python 中将内存数据持久化至磁盘的四种主流方案,详细演示 open() 基础文本写入、csv 模块表格导出、NumPy 数组保存及 Pandas DataFrame 多格式转换。结合打开模式参数配置与防覆盖提醒,提供可直接运行的完整代码,助力开发者根据数据结构快速选型。
本文介绍在Pandas中将单列数据按分隔符拆分为多列的多种方法。通过str.split()结合expand参数、索引提取或解包赋值,可高效完成数据清洗。同时涵盖处理列表数据及生成测试数据的技巧,帮助开发者快速实现列拆分操作。
本文详细讲解pandas中ix的用法及其在0.20.0版本后的弃用原因。ix曾尝试结合loc和iloc的功能,但因其行为复杂且易引发歧义,官方建议使用iloc(基于位置)和loc(基于标签)替代。文章通过具体代码示例,展示了ix在不同索引类型下的行为,并提供了使用iloc和get_loc实现复杂切片的替代方案。
本文介绍如何使用Python的pandas库实现Excel中的数据透视表和Vlookup匹配功能。通过读取Excel文件、过滤数据、计算汇总指标,并将结果保存为新的Excel文件,展示了数据处理的基本流程。
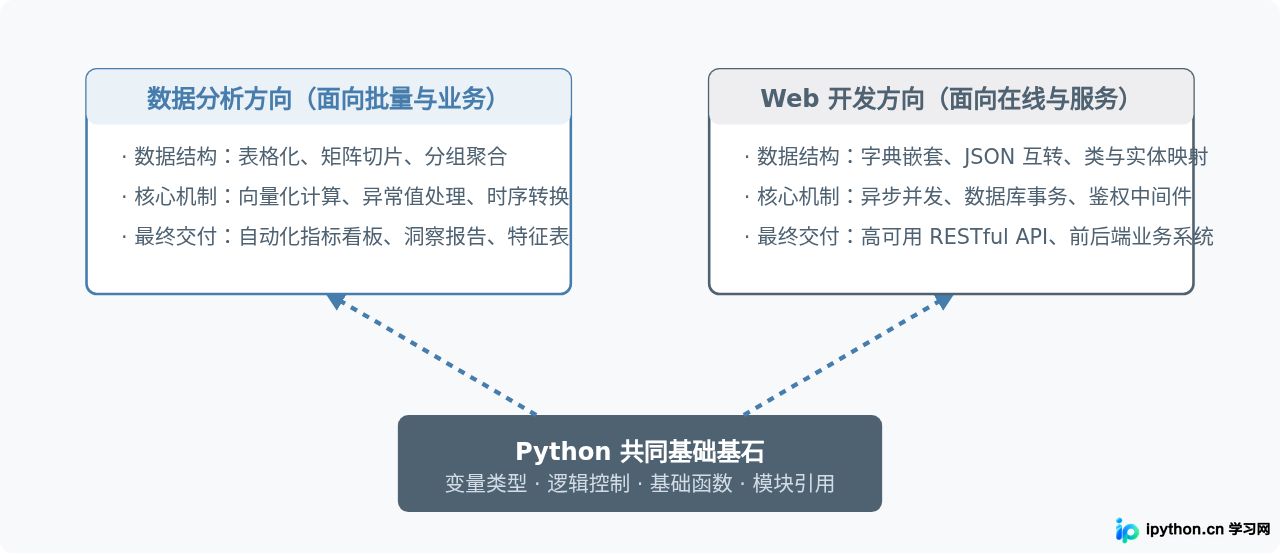
对比零基础转行数据分析与Web开发两个不同方向时,Python基础语法的取舍、核心第三方库、数据结构侧重以及学习落地路径的具体差异。
本文介绍如何使用 Pandas 库对 DataFrame 进行按行计算百分比(比例)的操作。通过结合 `sum()` 与 `div()` 方法,并正确指定 `axis` 参数,可以快速实现数据在行维度上的归一化处理,适用于不同月份或类别数据的比例分析。
本文详细解析 Python 中 &= 运算符的双重运行机制,涵盖按位与赋值与集合交集更新两种场景。通过整数奇偶判断、类型验证及数据结构清洗的完整代码示例,展示如何在不依赖第三方库的情况下高效清理含空值的字典列表,并提供多集合链式求交的技巧,帮助开发者在底层逻辑优化与日常编码中灵活运用该语法。