

Pandas中DataFrame.replace()函数的详细用法与参数解析
掌握Pandas中DataFrame.replace()函数的核心参数与多种替换场景。本文通过单值、字典映射、列表对应及正则表达式四个实操步骤,演示如何高效清洗数据并规避原地修改的风险,助力Python数据分析流程更稳定。
2026-10-11
6

掌握Pandas中DataFrame.replace()函数的核心参数与多种替换场景。本文通过单值、字典映射、列表对应及正则表达式四个实操步骤,演示如何高效清洗数据并规避原地修改的风险,助力Python数据分析流程更稳定。
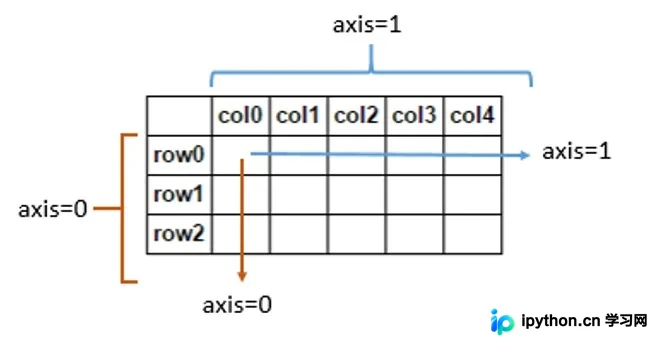
在Python数据分析中,axis=0和axis=1是核心概念。axis=0代表沿行方向(跨列)操作,如计算每列均值;axis=1代表沿列方向(跨行)操作,如计算每行均值。理解这一区别对于正确执行数据聚合和列删除至关重要。
Pandas 能够高效完成类 SQL 的数据处理任务。本文详细演示如何通过 Pandas DataFrame 实现 SELECT 字段选择、WHERE 条件过滤、GROUP BY 分组聚合以及 LIMIT 限制行数等操作,并提供对应的 Python 代码示例与结果对照,帮助开发人员在非关系型数据库环境中快速完成表格数据查询。
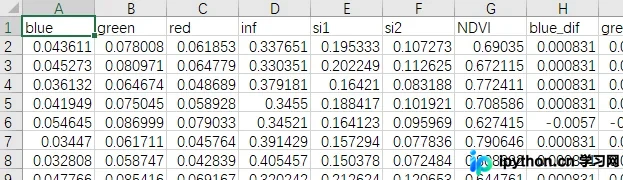
针对包含多列特征的表格数据,本文演示如何使用Python的pandas库,根据指定数值区间自动剔除不符合条件的行。通过布尔索引组合多列筛选条件,高效完成数据清洗并输出新文件,适用于模型训练前的大量样本过滤场景。
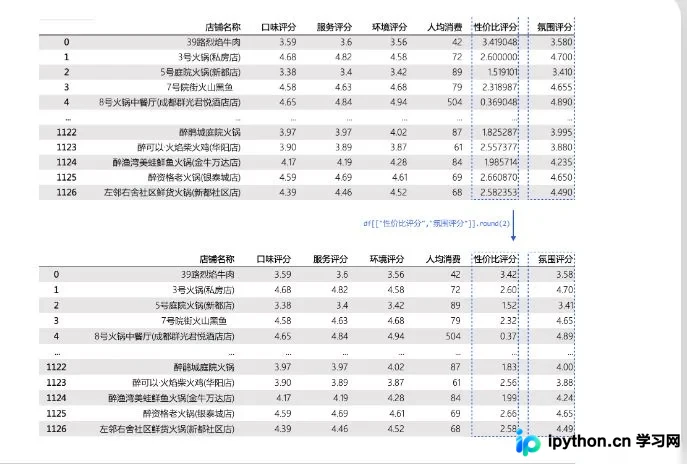
本文以Python的pandas库为核心,演示数据处理的完整流程。从新增衍生列、控制小数精度、按指标排序筛选,到统一时间货币格式,逐步排查并清理缺失值、逻辑异常值与重复记录,最终输出符合分析要求的高质量数据集。
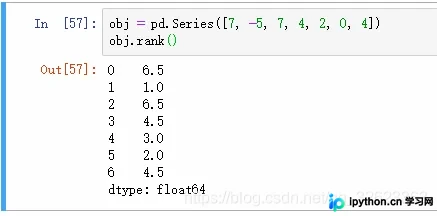
本文详解pandas中Series与DataFrame的rank排名函数。内容涵盖默认平均排名原理、利用method参数自定义并列值处理策略、设置降序排列以及指定数据框行列维度的完整操作指南,帮助开发者快速掌握数据位次计算与标准化处理方法。
本文介绍在pandas中修改DataFrame列名的5种方法,包括直接赋值、map函数、rename函数、字典法和映射法。通过具体代码示例,展示如何高效修改列名,适用于数据清洗和预处理场景。
讲解如何将 Python 列表快速转换为 Excel 表格第一列。分别基于 openpyxl 与 pandas 库提供完整代码示例,涵盖单维列表导入、二维数据切片及多表头组合写入,附带文件保存参数说明与常见报错排查,帮助开发者精准掌握数据导出流程。
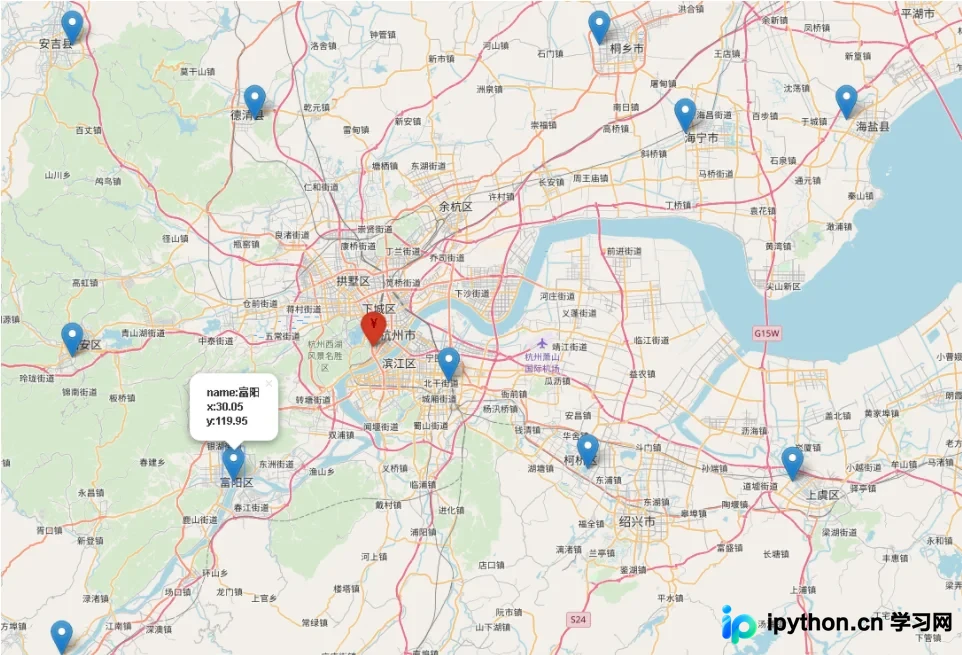
本文介绍如何使用Python的folium库结合pandas处理Excel数据,绘制气象站点地图。通过度分转换、距离计算和自定义标记,展示如何从Excel文件中读取数据并在地图上可视化站点位置。
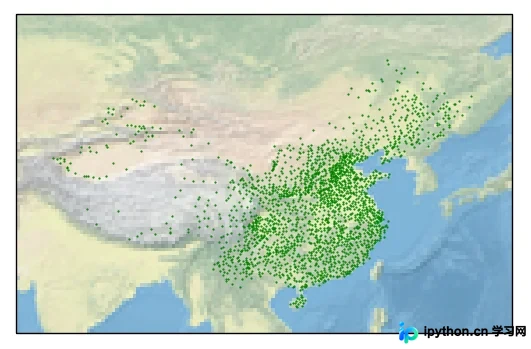
本文介绍如何利用Python将Excel中的气象站点数据与Shp格式的国家边界数据结合,通过Pandas进行数据清洗,并使用Cartopy和Matplotlib在地图上可视化展示。重点涵盖经纬度格式转换、Shp文件读取、基于GDP数据的着色处理以及地图坐标系的配置。
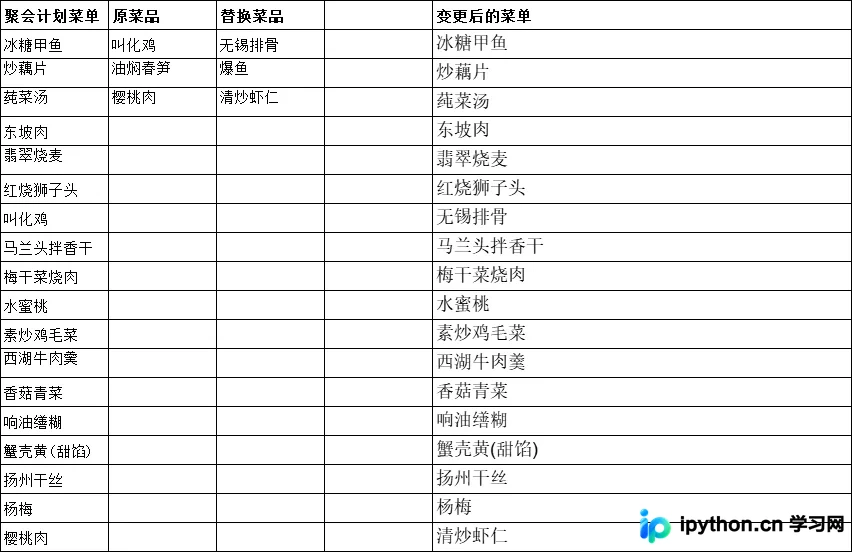
针对需要在Excel或在线表格中批量替换指定字符的需求,本文梳理了WPS substitutes函数、Excel VLOOKUP组合公式,以及WPS在线版与离线Pandas版本的Python实现方案。通过构建映射字典或条件判断逻辑,可快速完成菜单术语等数据的清洗与转换,适配不同数据量与办公场景。
本文详解使用pandas读取包含中文Unicode编码的CSV文件,重点解析delimiter、header及encoding参数的应用。通过names参数覆盖自动生成的列索引,实现自定义列标题,并提供具体代码示例与输出结果分析。