

使用Numpy对特征中的异常值进行替换及条件替换方式

发布时间:2026-10-11| 2人浏览过
本文介绍如何利用Numpy处理传感器数据中的异常值与缺失值。通过字符串替换、类型转换、指定列阈值替换以及基于均值的条件替换,实现数据清洗。示例涵盖将'nan'替换为固定值、按列上下限替换,以及利用apply函数按行判断并替换超过均值指定倍数的值。
Numpy处理异常值与条件替换
在传感器数据采集场景中,原始数据往往以Excel文件形式存在。通过Python的xlrd模块读取后,数据通常表现为数组形式。由于采集过程的不确定性,数据中常包含部分异常值和缺失值(如字符串形式的'nan')。利用Numpy库,我们可以高效地对特征中的异常值进行替换及条件替换。
1. 字符串型'nan'的替换与类型转换
当数据以字符串形式存储时,直接进行数值计算会报错。首先需要识别并替换字符串形式的'nan',随后将数据类型转换为浮点型。
import numpy as np

data = np.array([['nan', 1, 2, 3, 4], # 数据类型为字符串型
        [10, 15, 20, 25, 'nan'],
        ['nan', 5, 8, 10, 20]])
print(data)
# [['nan' '1' '2' '3' '4']
# ['10' '15' '20' '25' 'nan']
# ['nan' '5' '8' '10' '20']]

data[data == 'nan'] = 100 # 将numpy中为'nan'的项替换为 100
print(data)
# [['100' '1' '2' '3' '4']
# ['10' '15' '20' '25' '100']
# ['100' '5' '8' '10' '20']]

data = data.astype(float) # 将数据由字符型转换为浮点型
print(data)
# [[100.  1.  2.  3.  4.]
# [ 10. 15. 20. 25. 100.]
# [100.  5.  8. 10. 20.]]
2. 按列进行条件替换
除了替换缺失值,我们还需要根据业务逻辑对特定列的异常值进行修正。例如,将某列小于下限的值替换为下限值,或将大于上限的值替换为上限值。
print(data)
# [[100.  1.  2.  3.  4.]
# [ 10. 15. 20. 25. 100.]
# [100.  5.  8. 10. 20.]]

data[:, 1][data[:, 1] < 5] = 5 # 对第2列小于 5 的替换为5
print(data)
# [[100.  5.  2.  3.  4.]
# [ 10. 15. 20. 25. 100.]
# [100.  5.  8. 10. 20.]]

data[:, 2][data[:, 2] > 15] = 10 # 对第3列大于 15 的替换为10
print(data)
# [[100.  5.  2.  3.  4.]
# [ 10. 15. 10. 25. 100.]
# [100.  5.  8. 10. 20.]]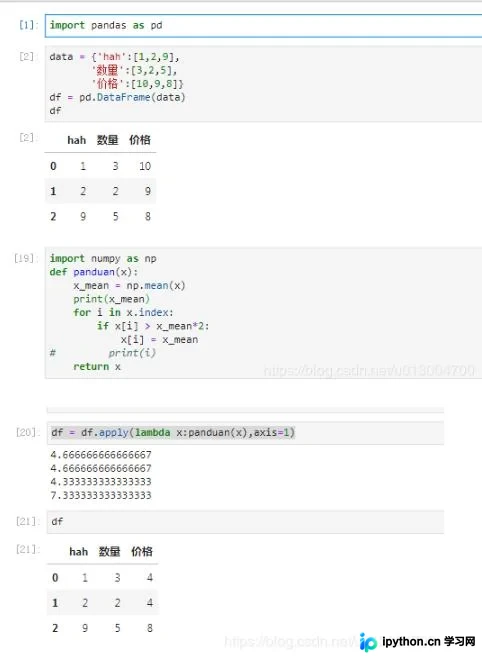
3. 基于均值的条件替换(按行判断)
在某些场景下,我们需要判断某行的值是否超过该行均值的指定倍数(如2倍),若超过则用均值替换。这可以通过Pandas的apply函数结合Numpy实现。
import pandas as pd

data = {'hah':[1,2,9],
    '数量':[3,2,5],
    '价格':[10,9,8]}
df = pd.DataFrame(data)
df

import numpy as np
def panduan(x):
  x_mean = np.mean(x)
  print(x_mean)
  for i in x.index:
    if x[i] > x_mean*2:
      x[i] = x_mean
#     print(i)
  return x

df = df.apply(lambda x:panduan(x),axis=1)
上述代码定义了一个函数pandan,计算每行的均值,并遍历该行中的每个元素。如果元素值大于均值的2倍,则将其替换为均值。最后通过apply函数按行应用该逻辑。
总结
通过Numpy和Pandas的结合,我们可以灵活处理传感器数据中的异常值。无论是字符串形式的缺失值替换,还是基于阈值和均值的条件替换,都能有效提升数据质量。以上就是使用Numpy对特征中的异常值进行替换及条件替换方式的详细内容,更多关于Numpy数据清洗的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









