

Python Pandas分组统计、聚合运算与透视表实战指南

发布时间:2026-10-12| 4人浏览过
本文详解Python Pandas中数据分组统计、聚合运算及透视表的实现方法。涵盖groupby的分割、应用与组合流程,演示单列与多列分组统计、缺失值填充技巧。深入解析agg函数的标准与自定义聚合,以及pivot_table和crosstab在数据透视与频率统计中的应用,提供完整代码示例。
1 数据分组统计 groupby
- 分割 split:依据键值(key)或分组变量将数据划分为不同的组。
- 应用 apply:针对每个分组执行特定函数,通常涉及累计、转换或过滤操作。
- 组合 combine:将各分组的处理结果合并,生成最终的输出数据组。
常用功能
1. len(gp1) #组数
2. gp1.size() #每组的记录个数
3. df3.groupby(["小组","评级"])  #得到的结果是一个groupby对象
4. gp1.mean()  #每组组内的平均值,还有sum、max、min、count
5. apply #自定义统计函数(自己定义一个函数,作为参数,会自动将函数应用到每一组数据当中去)
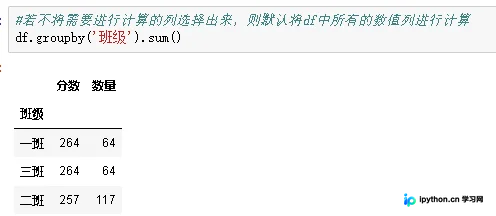
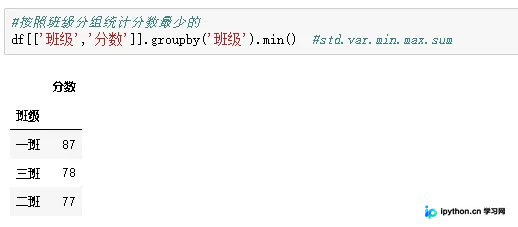
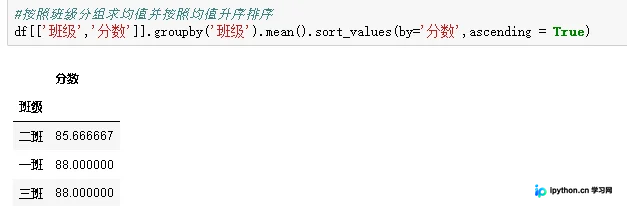
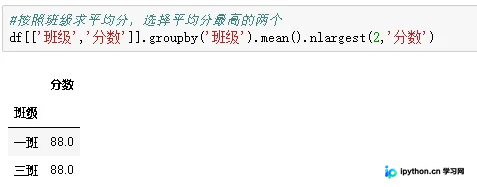
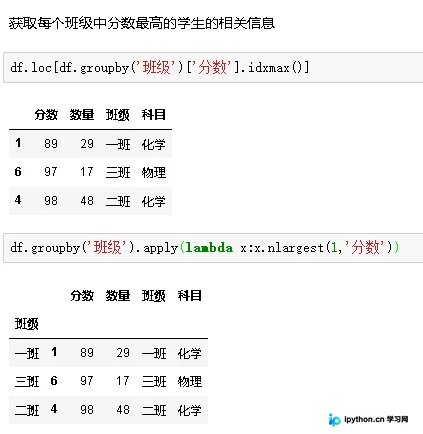
1.1 按照单列进行分组统计df.groupby(‘列名’).count()
# 创建示例DataFrame
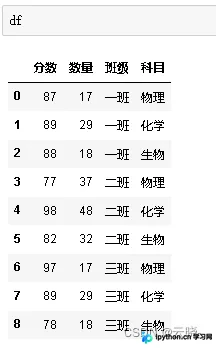
data = {'班级': ['一班', '一班','一班','二班', '二班','二班','三班','三班','三班'],
        '科目': ['物理', '化学', '生物','物理', '化学', '生物','物理', '化学', '生物'],
        '数量': [17, 29, 18,37,48,32,17, 29, 18],
        '分数': [87, 89, 88,77,98,82,97, 89, 78]}
df = pd.DataFrame(data)
# 创建示例DataFrame
data = {'班级': ['一班', '一班','一班','二班', '二班','二班','三班','三班','三班'],
        '科目': ['物理','生物','生物','物理', '物理', '生物','化学', '化学', '生物'],
        '姓名': ['张三', '章中', '贺天','紫瞳','西德','魏斯','明峰', '希方', '塞法'],
        '分数': [87, 89, 88,77,98,82,97, 89, 78]}
df = pd.DataFrame(data)
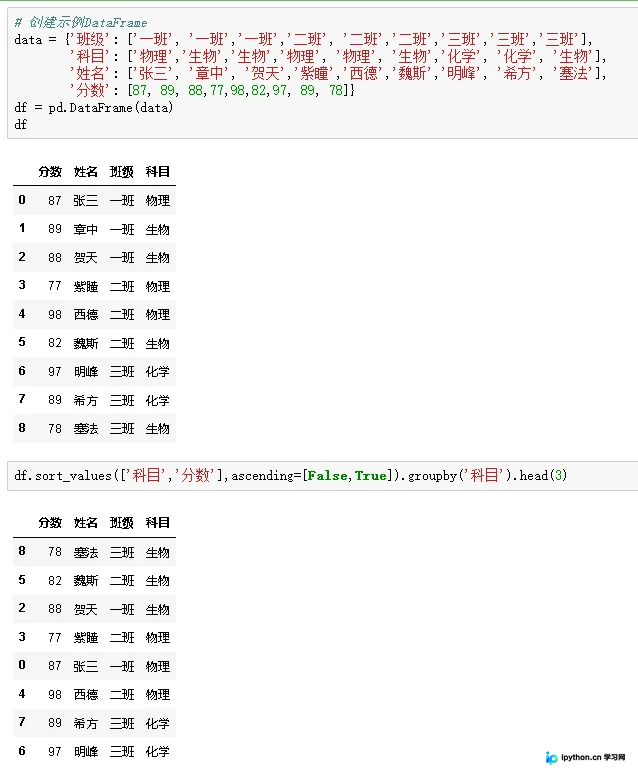
#实现组内排序,排序的时候,科目作为第一排序依据,用来排序的数值字段(分数)作为第二排序依据
df.sort_values(['科目','分数'],ascending=[False,True]).groupby('科目').head(3)
1.2 按照多列进行分组统计 df.groupby([‘列名1’,‘列名2’]).count()
# 创建示例DataFrame
data = {'班级': ['一班', '一班','一班','二班', '二班','二班','三班','三班','三班'],
        '科目': ['物理','生物','生物','物理', '物理', '生物','化学', '化学', '生物'],
        '姓名': ['张三', '章中', '贺天','紫瞳','西德','魏斯','明峰', '希方', '塞法'],
        '分数': [87, 89, 88,77,98,82,97, 89, 78]}
df = pd.DataFrame(data)
#按照科目、班级进行分组求平均
df[['科目','班级','分数']].groupby(['科目','班级']).mean()
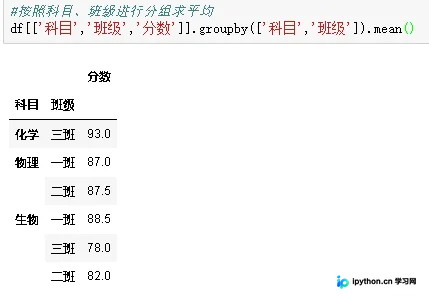
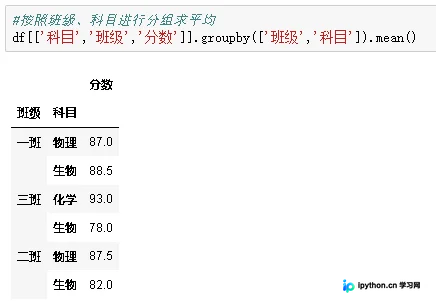
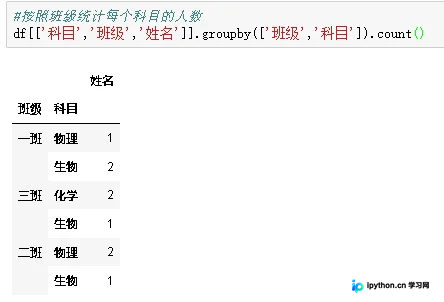
1.3 分组填充缺失值 df.groupby(‘需填充列名’).apply(lambda x:x.fillna(x.mean()))
# 创建示例DataFrame
data = {'年级': ['1', '1','1','2', '2','3','3','3','3'],
        '姓名': ['张三', '章中', '贺天','紫瞳','西德','魏斯','明峰', '希方', '塞法'],
        '年龄': [17, 19, np.NaN,18,np.NaN,15,18, 18,np.NaN ]}
df = pd.DataFrame(data)
df
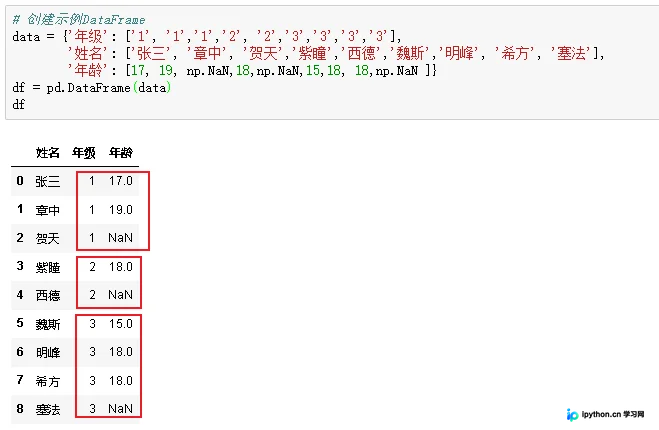
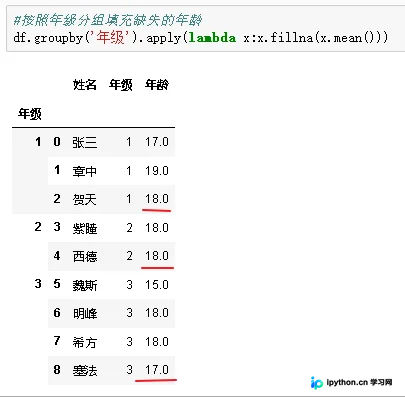
#按照年级分组填充缺失的年龄
df.groupby('年级').apply(lambda x:x.fillna(x.mean()))
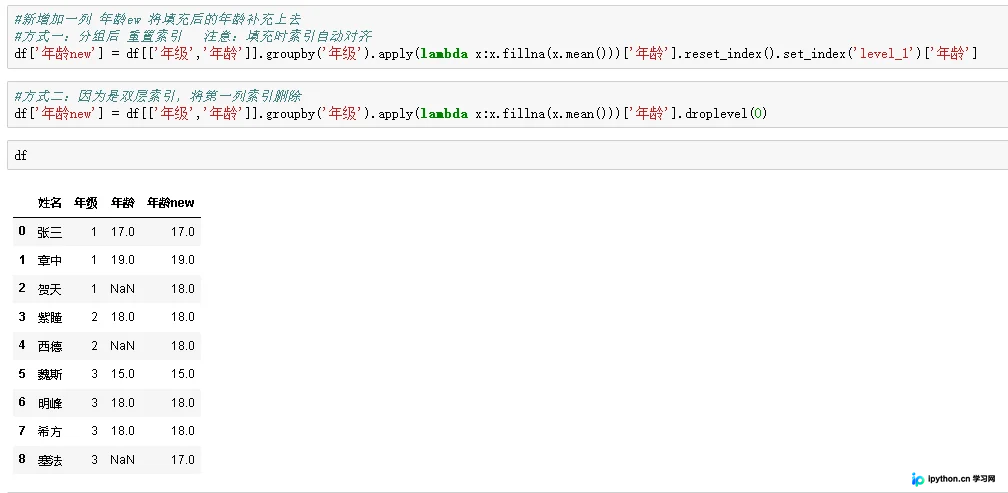
新增加一列 年龄ew 将填充后的年龄补充上去
2 分组运算 agg
数据聚合(agg):指从数组生成标量值的数据转换过程。常见的聚合运算可通过相关统计函数快速实现,同时也支持自定义聚合逻辑。
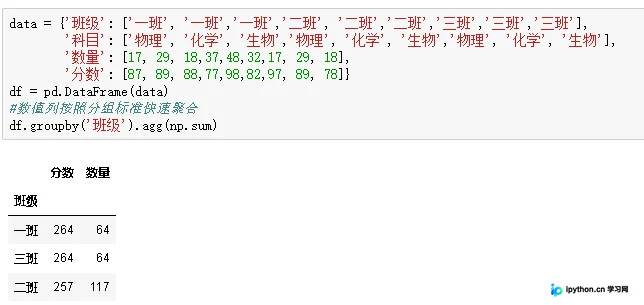
2.1 传入标准函数 df.groupby(‘班级’).agg(np.sum)
data = {'班级': ['一班', '一班','一班','二班', '二班','二班','三班','三班','三班'],
        '科目': ['物理', '化学', '生物','物理', '化学', '生物','物理', '化学', '生物'],
        '数量': [17, 29, 18,37,48,32,17, 29, 18],
        '分数': [87, 89, 88,77,98,82,97, 89, 78]}
df = pd.DataFrame(data)
#数值列按照分组标准快速聚合
df.groupby('班级').agg(np.sum)
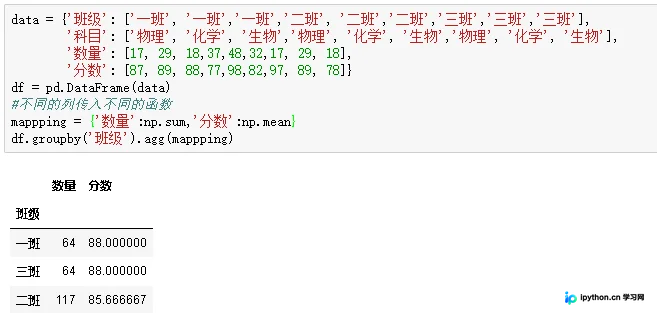
2.2 不同的列不同的聚合函数 df.groupby(‘班级’).agg({‘数量’:np.sum,‘分数’:np.mean})
#不同的列传入不同的函数
mappping = {'数量':np.sum,'分数':np.mean}
df.groupby('班级').agg(mappping)
2.3 自定义函数
#求针对各科目最高分数与最低分数之间的差值
def cha(x):
    return x.max() - x.min()
df[['科目','分数']].groupby('科目').agg([cha])
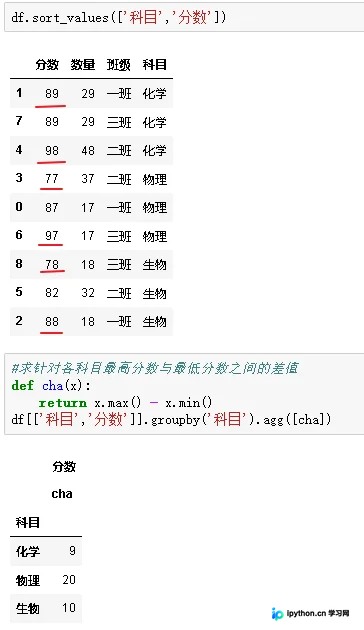
2.4 调用多个聚合函数
df[['班级','分数']].groupby('班级').agg([np.max,np.min,np.mean])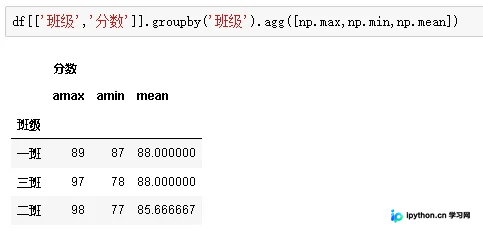
3 数据透视表
3.1 透视表 pivot_table
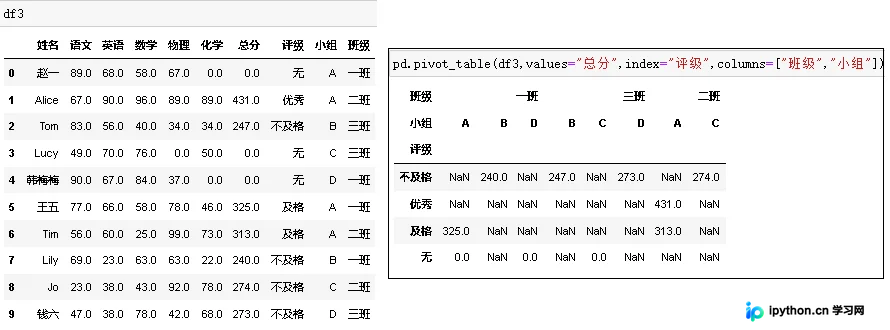
透视表(pivot table):根据一个或多个键值对数据进行聚合,依据行或列的分组键将数据划分到各个区域中。
#pivot_table 其实就是将groupby封装起来了
df[['班级','分数']].pivot_table(index = ['班级']) #先按照班级分组,再求mean
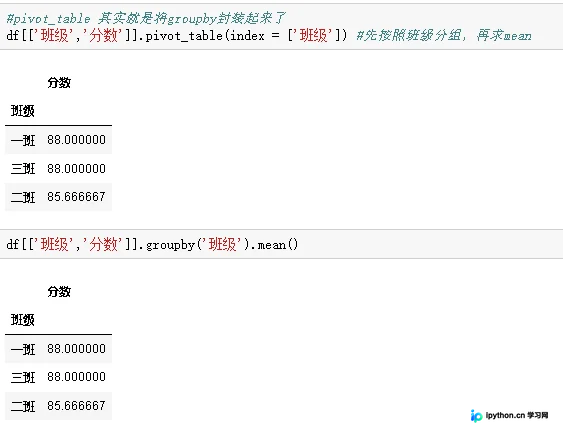
data = {'班级': ['一班', '一班','一班','二班', '二班','二班','三班','三班','三班'],
        '科目': ['物理', '化学', '生物','物理', '化学', '生物','物理', '化学', '生物'],
        '数量': [17, 29, 18,37,48,32,17, 29, 18],
        '分数': [87, 89, 88,77,98,82,97, 89, 78]}
df = pd.DataFrame(data)
df.pivot_table(index = ['班级','科目']) #先按照班级然后按照科目分许,默认求均值
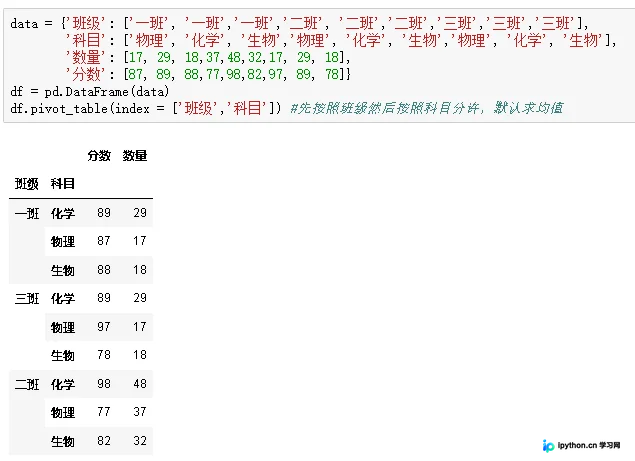
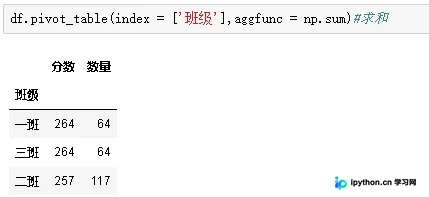
df.pivot_table(index = ['班级'],aggfunc = np.sum)#求和
pd.pivot_table(df3,values="总分",index="评级",columns=["班级","小组"])
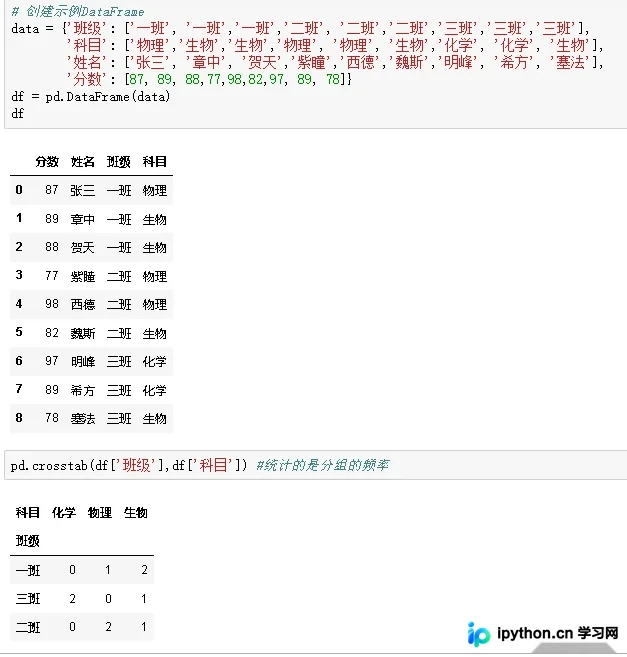
3.2 交叉表 crosstab
交叉表(crosstab):用于统计分组频率的特殊透视表。
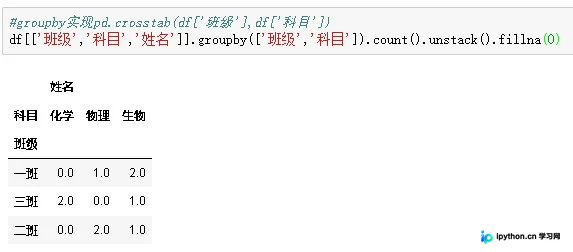
#groupby实现pd.crosstab(df['班级'],df['科目'])
df[['班级','科目','姓名']].groupby(['班级','科目']).count().unstack().fillna(0)
总结
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









