

Python Pandas数据清洗实战:合并、转换、过滤与排序详解

本文深入讲解Python Pandas库在数据清洗中的核心操作。涵盖merge函数的多种连接方式(inner, outer, left, right)及列名指定;介绍combine_first处理重叠数据的方法;详解数据重塑与轴向旋转;演示删除重复行、替换值及分段统计(cut/qcut);最后解析随机排列与采样技巧,助力高效数据预处理。
此前我们已介绍了Pandas的基础操作,本文将进一步深入探讨数据处理的进阶技巧。数据清洗作为数据分析流程中至关重要的一环,其质量直接决定了后续分析结果的可靠性。
数据合并
在Pandas库中,可以使用merge函数来实现不同数据源之间的合并操作。
import numpy as np
import pandas as pd
data1 = pd.DataFrame({'level':['a','b','c','d'],
         'numeber':[1,3,5,7]})

data2=pd.DataFrame({'level':['a','b','c','e'],
         'numeber':[2,3,6,10]})
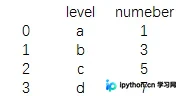
print(data1)
执行结果如下:
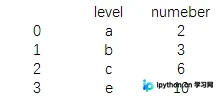
print(data2)
输出结果为:
print(pd.merge(data1,data2))
最终输出为:
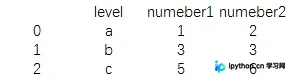
观察上述结果可知,data1和data2中拥有相同标签的字段被保留显示,而其他不匹配的字段则被舍弃。这一行为逻辑等同于SQL语句中的inner join(内连接)操作。此外,Pandas还支持outer(外连接)、right(右连接)和left(左连接)等多种连接模式,这些均通过how参数进行指定。
data3 = pd.DataFrame({'level1':['a','b','c','d'],
         'numeber1':[1,3,5,7]})
data4=pd.DataFrame({'level2':['a','b','c','e'],
         'numeber2':[2,3,6,10]})
print(pd.merge(data3,data4,left_on='level1',right_on='level2'))
运行结果如下:
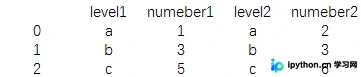
当两个数据框的列名不一致时,可以通过指定left_on和right_on参数,明确指定用于连接的列,从而将数据成功连接在一起。
print(pd.merge(data3,data4,left_on='level1',right_on='level2',how='left'))
执行结果如下:
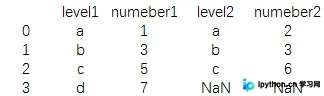
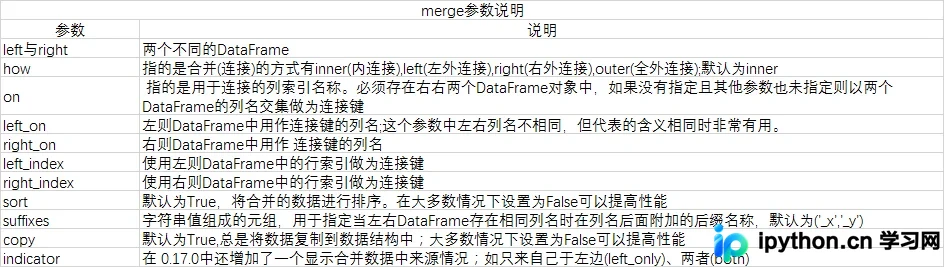
关于该函数的其他详细参数说明,请参考官方文档。
重叠数据合并
在实际场景中,有时会遇到数据重叠需要合并的情况。此时,可以使用combine_first函数来处理此类问题。
data3 = pd.DataFrame({'level':['a','b','c','d'],
         'numeber1':[1,3,5,np.nan]})
 data4=pd.DataFrame({'level':['a','b','c','e'],
         'numeber2':[2,np.nan,6,10]})
 print(data3.combine_first(data4))
运行结果如下:
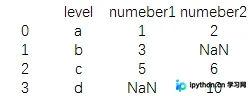
从结果可以看出,在相同标签下,系统优先显示data3的内容。如果某个数据框中的特定数据存在缺失值(NaN),另一个数据框中对应的元素便会自动填补空缺。
这种用法在逻辑上类似于np.where(isnull(a), b, a)的条件判断表达式。
数据重塑和轴向旋转
这一部分内容在之前的Pandas文章中也曾提及。数据重塑主要依赖于reshape函数,而轴向旋转则主要通过unstack和stack两个函数来实现。
data=pd.DataFrame(np.arange(12).reshape(3,4),
       columns=['a','b','c','d'],
       index=['wang','li','zhang'])
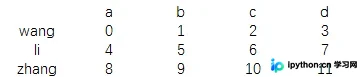
print(data)
运行结果如下:
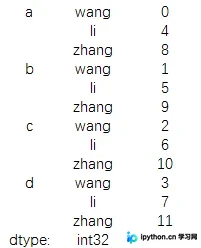
print(data.unstack())
输出结果为:
数据转换
删除重复行数据
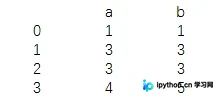
data=pd.DataFrame({'a':[1,3,3,4],
       'b':[1,3,3,5]})
print(data)
运行结果如下:
print(data.duplicated())
最终输出为:
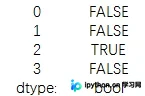
分析结果可见,第三行数据与第二行完全重复,因此对应的布尔值为True。
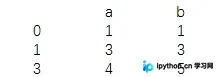
另外,还可以使用drop_duplicates方法来直接去除重复的行数据。
print(data.drop_duplicates())
运行结果如下:
替换值
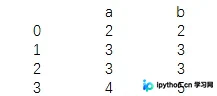
除了前文提到的fillna方法外,还可以使用replace方法进行值替换,这种方式通常更加简单快捷。
data=pd.DataFrame({'a':[1,3,3,4],
       'b':[1,3,3,5]})
print(data.replace(1,2))
运行结果如下:
实现多个值的批量替换
print(data.replace([1,4],np.nan))
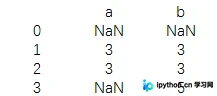
数据分段
data=[11,15,18,20,25,26,27,24]
bins=[15,20,25]
print(data)
print(pd.cut(data,bins))
运行结果如下: [11, 15, 18, 20, 25, 26, 27, 24][NaN, NaN, (15, 20], (15, 20], (20, 25], NaN, NaN, (20, 25]] Categories (2, object): [(15, 20] < (20, 25]]
从分段结果可以看出,未落入指定分段区间的数据显示为NaN值,而落入区间的数据则显示其所属的分段标签。
print(pd.cut(data,bins).labels)
运行结果如下:
输出结果为:[-1 -1 0 0 1 -1 -1 1]
显示所在分段的排序标签
print(pd.cut(data,bins).levels)
运行结果如下:
Index([‘(15, 20]', ‘(20, 25]'], dtype='object')
显示所有分段的标签
print(value_counts(pd.cut(data,bins)))
运行结果如下:
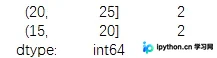
统计每个分段中数值的个数
此外,还有一个qcut函数可用于对数据进行四分位切割,其用法与cut函数类似。
排列和采样
我们知道排序有多种方法,例如sort、order、rank等函数均可对数据进行排序。这里要介绍的是对数据进行随机排序(permutation)的功能。
data=np.random.permutation(5)
print(data)
运行结果如下:
输出结果为:[1 0 4 2 3]
这里的permutation函数对0到4的数据进行了随机排序。此外,该功能也可用于数据采样。
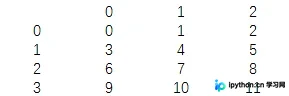
df=pd.DataFrame(np.arange(12).reshape(4,3))
samp=np.random.permutation(3)
print(df)
运行结果如下:
print(samp)
最终输出为:[1 0 2]
print(df.take(samp))
运行结果如下:
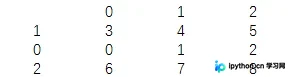
使用take函数的结果是,按照samp指定的顺序从df中提取相应的样本数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









