

使用Pandas与Matplotlib绘制箱线图并标注异常值
本文演示如何利用Pandas读取Excel数据并生成箱线图,结合Matplotlib对识别出的异常值进行坐标提取与可视化标注。通过具体代码示例,展示从数据加载、绘图配置到异常值注释的完整流程,帮助开发者快速掌握异常值分析的实现方法。
2026-10-13
6

本文演示如何利用Pandas读取Excel数据并生成箱线图,结合Matplotlib对识别出的异常值进行坐标提取与可视化标注。通过具体代码示例,展示从数据加载、绘图配置到异常值注释的完整流程,帮助开发者快速掌握异常值分析的实现方法。
本文通过创建10万条数据的测试表,分别模拟无索引和有索引两种场景,使用Profiling工具精确测量MySQL中DISTINCT与GROUP BY的执行耗时。测试表明,在建立索引后两者执行极快,但综合来看GROUP BY始终略优于DISTINCT,推荐在实际开发中优先选用GROUP BY以提升查询效率。
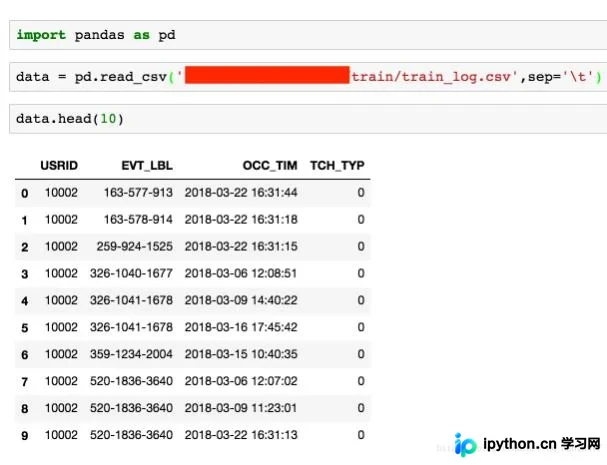
本文详解在pandas中将时间数据转换为timestamp的两种场景:未解析的时间字符串和已解析的日期对象。通过time模块的strptime、mktime及timetuple方法,展示具体的代码实现步骤与参数用法,帮助开发者高效处理时间序列数据。
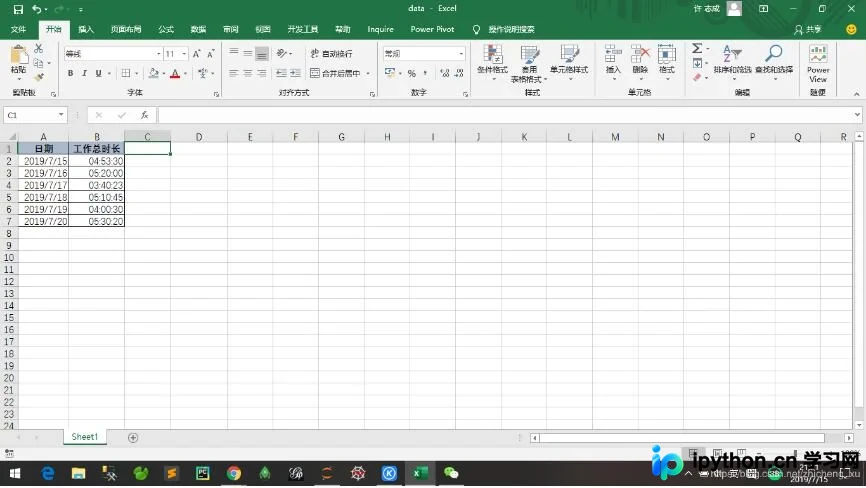
本文介绍在Python中将数据库导出的hh:mm:ss格式数据转换为秒数的两种方法。针对字符串类型,通过split分割并计算总秒;针对时间类型,利用datetime模块提取时分秒进行转换。结合Pandas示例,展示如何根据字段实际类型选择合适函数,实现高效数据清洗。
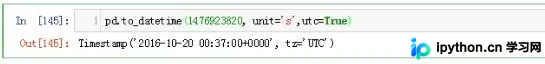
本文介绍如何使用Pandas将Unix时间戳转换为标准时间,并解决时区差异问题。默认转换结果为GMT时间,需手动添加8小时以适配北京时间。对比Python内置time模块的自动时区处理,本文提供了在Pandas中手动修正时区的具体方法,帮助开发者准确处理时间数据。
本文详细介绍如何使用Pandas库处理Unix时间戳数据。通过读取CSV文件、转换整数时间为datetime对象,并进行数据筛选与排序,展示高效的时间数据处理流程。适用于需要处理系统日志或历史数据场景的开发者,提供完整的代码示例与关键步骤解析。
本文介绍如何利用Pandas库中Series对象的内置绘图功能直接生成二维曲线图。该方法底层调用matplotlib,但简化了数据对象处理流程,特别适合已使用Series结构的数据分析场景。通过示例代码展示如何快速创建并显示图像,提升开发效率。
本文详解Python中利用WindPy库通过wsd函数批量获取资产收盘价格的方法。重点解析资产列表传入、日期格式处理(字符串与数字串)、缺失值nan显示及空参数表示,并提供将Wind返回的instance对象转换为标准DataFrame的两种代码实现方案,适用于量化数据预处理。
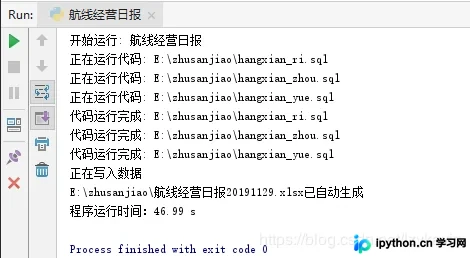
本文介绍利用Python实现固定报表的自动化生成。通过多线程并发执行Oracle SQL查询,解决Excel写入冲突;使用xlwings和Pandas将结果写入指定模板并生成带日期命名的新文件。集成logging记录日志,并结合try...except实现错误自动重试,确保报表生成的稳定性与效率。
本文介绍如何在Python中检查数据是否存在缺失值,并通过布尔结果判断特征完整性。同时讲解使用dropna函数删除缺失值的操作,重点说明axis=0删除行与axis=1删除列的区别,通常建议删除行以保留变量完整性。
本文详细讲解如何在Python的Pandas库中实现DataFrame与NumPy数组(np.array)之间的相互转换。通过展示具体的代码片段,分别说明了利用.values属性将DataFrame转为数组,以及使用pd.DataFrame()构造函数将数组还原为DataFrame的方法,帮助开发者快速掌握数据格式转换技巧。
本文详解Python中pandas库Series对象的rank()函数用法。通过实例展示如何对向量数据进行排名,重点解释默认模式下相同数值的排名处理机制:即取最小排名后的平均值。文章包含代码示例及输出结果分析,帮助开发者理解数值排序与去重排名的具体逻辑。