

Python Pandas DataFrame 新增列的两种常用方法
本文介绍在 Python Pandas 中为 DataFrame 新增数值列的两种核心方法。通过示例演示如何直接赋值生成单列数据,以及使用 concat 函数按轴拼接已有数据列。涵盖从创建初始 DataFrame 到输出最终结果的完整流程,帮助开发者快速掌握数据框结构扩展技巧。
2026-10-13
10

本文介绍在 Python Pandas 中为 DataFrame 新增数值列的两种核心方法。通过示例演示如何直接赋值生成单列数据,以及使用 concat 函数按轴拼接已有数据列。涵盖从创建初始 DataFrame 到输出最终结果的完整流程,帮助开发者快速掌握数据框结构扩展技巧。
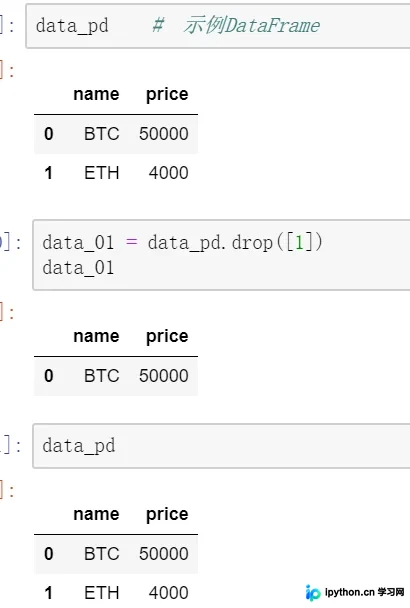
本文深入解析Python中Pandas库在处理数据结构时的内存复制机制。通过具体示例说明,当对DataFrame进行删除行等操作时,默认会在新的内存区域生成副本以保护原始数据。文章探讨了如何通过设置参数直接修改原数据,并引出Python中赋值与深浅复制的广泛概念,帮助开发者理解数据安全性与内存优化的平衡。
本文详细介绍Python中Pandas库的核心功能,涵盖Series与DataFrame的创建、数据查看与筛选、行列操作、数据合并及缺失值处理。通过具体代码示例,帮助开发者快速掌握关系型数据的整理、分析与建模技巧,适用于金融、统计及工程领域。
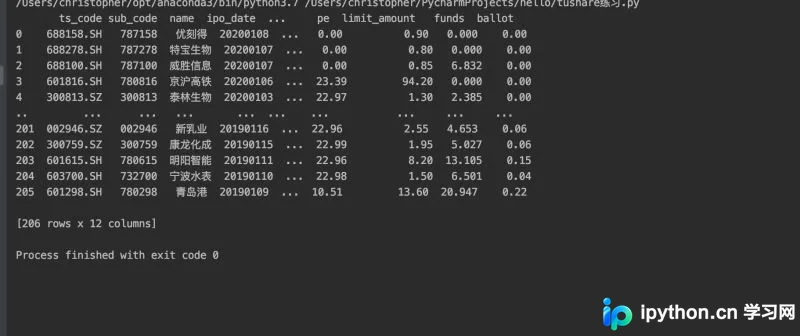
在Python开发中,当输出内容过多时,PyCharm控制台常以省略号截断显示。本文介绍如何通过pandas库的set_option方法,调整display.max_columns和display.max_rows参数,强制显示所有列和行,从而解决输出内容不完整的问题,确保数据查看的完整性。
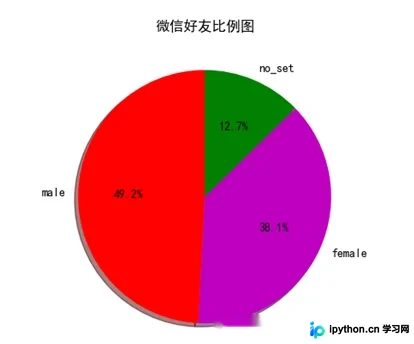
本文介绍如何利用Python的wxpy库获取微信好友数据,并通过pandas和pyecharts进行性别、地域分布的可视化分析。同时结合jieba分词与wordcloud库生成好友个性签名词云,直观展示社交网络特征。
本文详细介绍SQL Server中利用GROUP BY子句进行数据汇总的五种实战技巧。涵盖单列与多列分组、结合WHERE预处理过滤、处理NULL值特性、在分组中使用表达式,以及通过HAVING子句对聚合结果进行二次过滤。配合AdventureWorks示例代码,帮助开发者高效完成复杂报表统计需求。
本文详解pandas中计算相关系数与协方差的核心方法。通过实例演示如何使用pct_change计算百分比变化,利用corr和cov计算列间相关性与协方差矩阵,并讲解DataFrame与Series间的对齐计算规则及axis参数的应用,帮助开发者掌握数据统计分析基础。
本文介绍在 Pandas 中调整 DataFrame 列顺序的两种常用方法。通过操作列名列表或使用 insert 函数,可以将特定列(如 Mid)移动至第一列。示例展示了从读取 CSV 文件到重新排列列并保存结果的完整流程,适用于数据预处理和特征工程场景。
本文介绍pandas中DataFrameGroupBy对象的agg方法,演示如何对分组数据执行聚合操作。涵盖对每一行使用agg、多列应用多个聚合函数以及单列指定聚合函数的具体代码示例,帮助开发者掌握灵活的数据聚合技巧。
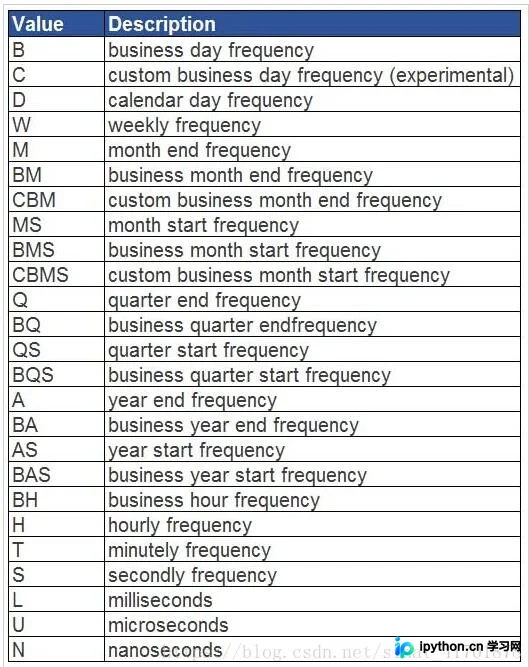
本文介绍如何利用 pandas 的 resample 方法对时间序列数据进行聚合处理。通过设置 datetime 索引,演示按年、月、日及自定义频率(如周、季度)提取数据,并结合 sum 与 fillna 实现具体列的汇总与缺失值填充,提供完整的代码示例供参考。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵以标识缺失位置。进一步结合any()和sum()方法,展示如何快速判断哪些列包含缺失值并统计每列缺失值的数量,帮助开发者高效处理数据清洗工作。
本文介绍在Python Pandas中处理DataFrame NaN值的方法。通过示例展示如何合并数据产生NaN,并使用where方法结合notnull()将NaN替换为None或其他指定值,帮助开发者进行数据清洗。