

MySQL中DISTINCT与GROUP BY性能对比实测

在实际开发中,开发者常需要在去重(DISTINCT)与分组聚合(GROUP BY)之间做选择。本文基于MySQL环境,通过构建10万行数据测试集,在无索引与有索引两种条件下对二者进行量化对比。结果表明,虽然加索引后差异微小,但在任意状态下,GROUP BY的执行效率均稳定优于DISTINCT。
测试环境与准备
为了获得具有参考意义的性能数据,我们需要在一个受控的环境中搭建测试基准。以下是具体的环境设置、表结构定义以及数据填充过程。
第1步:构建测试表
目的:创建一个包含基础ID和数值字段的测试表,用于后续的性能压测。
- 入口:MySQL命令行客户端或可视化工具(如Navicat、DBeaver)。
- 动作:执行以下建表语句。该表使用MyISAM引擎,字符集为utf8,主键为自增id。
CREATE TABLE `test_test` (
 `id` int(11) NOT NULL auto_increment,
 `num` int(11) NOT NULL default '0',
 PRIMARY KEY (`id`)
 ) ENGINE=MyISAM DEFAULT CHARSET=utf8 AUTO_INCREMENT=1;
第2步:生成百万级测试数据
目的:注入足够体量的数据,以消除单次查询微小的波动,确保测试结果具备统计学意义。
- 入口:存储过程定义界面或SQL编辑区。
- 动作:编写并执行存储过程。该过程会向表中插入指定数量的记录,`num`字段填充随机整数。
create procedure p_test(pa int(11))
begin
declare max_num int(11) default 100000;
declare i int default 0;
declare rand_num int;
select count(id) into max_num from test_test;
while i < pa do
if max_num < 100000 then
select cast(rand()*100 as unsigned) into rand_num;
insert into test_test(num) values(rand_num);
end if;
set i = i +1;
end while;
end- 关键参数:调用时将 `pa` 设为
100000。 - 完成状态:
call p_test(100000); 第3步:开启精细化监控
目的:常规图形界面显示的毫秒级误差难以区分极短时间的查询差异,需启用MySQL Profiler获取更精确的执行时间。
- 入口:SQL会话窗口。
- 动作:激活性能分析功能。
SET profiling=1;无索引情况下的性能表现
在未对查询字段建立任何辅助索引的前提下,数据库需要对全表数据进行扫描和内存排序去重。
第4步:执行无索引对比查询
目的:观察底层全表扫描模式下,DISTINCT与GROUP BY的资源消耗差异。
- 入口:SQL编辑器。
- 动作:依次执行两条去重查询,并立即查看Profile报告。
SELECT DISTINCT num FROM test_test;
SELECT num FROM test_test GROUP BY num;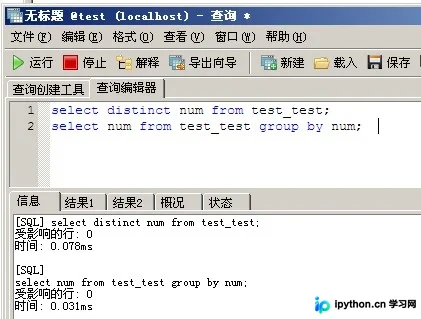
- 可观察结果:
DISTINCT耗时约为0.078ms。GROUP BY耗时约为0.031ms。
即使在此规模下,不加索引时,两者的绝对耗时都极短,但 GROUP BY 的速度已经呈现出明显的优势。
添加索引后的性能提升
针对高频查询字段添加索引后,数据库可以直接利用索引树进行检索,大幅减少了磁盘IO和内存排序的开销。
第5步:创建测试字段索引
目的:为被查询字段 num 建立普通索引,观察索引对两类查询的加速效果。
- 入口:DDL操作区域。
- 动作:执行添加索引命令。
ALTER TABLE `test_test` ADD INDEX `num_index` (`num`);- 完成状态:确认执行无误,返回索引创建成功提示。
第6步:再次执行对比查询
目的:验证索引生效后的查询耗时,并使用Profiler捕捉微小延迟。
- 入口:SQL编辑器及Profiler面板。
- 动作:重复之前的查询步骤,并在最后拉取汇总视图。
SELECT DISTINCT num FROM test_test;
SELECT num FROM test_test GROUP BY num;
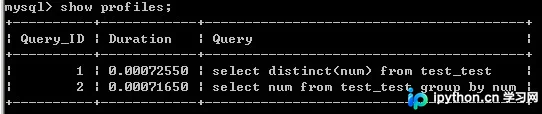
SHOW PROFILES;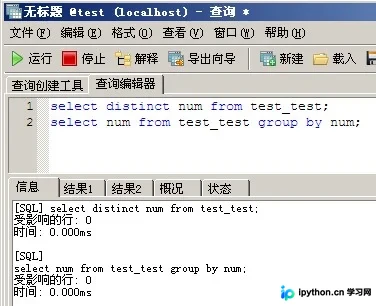
当耗时缩短至微秒级别时,图形界面的读数可能变为 0.000s,此时必须依赖 SHOW PROFILES 来查看详细数据。输出示例如下:
结论与分析
结合两次测试的数据,我们可以得出以下明确结论:
1. 索引带来的巨大收益
加上索引后,无论是哪种写法,查询速度都得到了数量级的提升。根据详细日志测算,加索引后的查询速度比无索引时提升了数十倍甚至上百倍,这印证了索引对于过滤操作的极端重要性。
2. GROUP BY 优于 DISTINCT
横向对比发现:
• **无索引时**:GROUP BY 比 DISTINCT 快约 2.5倍。
• **有索引时**:两者耗时均极短,但 PROFILE数据显示 GROUP BY 依然微弱领先 DISTINCT。
3. 最佳实践建议
在实际的项目开发与SQL编写中,如果你只需要对某一列(或多列)进行去重筛选,而不涉及其他聚合计算(如 SUM, COUNT),请尽量优先使用 GROUP BY 代替 DISTINCT。这不仅符合数据库底层优化的逻辑,也能保证在未来数据量级增长时保持更稳健的性能上限。
以上就是在MySQL中进行DISTINCT与GROUP BY性能对比测试的详细内容,更多关于MySQL优化实战的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









