

pandas设置DataFrame最大显示行列及numpy数组完整输出
本文介绍如何在pandas中通过set_option配置display.max_rows和display.max_columns来完整显示DataFrame的所有行列,避免数据被省略。同时提供numpy数组使用set_printoptions设置threshold为np.inf以实现完整打印的方法,并包含抑制科学计数法的技巧。
2026-10-13
7

本文介绍如何在pandas中通过set_option配置display.max_rows和display.max_columns来完整显示DataFrame的所有行列,避免数据被省略。同时提供numpy数组使用set_printoptions设置threshold为np.inf以实现完整打印的方法,并包含抑制科学计数法的技巧。
本文提供基于Kashgari库的Python代码,用于利用预训练Ner模型对Conll格式数据进行清洗与合并。核心逻辑包括读取原始数据,通过文本长度判断是否分块预测实体,最终将清洗后的文本与标签合并输出至目标文件,适用于需要批量处理序列标注数据的场景。
在使用 pandas 读取 CSV 文件时,默认行为会将特定字符串(如 'NA')转换为 NaN 缺失值。若需将 'NA' 视为有效数据层级而非缺失值,可通过设置 keep_default_na=False 来禁用默认转换列表。本文详解该参数的用法及注意事项,帮助开发者精准控制缺失值处理逻辑。
本文介绍了在Python Pandas中处理数据时遇到的inf和nan值问题。通过示例展示了如何使用replace方法将inf和-inf转换为nan,以避免对后续数据处理产生影响。
本文介绍Pandas库中DataFrame.rename函数的使用方法,用于重命名数据框的行索引或列名。详细解析了mapper、index、columns、axis等关键参数,对比了两种调用约定,并通过代码示例演示了字典映射与函数转换的实际效果,帮助开发者高效进行数据预处理。
本文介绍如何在pandas中从包含字符串的单元格内提取特定子串。以titanic数据集为例,演示使用str.extract方法配合正则表达式从Name列提取Title并生成新列的操作流程,帮助读者掌握基础的数据清洗技巧。
本文详解pandas中str.split方法的expand参数。当expand=True时,分割结果转换为DataFrame,每列对应一个子串;expand=False时保持Series。结合n参数可控制分割次数,示例展示不同组合下的输出差异及类型变化。
本文详解如何使用Python读取.mat文件并提取所需信息。通过scipy.io.loadmat加载文件,解析返回的字典结构,获取指定Key对应的numpy数组。随后利用pandas将多维数组转换为DataFrame格式,便于后续的数据展示与分析处理。
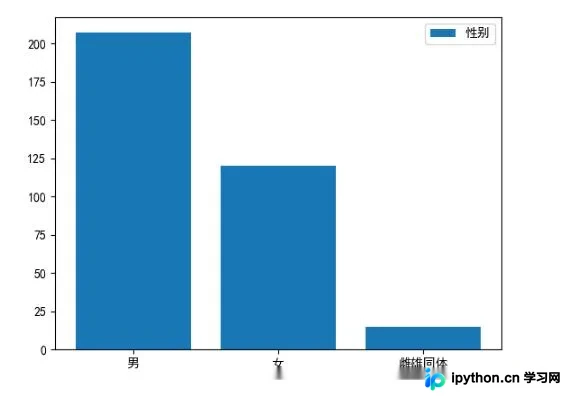
本文介绍如何利用Python的itchat库获取微信好友信息,并结合pandas、matplotlib及jieba等工具,对好友的性别、省份分布及个性签名进行统计分析。通过生成统计图表和词云图,直观展示好友数据特征,代码包含完整的数据获取、处理及可视化流程。
本文详解Pandas中groupby函数的as_index参数。默认as_index=True时,聚合结果以组标签为索引,无法直接通过整数位置访问;设置as_index=False则返回类似SQL风格的输出,保留默认整数索引。通过代码示例对比两种模式下的索引结构及取值方式,帮助开发者根据需求选择合适的输出格式。
本文深入解析Python Lambda匿名函数的核心用法,对比其与def定义函数的差异。详细讲解Lambda与map、filter、reduce及if-else条件的组合技巧,并展示在Pandas DataFrame和Series中通过apply、map及transform进行数据处理的实战案例,同时总结其优缺点,帮助开发者高效编写简洁代码。
本文介绍如何使用pandas将DataFrame直接转换为字典对象。通过dict()函数转换,生成的字典键为列名,值为对应的Series对象。文章展示了具体代码实现及输出结果,包括列名列表和值的数据类型,帮助开发者理解转换后的数据结构。