Pandas中Apply函数的核心用法与参数详解
本文深入解析Pandas库中自由度最高的Apply函数。详细讲解如何通过axis参数控制遍历方向,利用自定义函数实现行级或列级数据计算。重点演示如何结合*args和**kwds向Apply传递额外参数,以灵活处理如日期差计算等复杂逻辑,提升数据清洗效率。
2026-10-15
6

本文深入解析Pandas库中自由度最高的Apply函数。详细讲解如何通过axis参数控制遍历方向,利用自定义函数实现行级或列级数据计算。重点演示如何结合*args和**kwds向Apply传递额外参数,以灵活处理如日期差计算等复杂逻辑,提升数据清洗效率。
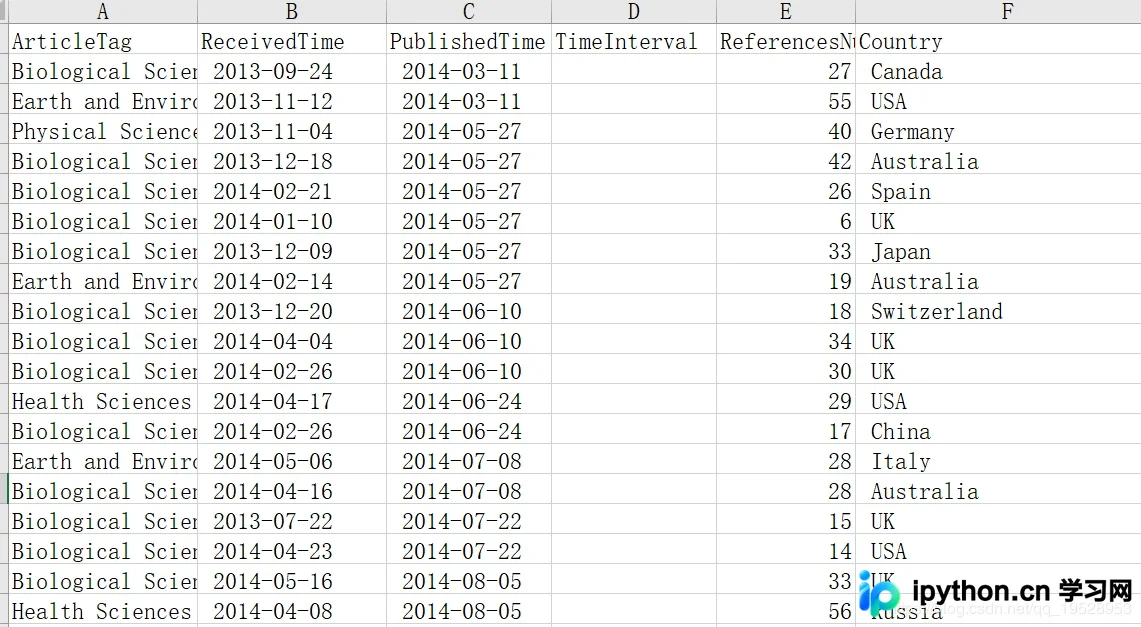
本文介绍Python中DataFrame的去重操作及如何提取重复数据。通过drop_duplicates函数,默认保留重复值,设置keep=False可去除重复值。结合concat与去重操作,可高效提取重复数据。此外,还演示了按单列或多列去重的具体方法,适用于数据分析中的常见需求。
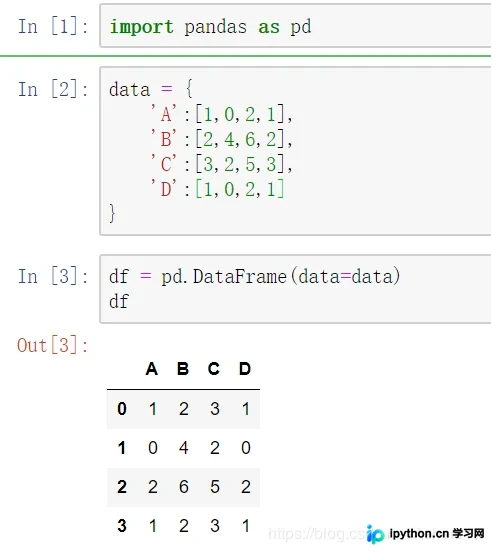
Python 凭借简洁语法广泛应用于 Web 开发、系统运维、游戏逻辑、科学计算及人工智能等领域。本文详解 Django、NumPy 等工具的实际应用,并梳理爬虫、机器学习、APP 开发等热门职业路径,助开发者明确技术选型与就业方向。
本文详细解析Python中处理数据缺失值的8种核心方法,涵盖使用dropna删除含缺失值的行列、基于阈值过滤,以及利用fillna进行常数、聚合值、前后值填充及多数据源替换。通过具体参数如how、thresh、limit和subset的讲解,帮助开发者根据数据特征选择最优策略,确保数据分析的准确性与完整性。
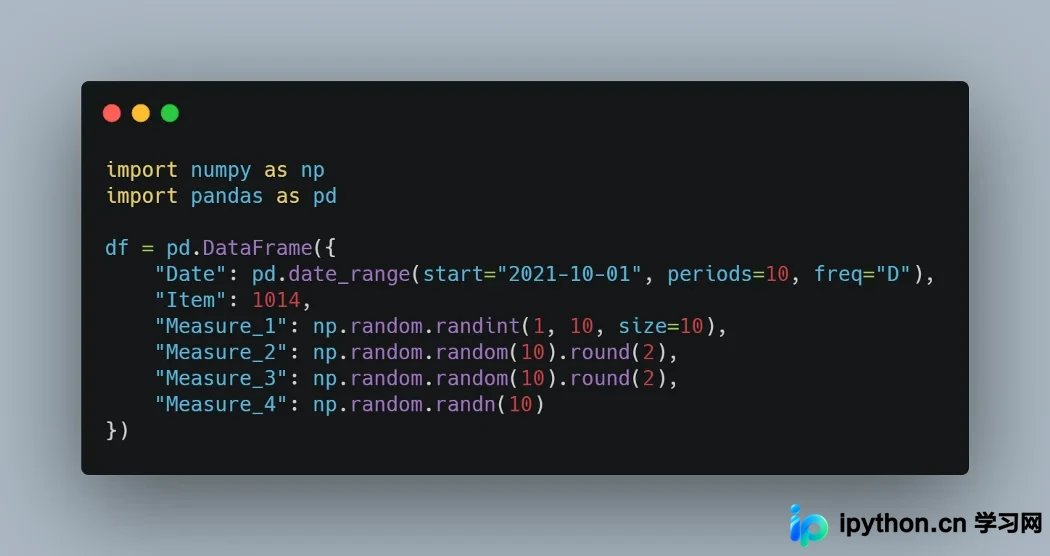
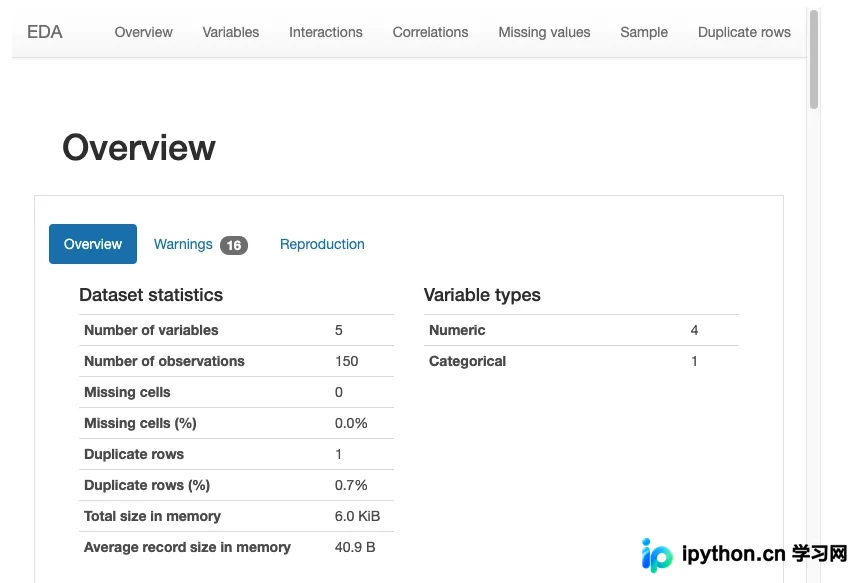
本文盘点Python数据挖掘中常用的五种AutoEDA自动化工具,包括Pandas Profiling、AutoViz、Dataprep、SweetViz和D-Tale。文章对比了各工具的功能特性、耗时情况及适用场景,帮助开发者快速选择适合的数据探索与分析方案。
本文总结并详解了 12 个用于简化 Python 数据处理的实用函数,涵盖 Numpy 和 Pandas 各 6 个。内容涉及数组索引查找、数值裁剪、条件提取、百分位计算,以及 Pandas 中的 CSV 读取优化、Series 映射、数据过滤、深拷贝、类型筛选和数据透视表生成,旨在提升数据处理效率与便捷性。
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
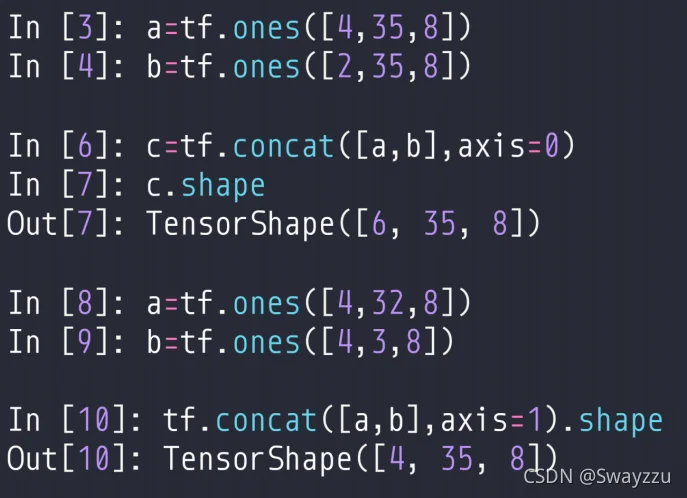
本文详解TensorFlow中数据合并与分割的核心函数,包括tf.concat、tf.split和tf.stack的维度处理规则。同时介绍数据统计操作,如tf.norm求范数、reduce系列求极值与均值,以及tf.argmax和tf.unique的使用方法与注意事项,帮助开发者掌握张量操作基础。
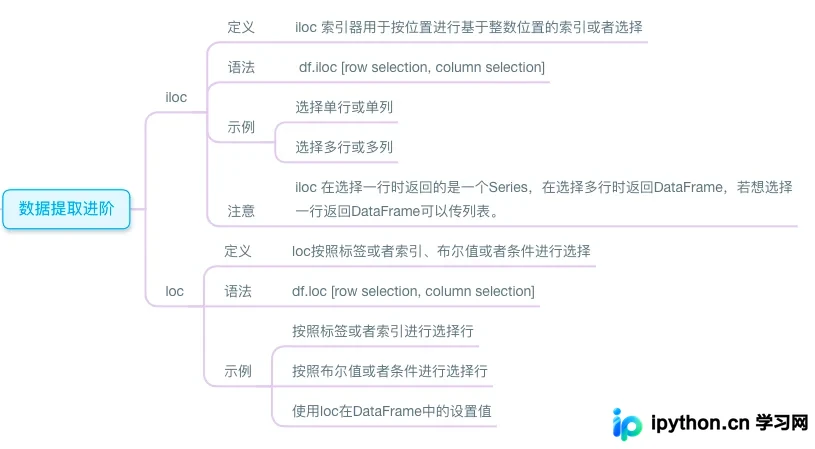
本文详解Python Pandas库中iloc和loc两种核心索引器的用法。iloc基于整数位置进行数据选取,返回Series或DataFrame;loc基于标签、索引或布尔条件进行筛选。通过具体代码示例,展示如何根据位置或标签选择单行、多列及设置值,帮助开发者高效处理数据。
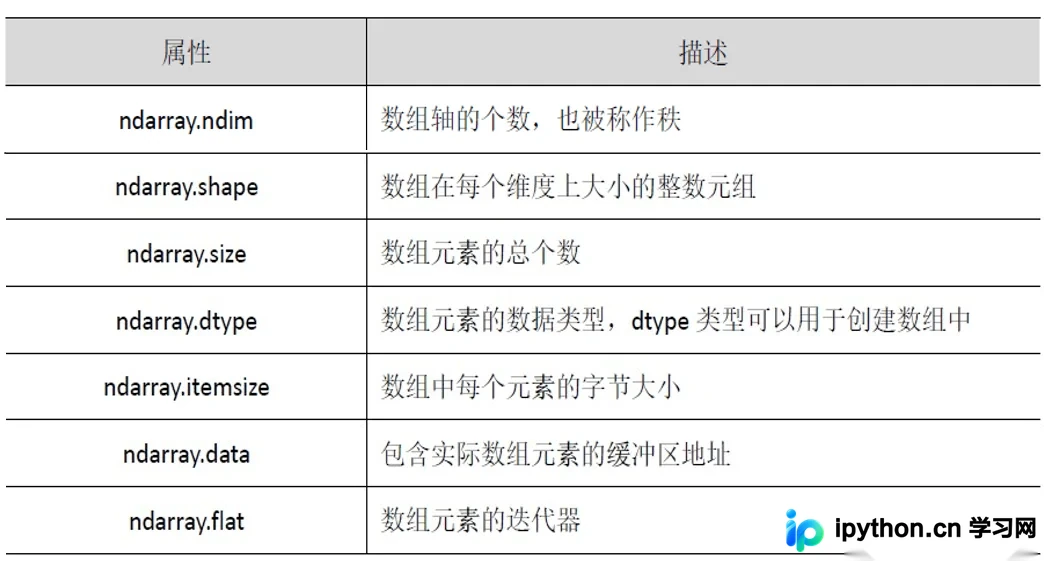
本文详解Python中Numpy库的基础应用,涵盖ndarray多维数组的创建、核心属性(ndim、shape、dtype等)解析,以及array、arange、zeros等常用创建函数的用法。同时介绍数组的索引与切片技巧,帮助读者快速掌握Numpy在数据分析中的关键操作。
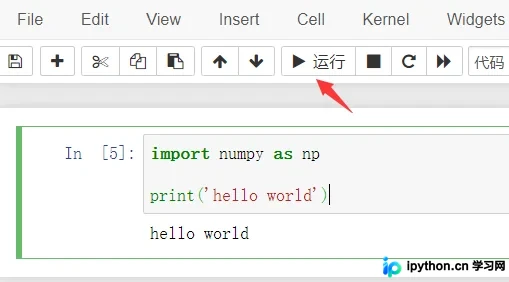
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
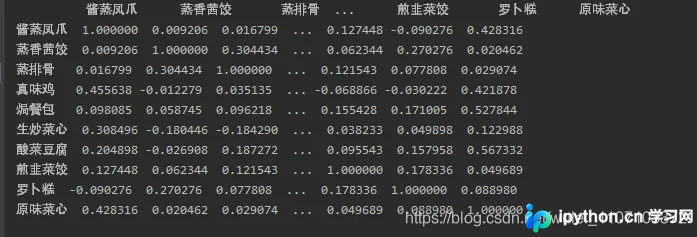
本文介绍如何在Python中使用Pandas库输出完整且对齐的表格。通过设置display.max_columns、display.width、display.max_colwidth以及unicode相关选项,解决表格显示中的省略号和列对齐问题,提升数据展示的可读性。