

Pandas中Apply函数的核心用法与参数详解

本文深入解析Pandas库中自由度最高的Apply函数。详细讲解如何通过axis参数控制遍历方向,利用自定义函数实现行级或列级数据计算。重点演示如何结合*args和**kwds向Apply传递额外参数,以灵活处理如日期差计算等复杂逻辑,提升数据清洗效率。
Pandas中最为实用的函数
Pandas中最为实用的函数
Pandas是Python语言中极其实用的数据结构库,提供了丰富的数据操作工具。许多算法库函数的输入要求或接口均依赖于pandas数据结构。
查阅Pandas的API文档可以发现,其中包含大量实用函数,例如常用的文件读写操作,具体包括以下函数:
| Format Type | Data Description | Reader | Writer |
|---|---|---|---|
| text | CSV | read_csv | to_csv |
| text | JSON | read_json | to_json |
| text | HTML | read_html | to_html |
| text | Local clipboard | read_clipboard | to_clipboard |
| binary | MS Excel | read_excel | to_excel |
| binary | HDF5 Format | read_hdf | to_hdf |
| binary | Feather Format | read_feather | to_feather |
| binary | Parquet Format | read_parquet | to_parquet |
| binary | Msgpack | read_msgpack | to_msgpack |
| binary | Stata | read_stata | to_stata |
| binary | SAS | read_sas | |
| binary | Python Pickle Format | read_pickle | to_pickle |
| SQL | SQL | read_sql | to_sql |
| SQL | Google Big Query | read_gbq | to_gbq |
数据读取完成后,针对数据处理环节存在多种有效操作函数,但笔者认为其中最具价值的函数如下:
Apply函数
Apply函数
Apply函数是`pandas`库中自由度最高的函数。其基本语法如下:
DataFrame.apply(func, axis=0, broadcast=False, raw=False, reduce=None, args=(), **kwds)
该函数最核心的部分在于第一个参数,即传入的函数,这类似于C/C++中的函数指针机制。
该函数需由用户自行定义,其传入参数取决于axis的设置。例如,当设定axis = 1时,系统会将每一行数据以Series的数据结构形式传入用户自定义的函数中。在函数内部,我们可以对Series的不同属性进行计算并返回结果。随后,apply函数会自动遍历每一行DataFrame的数据,最终将所有返回结果组合成一个Series数据结构并返回。
例如,读取一个表格文件:
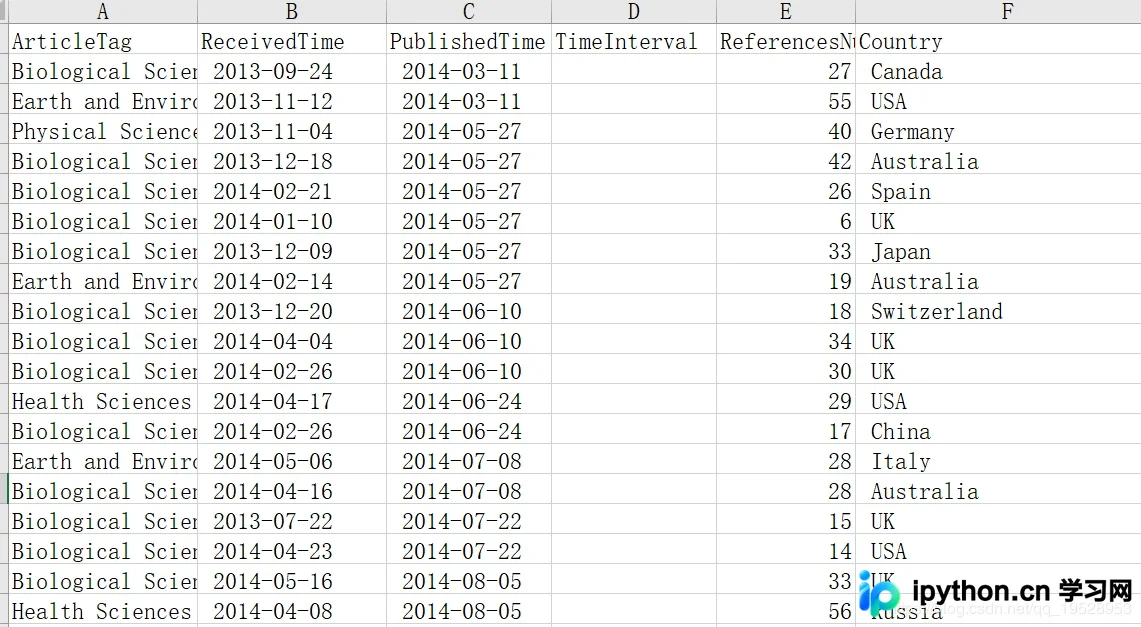
计算属性间的时间差
若需计算表格中PublishedTime与ReceivedTime属性之间的时间差,可使用以下函数实现:
import pandas as pd
import datetime  #用来计算日期差的包

def dataInterval(data1,data2):
  d1 = datetime.datetime.strptime(data1, '%Y-%m-%d')
  d2 = datetime.datetime.strptime(data2, '%Y-%m-%d')
  delta = d1 - d2
  return delta.days

def getInterval(arrLike): #用来计算日期间隔天数的调用的函数
  PublishedTime = arrLike['PublishedTime']
  ReceivedTime = arrLike['ReceivedTime']
#  print(PublishedTime.strip(),ReceivedTime.strip())
  days = dataInterval(PublishedTime.strip(),ReceivedTime.strip()) #注意去掉两端空白
  return days

if __name__ == '__main__':
  fileName = "NS_new.xls";
  df = pd.read_excel(fileName)
  df['TimeInterval'] = df.apply(getInterval , axis = 1)
向Apply函数传递额外参数
有时,我们需要向自定义函数传递额外参数。此时可利用apply函数的*args和**kwds参数。例如,对于同样的时间差计算函数,若希望动态传递时间差的标签名称,从而避免每次修改标签都需改动函数代码,实现代码如下:
import pandas as pd
import datetime  #用来计算日期差的包

def dataInterval(data1,data2):
  d1 = datetime.datetime.strptime(data1, '%Y-%m-%d')
  d2 = datetime.datetime.strptime(data2, '%Y-%m-%d')
  delta = d1 - d2
  return delta.days

def getInterval_new(arrLike,before,after): #用来计算日期间隔天数的调用的函数
  before = arrLike[before]
  after = arrLike[after]
#  print(PublishedTime.strip(),ReceivedTime.strip())
  days = dataInterval(after.strip(),before.strip()) #注意去掉两端空白
  return days


if __name__ == '__main__':
  fileName = "NS_new.xls";
  df = pd.read_excel(fileName)
  df['TimeInterval'] = df.apply(getInterval_new ,
   axis = 1, args = ('ReceivedTime','PublishedTime'))  #调用方式一
  #下面的调用方式等价于上面的调用方式
  df['TimeInterval'] = df.apply(getInterval_new ,
   axis = 1, **{'before':'ReceivedTime','after':'PublishedTime'}) #调用方式二
  #下面的调用方式等价于上面的调用方式
  df['TimeInterval'] = df.apply(getInterval_new ,
axis = 1, before='ReceivedTime',after='PublishedTime') #调用方式三修改后的getInterval_new函数增加了两个参数。在使用apply函数时,需自行传递这些参数。代码中展示了三种可行的传递方式,均能正常运行。
最后,本文涉及的全部代码可在以下网页下载:
https://github.com/Dongzhixiao/Python_Exercise/tree/master/pandas_apply
至此,关于Pandas Apply函数具体使用的介绍到此结束。如需了解更多相关Pandas Apply函数内容,请搜索本站历史文章或继续浏览后续相关文章,希望大家今后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









