

Python DataFrame去重与提取重复值详解

本文介绍Python中DataFrame的去重操作及如何提取重复数据。通过drop_duplicates函数,默认保留重复值,设置keep=False可去除重复值。结合concat与去重操作,可高效提取重复数据。此外,还演示了按单列或多列去重的具体方法,适用于数据分析中的常见需求。
引言
摘要
在数据分析过程中,对DataFrame进行去重处理是常见操作。然而,有时我们不仅需要去除重复项,还需要单独保留或提取这些重复数据。本文将简要介绍如何在DataFrame中执行去重操作,以及如何获取重复值。
构建示例数据
创建DataFrame
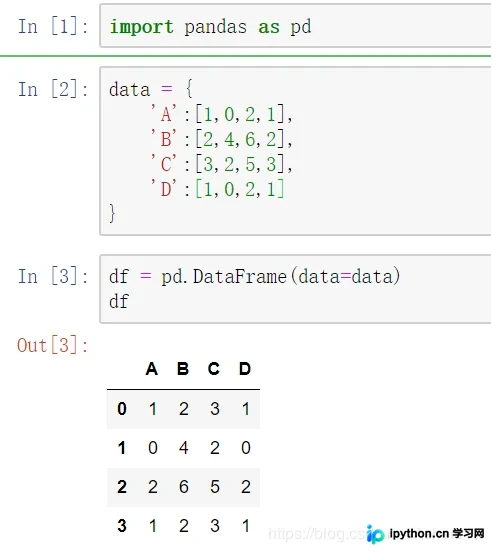
首先,我们需要构建一个包含重复行的DataFrame示例,以便后续演示去重和提取重复值的操作。
DataFrame去重操作
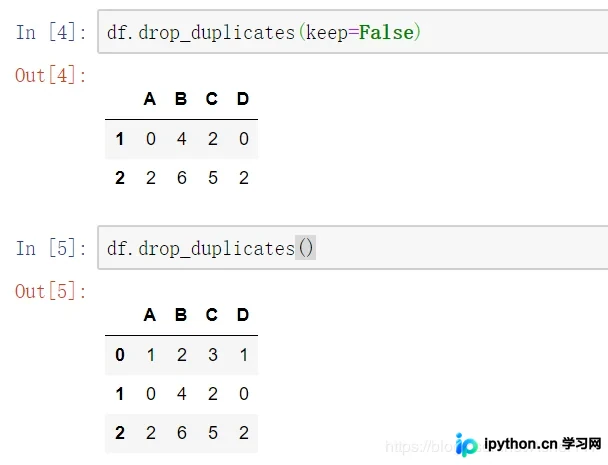
对DataFrame进行去重时,可以通过控制keep参数来调整结果。默认情况下,drop_duplicates会保留第一次出现的重复值。若希望去除所有重复项(即不保留任何重复值),只需将keep参数设置为False即可。
提取重复数据的方法
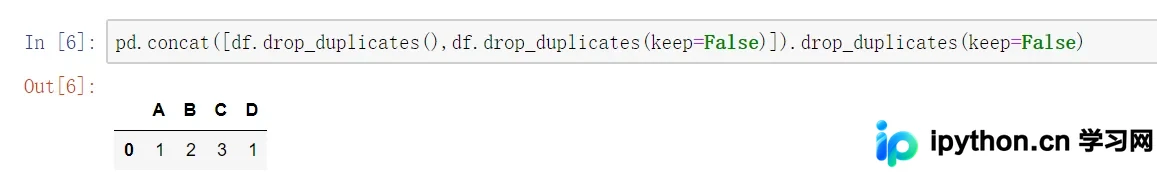
虽然常规操作侧重于去重,但在某些场景下,我们需要专门提取重复数据。实现这一目标的方法是:将保留重复值的DataFrame与去除重复值的DataFrame进行合并(concat),然后对合并后的数据再次执行去重操作且不保留重复值。这样即可筛选出原始的重复数据。
############################### 分割线:补充 ###############################
按列去重的具体应用
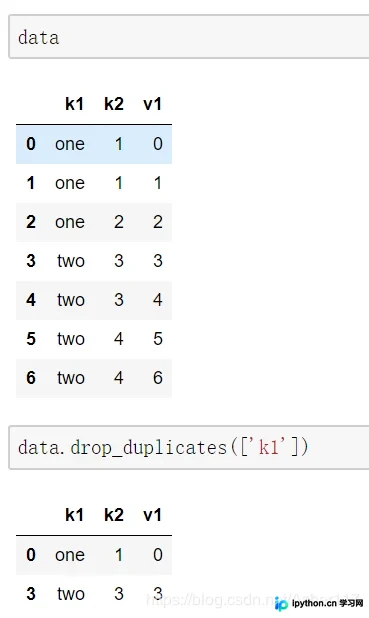
按单列去重
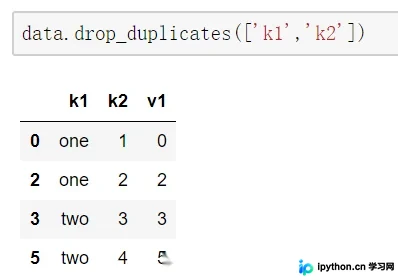
按多列去重
总结
至此,关于Python DataFrame使用drop_duplicates函数进行去重、保留重复值及提取重复值的介绍已完成。如需了解更多相关内容,建议查阅本站过往文章或继续浏览后续教程。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









