Pandas DataFrame.sample() 随机抽样详解与实战
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。
2026-10-15
6

本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。
本文介绍了在 Python 的 Pandas 库中为 DataFrame 添加列名的两种常用方法。第一种是在创建 DataFrame 时通过 columns 参数直接指定;第二种是先创建无列名的 DataFrame,再使用 columns 属性进行赋值。文章提供了具体的代码示例和运行结果,帮助开发者快速掌握相关操作技巧。
本文详解pandas库中pd.groupby()函数的用法。通过与SQL groupby对比,阐述其核心逻辑,并结合城市天气数据示例,展示如何按城市分组统计温度与风速,帮助读者掌握数据聚合技巧。
本文详细介绍Python中pandas库的pd.cut()和pd.qcut()函数在数据分箱中的应用。pd.cut用于基于指定区间的离散化,支持自定义边界和标签;pd.qcut则根据分位数生成等频箱。文章通过代码示例演示了区间开闭控制、自定义标签及精度设置等关键参数,帮助开发者掌握数据预处理中的分箱技巧。
本文详细介绍如何使用Python的pandas库通过pd.read_csv()方法读取CSV文件。内容涵盖基础读取、去除表头、自定义列名、设置索引以及指定分隔符等关键参数用法,并展示如何处理缺失数据,帮助开发者高效处理标准化数据。
本文介绍Python开源库Vaex,它利用内存映射和延迟计算技术,使笔记本电脑也能秒开100GB以上的数据集。通过纽约出租车数据的实战案例,展示了Vaex在数据清洗、统计分析及可视化方面的卓越性能,无需分布式集群即可高效处理十亿级数据。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵,isnull().any()如何识别含缺失值的列,以及isnull().sum()如何统计每列缺失值数量。结合代码示例与结果分析,帮助开发者快速掌握缺失值检测技巧。
本文详解 Python Pandas 中时间序列数据的处理流程。涵盖 time 模块基础操作、DatetimeIndex 的创建与索引技巧,以及如何利用 pd.to_datetime 清洗日期数据。通过杭州天气数据集实例,演示如何按月份聚合统计并绘制温度变化趋势图,帮助开发者掌握时序数据分析的核心技能。
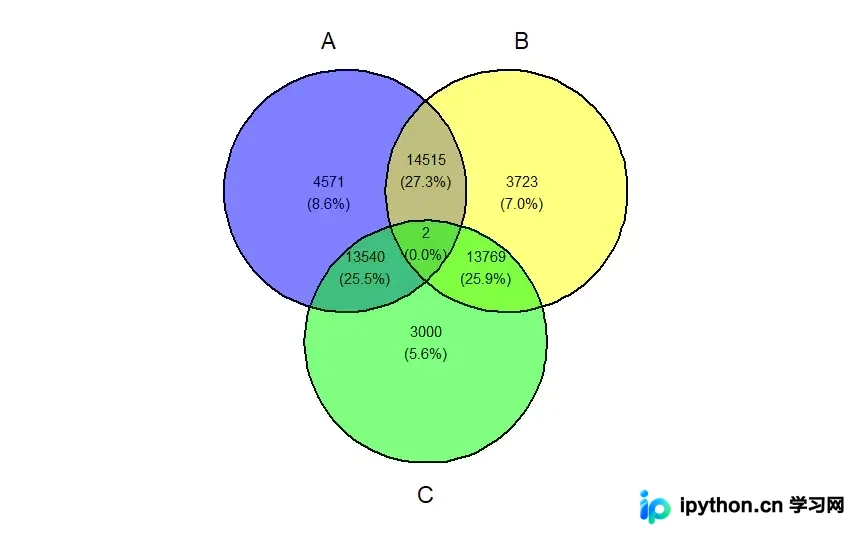
本文详解使用R语言ggvenn包绘制维恩图的方法。涵盖从CRAN安装、准备List或Dataframe格式的输入数据,到调用ggvenn()生成基础图表。重点解析fill_color、stroke_size等关键参数以实现图形美化,并演示如何提取并保存两组或多组数据的交集结果。
本文详解Pandas中8个常用的set_option配置,涵盖最大行数、列数、列宽、浮点精度、数字格式化及绘图后端等设置。通过调整display相关参数,可优化交互式数据展示效果,提升数据分析效率。
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
本文介绍如何使用Python库datacompy高效对比两个几乎相同的DataFrame,快速定位并直观展示数据差异。通过示例演示从环境安装到生成详细对比报告的全过程,帮助开发者轻松识别数据不一致之处。