

R语言ggvenn包绘制维恩图:从安装到美化与交集提取

ggvenn是基于ggplot2开发的R语言工具包,专为高效绘制美观的维恩图设计。通过简单的代码即可将集合间的特异性与共同性可视化,支持丰富的主题定制选项,满足科研论文与数据报告的高标准需求。
什么是维恩图与ggvenn
维恩图(Venn Diagram)是展示多个集合之间交集、并集及特异性的经典图表,广泛应用于生物信息学(如基因列表对比)、市场营销分析及逻辑判断等领域。相比在线绘图工具,在R中编程绘图具有可重复性强、易于批量处理和高精度出版级输出的优势。ggvenn 包继承自 ggplot2,允许用户以极简的代码实现复杂的美化效果。
第1步:环境安装
目的:获取绘制维恩图所需的依赖库。
ggvenn 已上传至 CRAN,可直接通过 R 控制台的 install.packages() 进行安装,随后加载库文件即可使用。
# 安装ggvenn包
install.packages("ggvenn")
# 加载库
library(ggvenn)
第2步:准备数据格式
目的:构建符合 ggvenn 要求的输入数据结构。
该包主要支持两种格式:List 和 Data.frame。此处以常见的三个基因集合为例,展示如何将读取的文件转化为 List 对象。
假设已存有包含基因ID的CSV文件,首先读取数据:
set1 <- read.csv("gene_a.csv")
set2 <- read.csv("gene_b.csv")
set3 <- read.csv("gene_c.csv")
接着,提取每个数据框中的目标列(假设为 gene_id),并命名创建 List:
dat <- list(
  A = set1$gene_id,
  B = set2$gene_id,
  C = set3$gene_id
)
第3步:生成基础维恩图
目的:快速查看数据分布情况。 直接传入 List 对象即可生成默认样式的图表。若只需展示部分集合,可通过第二个参数指定集合名称向量。
# 绘制全部三个集合
p1 <- ggvenn(dat)
p1

# 仅绘制A和B两个集合
p2 <- ggvenn(dat, c("A", "B"))
p2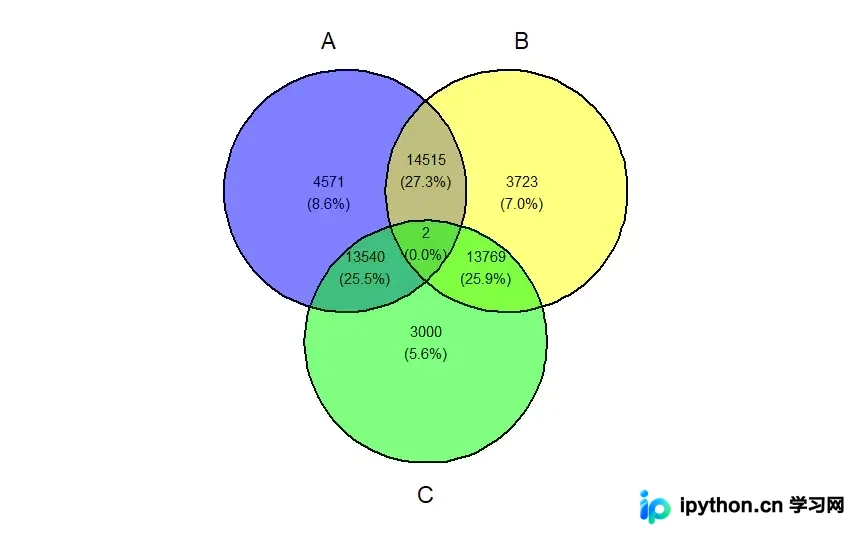
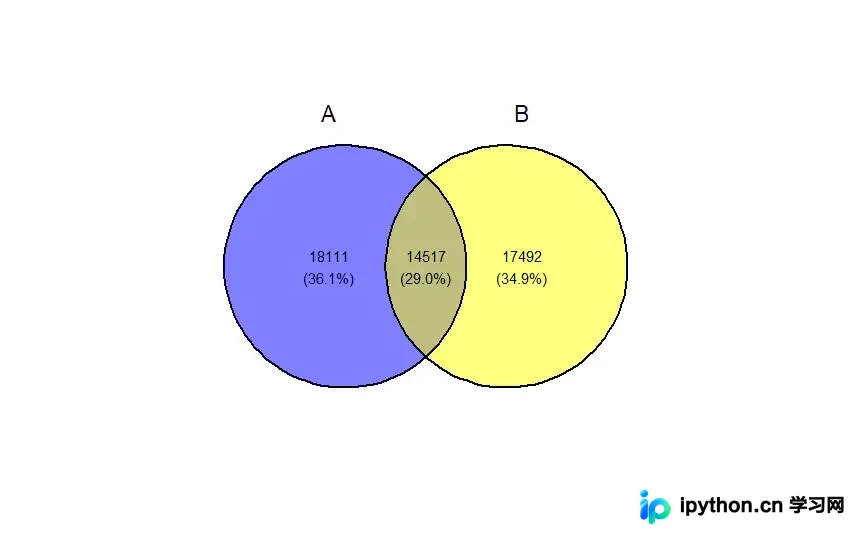
第4步:自定义图形样式(美化)
目的:提升图表的可读性与出版质量。
利用 ggvenn 提供的丰富参数,可以精细控制填充色、透明度、边框粗细及文本显示。
常用参数说明:
fill_color/fill_alpha:集合区域填充颜色与透明度。stroke_color/stroke_size/stroke_linetype:边界线条的颜色、粗细及类型。set_name_color/set_name_size:集合标签(如 A, B, C)的颜色与字号。text_color/text_size:交集内数字文本的颜色与字号。show_percentage:是否显示百分比数值。
综合应用示例:
p3 <- ggvenn(
  dat,
  show_percentage = TRUE,
  stroke_color = "white",
  stroke_size = 0.5,
  fill_color = c("#E41A1C", "#1E90FF", "#FF8C00"),
  set_name_color = c("#E41A1C", "#1E90FF", "#FF8C00"),
  set_name_size = 15,
  text_size = 6
)
p3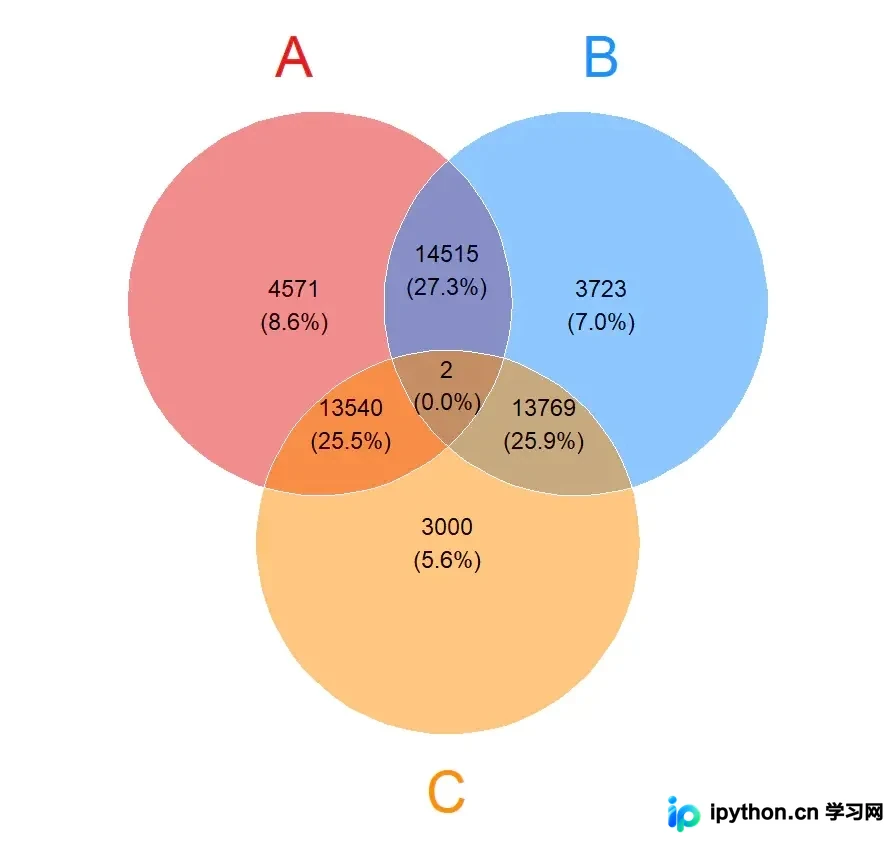
第5步:提取并保存交集数据
目的:将可视化的结果转化为可供下游分析使用的结构化数据。
绘图仅用于展示,实际研究中往往需要获取具体的交集元素(如共有基因)。可使用 R 内置函数 intersect() 计算后导出为 CSV 文件。
# 计算Set A与Set B的交集
common_genes <- intersect(set1$gene_id, set2$gene_id)

# 转换为数据框以便保存
result_df <- as.data.frame(common_genes)

# 导出为CSV,去除行名
write.csv(result_df, "A_B_common_genes.csv", row.names = FALSE)
总结
掌握 ggvenn 不仅能让数据处理流程自动化,还能通过精细化参数调整输出符合特定期刊规范的插图。对于涉及多组集合比对的分析场景,这是一套高效且专业的解决方案。
以上就是R语言ggvenn包绘制维恩图的详细教程,更多关于R语言数据分析与可视化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









