

Python机器学习scikit-learn决策树算法详解:分类、回归与多输出实现
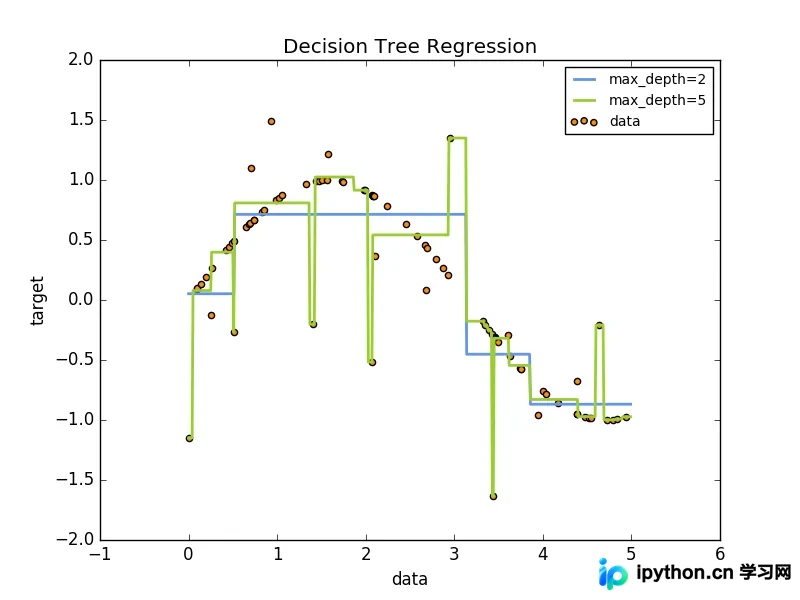
本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
2026-10-13
6

本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
本文详细介绍基于Python实现的感知机线性分类模型。内容涵盖感知机作为判别模型的基本原理,即通过输入空间中的超平面进行分类,并阐述利用梯度下降法最小化误分类损失函数的优化过程。文中提供具体代码示例及运行结果,旨在帮助开发者理解并应用这一经典分类算法。
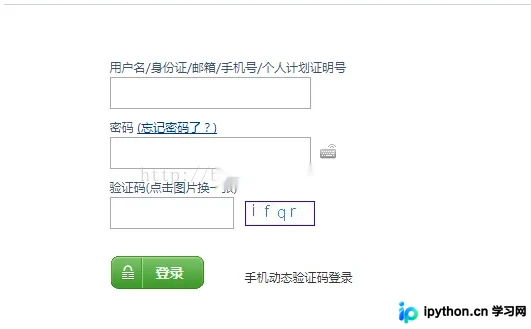
本文介绍基于Python3.5和sklearn库,利用支持向量机(SVM)算法自动识别纯字母验证码的技术方案。内容涵盖从大量样本获取、图像灰度化与二值化预处理、垂直投影法字符分割,到使用Tesseract OCR辅助标注及SVM模型训练的全过程。文中还详细解析了处理黏连字符的滴水算法及常见配置坑点,旨在为开发者提供完整的实战参考。
本文通过不到40行Python代码,详解如何构建一个简单的电影推荐系统。文章介绍了基于内容和协同过滤(用户与物品)的推荐原理,利用Pandas处理ratings.csv和movies.csv数据,通过计算皮尔逊相关系数并过滤低评分电影,实现个性化推荐。适合希望理解推荐系统底层逻辑的初学者。
本文介绍如何使用Python的sklearn库实现K近邻回归模型。通过波士顿房价数据集,演示数据预处理、标准化及模型训练流程。重点对比等权重(uniform)与不等权重(distance)两种策略在预测精度上的差异,包括均方误差和平均绝对误差的分析,帮助开发者理解不同权重设置对回归结果的影响。
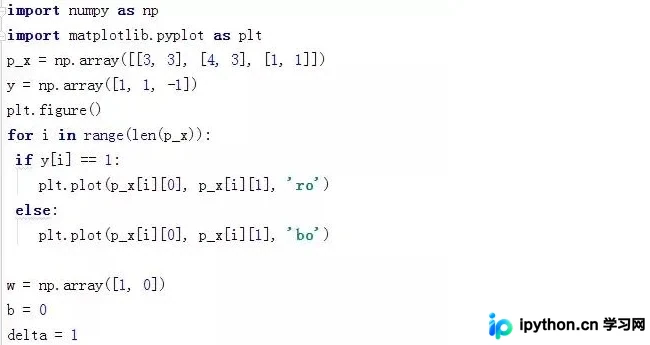
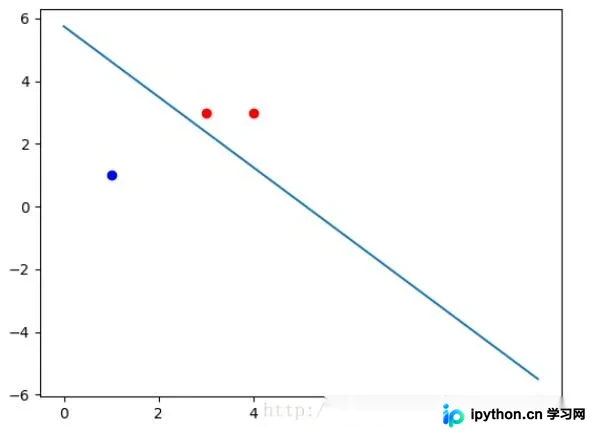
本文通过Python代码演示李航《统计学习方法》中感知机算法的具体实现。以正例(3,3)、(4,3)和负例(1,1)为例,展示数据可视化及模型训练过程。代码使用NumPy进行向量运算,通过迭代更新权重w和偏置b,最终绘制决策边界,帮助读者理解感知机工作原理。
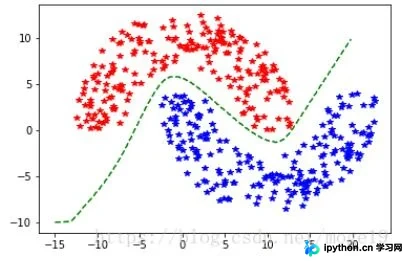
本文详细解析了使用Python实现多层感知器(MLP)处理双月数据集的完整过程。内容涵盖从生成非线性可分的双月数据、定义Sigmoid激活函数,到构建包含输入层、隐藏层和输出层的BP神经网络模型。通过反向传播算法优化权重,最终可视化展示决策边界与分类结果,为理解基础神经网络原理提供直观代码示例。
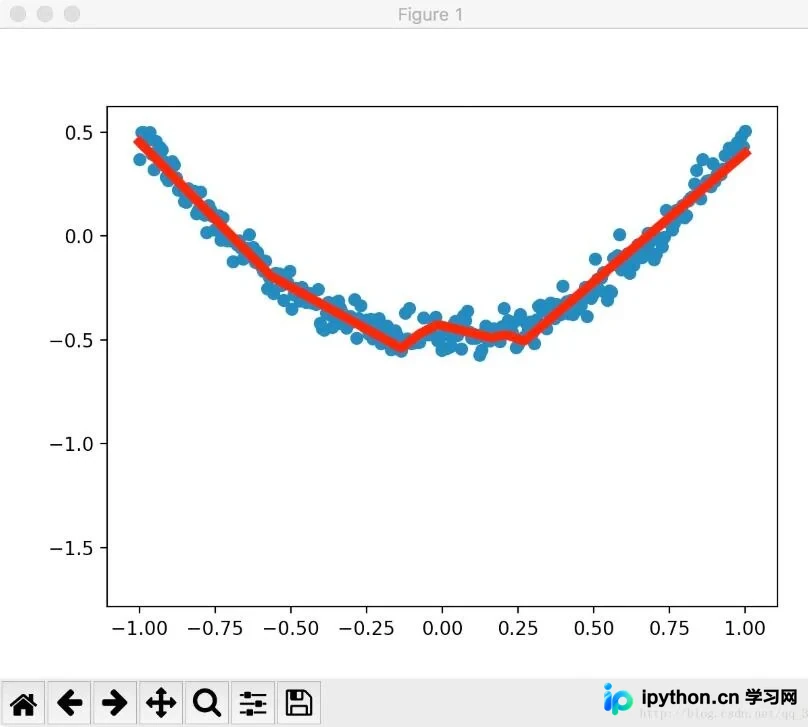
本文介绍如何使用Python的Matplotlib库对TensorFlow模型训练过程中的数据进行可视化分析。通过动态绘图展示预测结果与真实数据的对比,帮助开发者直观监控模型优化过程。文中包含关键代码示例及注意事项,如变量初始化方法的更新,为AI初学者提供实用的调试与展示技巧。
本文详细介绍Python中NumPy库的基础应用,涵盖数组创建、维度转换(ndim/shape)、等差/等比数列生成及初始化方法。作为深度学习的核心计算库,掌握NumPy是理解TensorFlow等框架中张量概念的关键,适合AI初学者入门学习。
本文详细介绍Python中DBSCAN密度聚类算法的实现原理与操作步骤。涵盖ε-邻域、核心对象、密度直达与可达等核心概念,并提供完整的Python代码示例及运行结果图,帮助开发者快速掌握基于密度的聚类方法。
本文介绍了一种使用Python实现的基于信息增益的决策树归纳方法。通过加载属性、训练数据和类别描述文件,构建决策树节点并进行分类测试。代码展示了如何计算信息增益以选择最优分裂属性,并评估分类器的准确率。适合对机器学习和决策树算法感兴趣的开发者参考。
本文介绍在Python中如何对图像数据集及其对应标签进行同步随机打乱。通过读取训练路径下的图片文件和标签CSV,利用numpy的permutation生成索引序列,确保图片顺序与标签顺序一致。示例代码展示了使用skimage处理图像尺寸及保存打乱后数据的过程,适用于机器学习模型训练前的数据准备阶段。