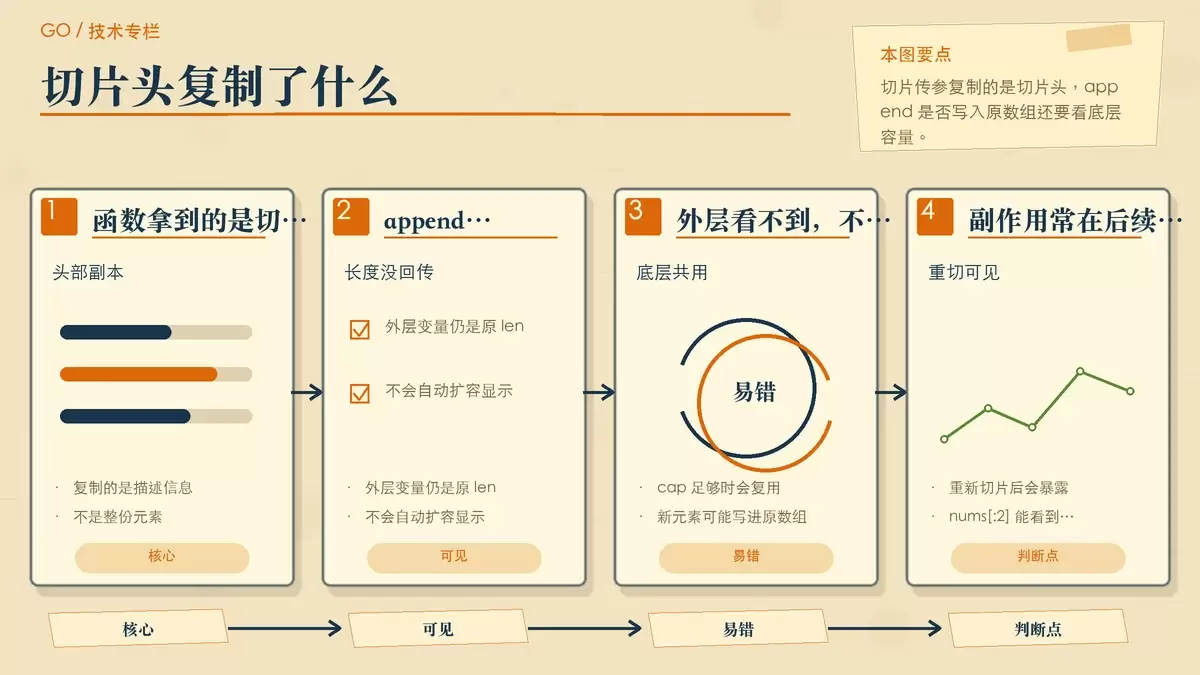
Go 切片传参后 append,为什么有时会改到外层,有时又不会?
Go 切片传参后执行 append,结果之所以“有时影响外层、有时又不影响”,关键不在“引用类型”或“值传递”这类单句判断,而在切片头复制与底层数组复用。本文用几个短例子讲清 len、cap 和共享数组的关系,并给出业务代码里更稳妥的写法。
2026-08-25
107

Go 切片传参后执行 append,结果之所以“有时影响外层、有时又不影响”,关键不在“引用类型”或“值传递”这类单句判断,而在切片头复制与底层数组复用。本文用几个短例子讲清 len、cap 和共享数组的关系,并给出业务代码里更稳妥的写法。
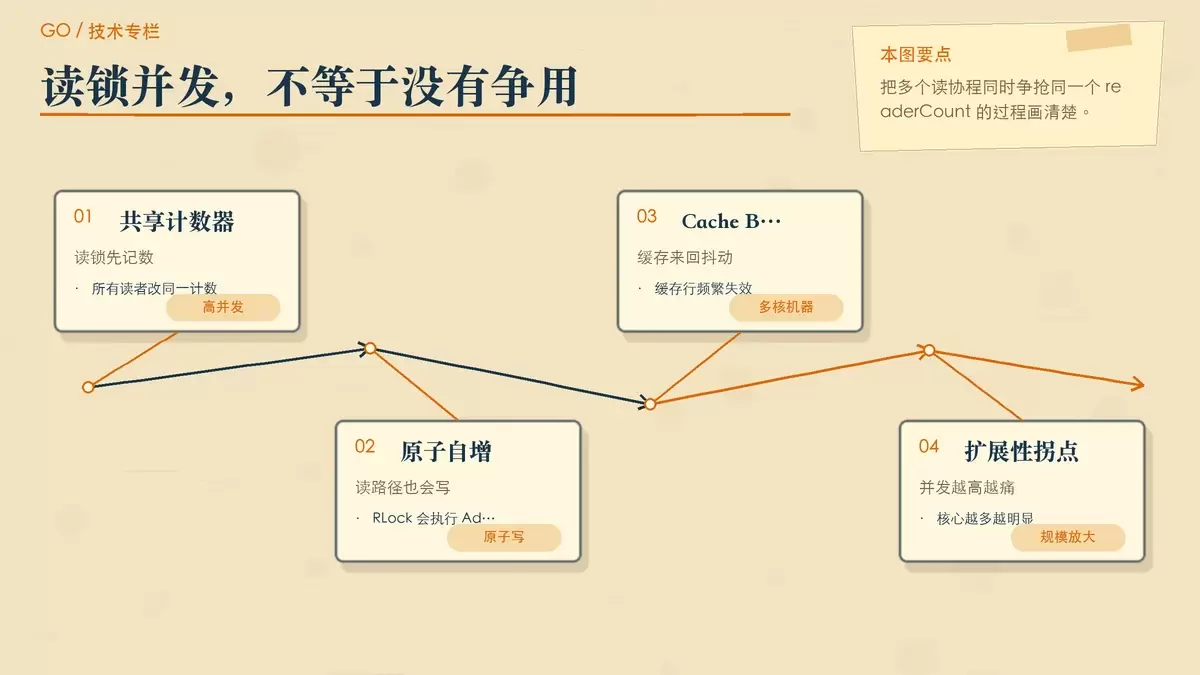
读多写少并不等于可以直接把互斥锁换成 `sync.RWMutex`。在高并发和多核环境下,读写锁的读路径同样要做原子写入,既可能引发缓存抖动,也会在写入到来时让新读请求排队。本文结合 Go 1.19+ 的实现细节,说明 `RWMutex` 何时有效、何时退化,以及 `atomic.Value` 在极端读多写少场景中的工程替代方案。
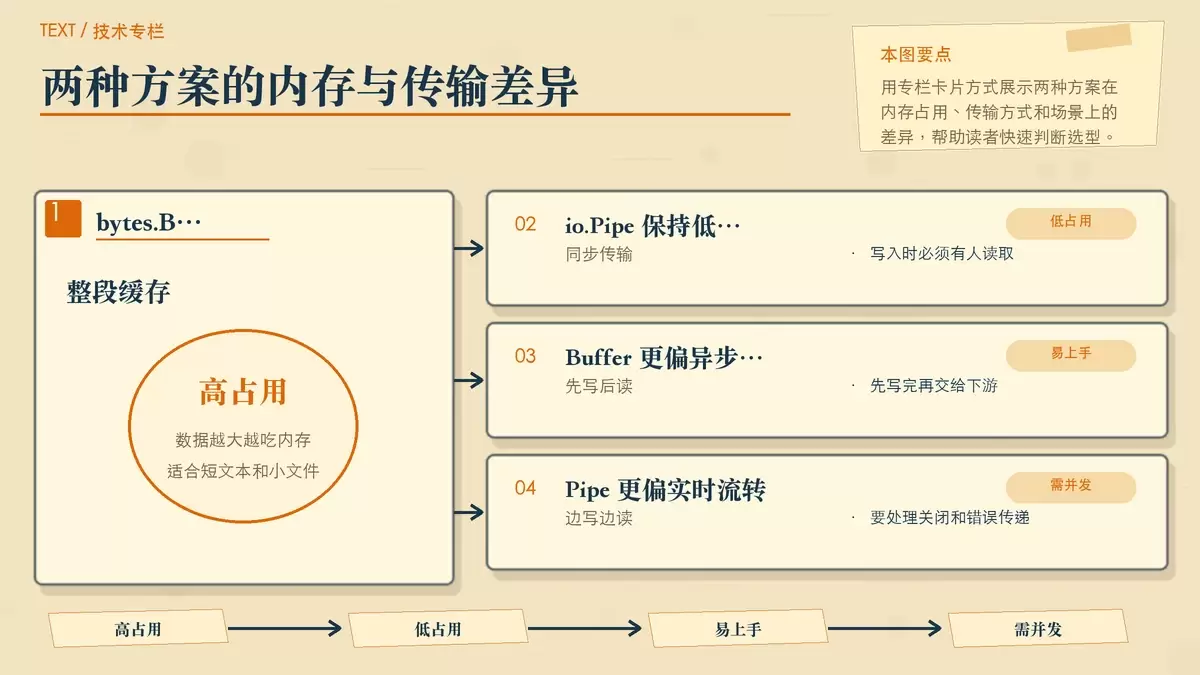
在 Go 中把一个 io.Writer 的输出接到 io.Reader,很多人会先想到 bytes.Buffer。但数据一旦上到 GB 级,缓存整段内容很容易把内存顶满。本文围绕 io.Pipe 的同步管道机制,梳理它的工作方式、常见死锁原因、错误传递方法,以及它和 bytes.Buffer 的适用边界。
Go 1.23 引入的标准库包 `unique`,把过去常见但容易踩坑的值去重做成了官方能力。它适合重复值很多、比较频繁的场景,既能减少冗余内存占用,也能把等值判断从字符串比较转成更轻量的句柄比较。
GoLand 没有“一键把代码段发给团队”的现成功能,但这件事的难点本来也不在发送,而在接收方能否立刻看懂、补齐依赖并跑起来。本文从格式保留、Live Template 复用、最小验证环境三方面整理一套更适合团队落地的分享方法。
在 SQL Server 里用 APPLY 取“每组最新一条”时,语法能跑通不代表结果可靠。本文围绕 TOP 1 的排序确定性、CROSS APPLY 与 OUTER APPLY 的语义差异、关联条件与索引要求,以及 APPLY 相比标量子查询的执行优势,整理出一套更稳妥的写法判断标准。
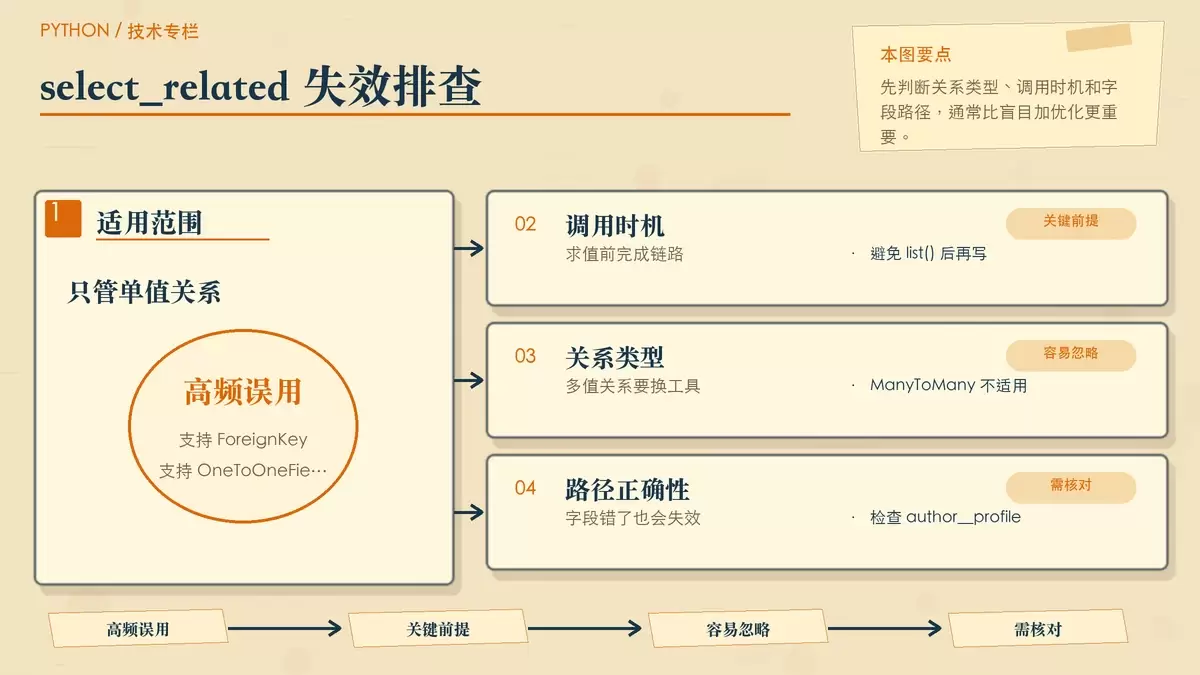
在 Django 里用了 `select_related()` 却还是出现 N+1,问题通常不在“有没有写”,而在是否用对了关系类型、调用时机和查询路径。本文把 `select_related` 的适用范围、常见失效场景、与 `prefetch_related` 的配合顺序,以及验证方法拆开讲清,方便你快速判断该用 JOIN 还是额外查询。
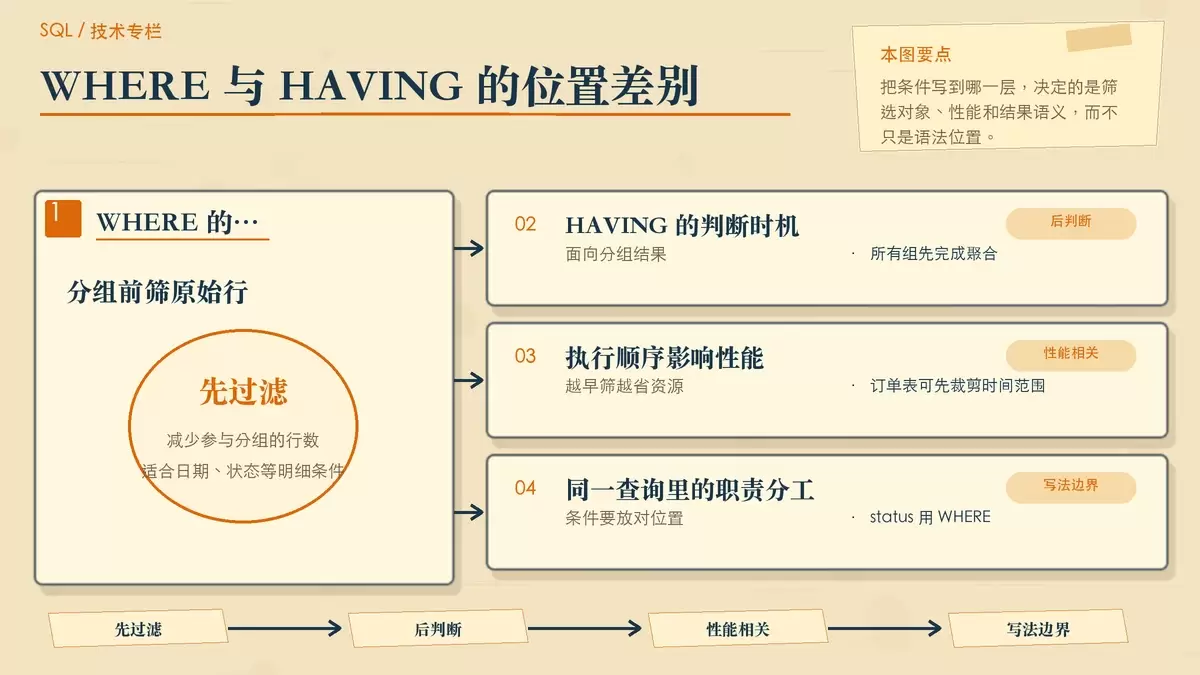
在 SQL 里,`WHERE` 和 `HAVING` 都能“筛选”,但作用阶段完全不同:一个面向原始行,一个面向聚合后的分组结果。本文结合 MySQL 5.7+ 的 `ONLY_FULL_GROUP_BY` 规则、常见报错和 `NULL` 场景,梳理 `GROUP BY` 后筛选结果时最容易写错的边界。 写分组统计时,最容易混淆的不是聚合函数本身,而是条件到底该放在 WHERE 还是 HAVING 。
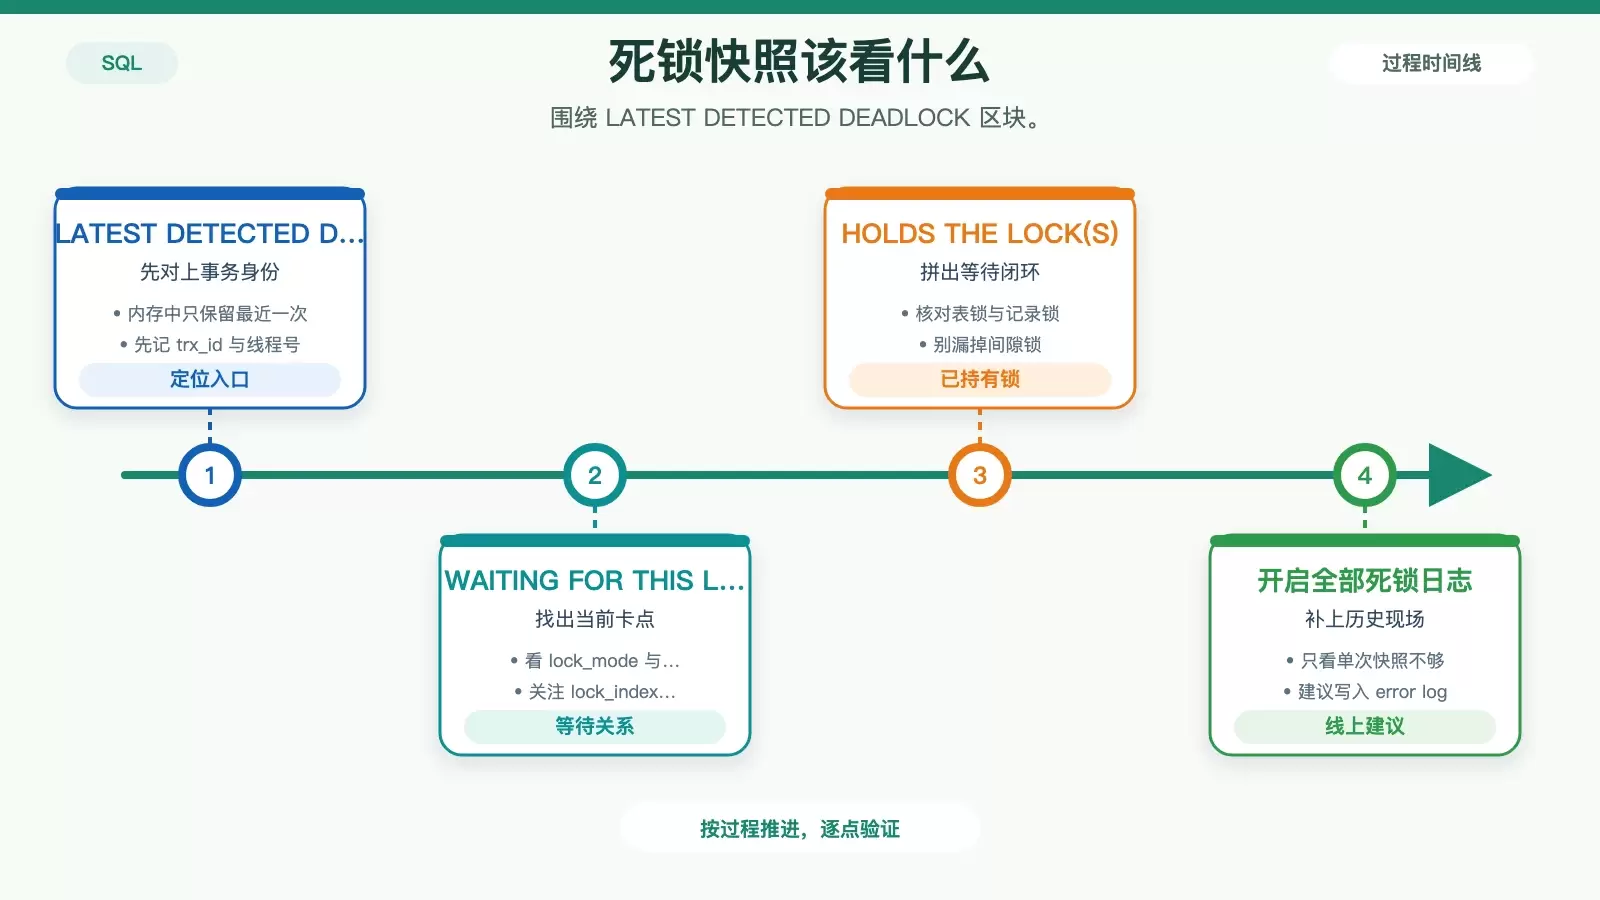
排查 SQL UPDATE 死锁,关键不是盯住报错语句本身,而是先还原两边事务的真实加锁链路。本文从 InnoDB 死锁快照、执行计划校验、间隙锁陷阱和批量更新策略四个方面,给出线上常用的定位入口与改写思路。
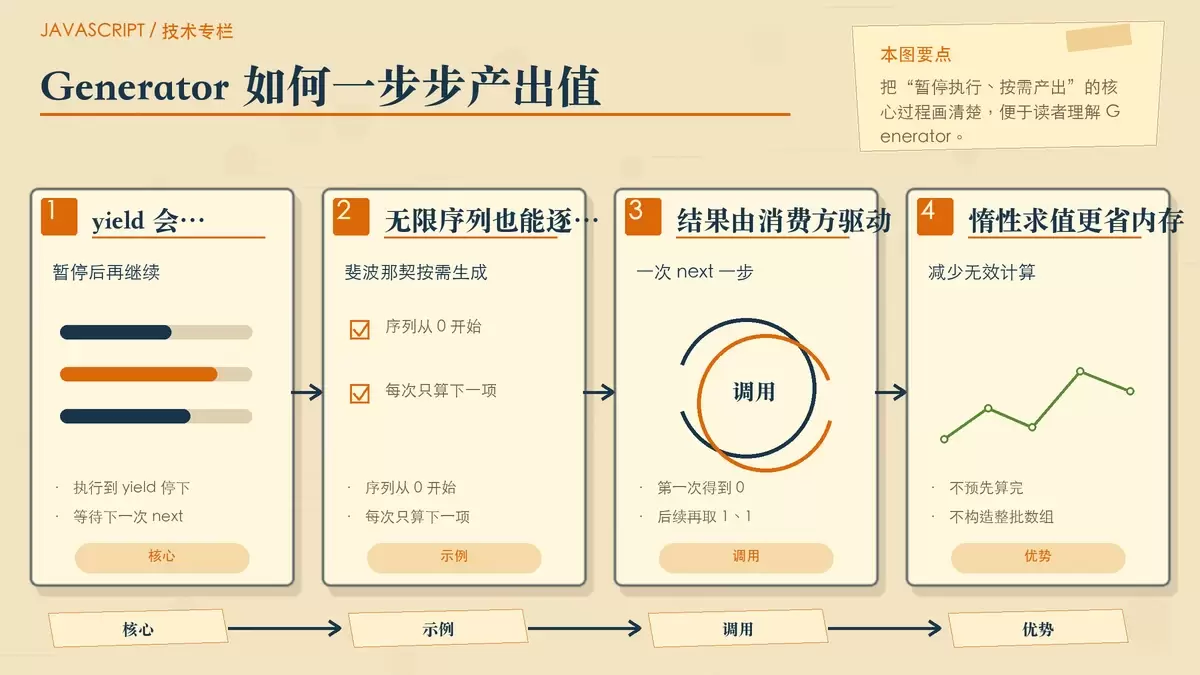
JavaScript 的 Generator 不只是语法糖,它在数据流处理中最实用的价值,是把“什么时候计算”交回给调用方。本文从 `yield` 的暂停机制讲起,再看它如何接入可迭代协议、组合 `map`/`filter`/`take` 等惰性操作,最后落到大文件、分页 API 这类真实场景。
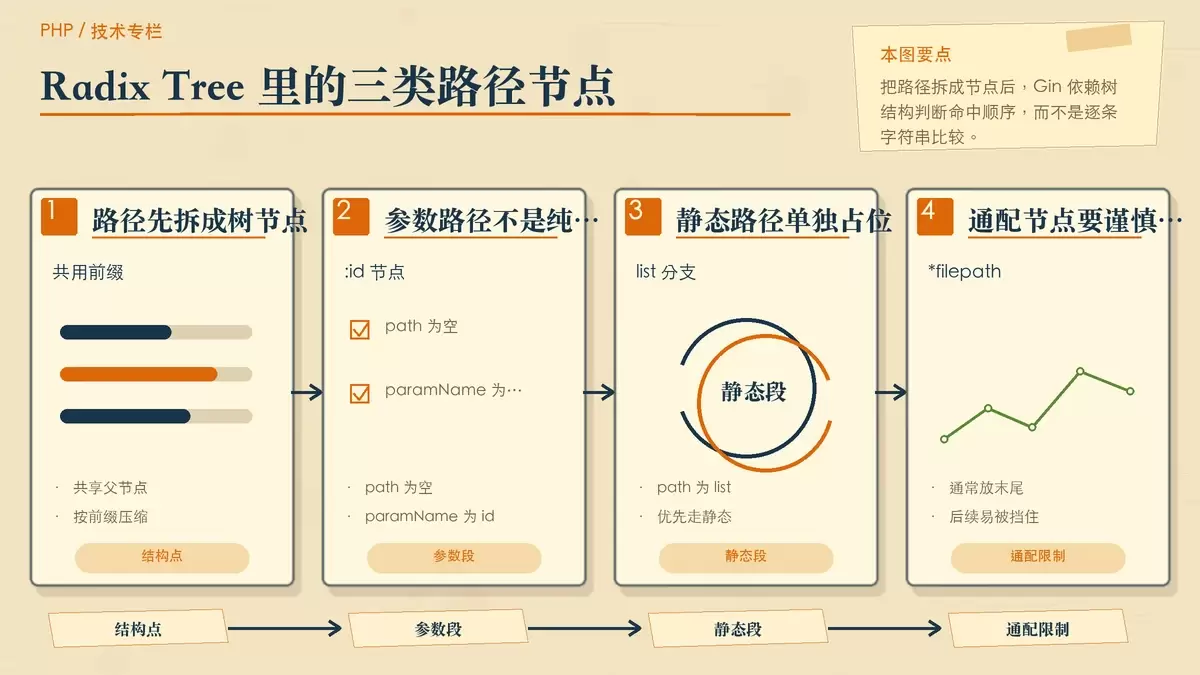
Gin 所谓“动态注册路由”,本质上是应用启动阶段把规则写入按 HTTP 方法划分的 Radix Tree,而不是服务运行后临时新增。理解路径拆分、分组前缀拼接和插入顺序的约束,才能判断为什么有些路由会冲突、被覆盖,甚至直接触发 panic。
前后端分离接口里,JSON 一旦参与签名,最常见的问题不是算法本身,而是对象键顺序在不同语言、不同库之间并不天然一致。本文围绕 JavaScript 场景梳理一套可落地的做法:签名前统一按字典序序列化、处理嵌套对象、让后端同步同一规则,并补上字段白名单与加盐细节。