


在 Go 后台开发里,配置热更新、路由表查询、黑白名单拦截都属于典型的“读极多、写极少”场景。很多人会把这类问题直接归结为“上 sync.RWMutex 就行”,但一旦并发规模拉高、CPU 核心变多,这个经验判断就未必成立。本文从 Go 读写锁的实现机制出发,拆开它在高并发下的真实成本,再给出 atomic.Value 的无锁热更新做法,帮助你判断什么时候该用锁,什么时候该换模型。
为什么读多写少时,RWMutex 也可能出问题
共享数据要保证并发安全,就必须处理读写之间的协调。最直接的方案是 sync.Mutex,但它会把所有读操作也串行化:即使读之间互不影响,也只能一个个进入临界区。
sync.RWMutex 的价值就在这里。它允许多个读协程并发持有读锁,只在写入发生时阻塞访问,所以在很多“读多写少”的业务里确实比互斥锁更合适。
问题在于,这个“允许并发读”只是宏观表现。放到 CPU 和缓存一致性的层面看,读锁本身并不是完全无代价的轻操作。尤其当读请求高到每秒几十万甚至几百万、并且同时跑在多核机器上时,读锁获取路径本身就可能成为争用点。
RLock 为何会带来缓存抖动和竞争
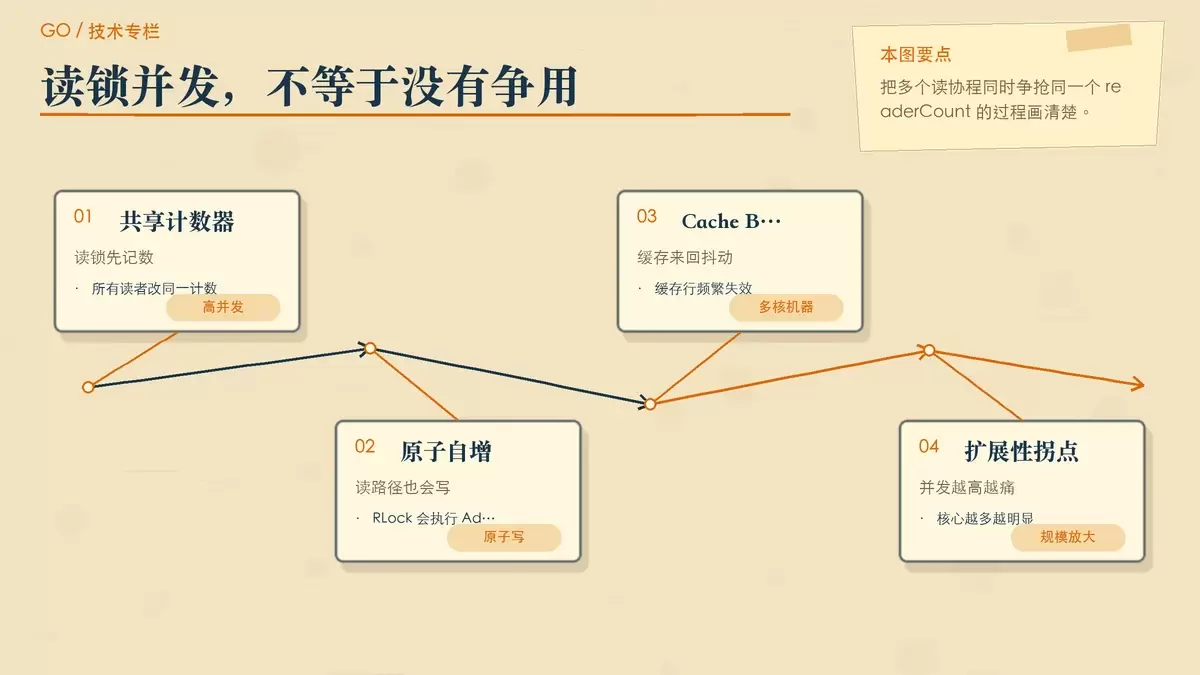
Go 标准库里的 sync.RWMutex,并不是通过一个纯只读标记来实现读锁。相反,每次调用 RLock(),都要去修改内部读计数器。自 Go 1.19 起,这部分字段已经改成强类型原子变量,核心动作可以概括成下面这一句:
// Go 1.19+ 读写锁内部的原子计数自增操作
rw.readerCount.Add(1)
这意味着:每个读协程进入临界区前,都要对同一个共享计数器做一次原子自增。逻辑上它是在“登记当前有多少个读者”,但硬件上这其实是一次写操作。
在多核 CPU 环境里,多个核心同时修改同一个内存地址,会触发明显的缓存一致性开销。某个核心一旦更新了 readerCount,其他核心缓存中的同一 Cache Line 就可能失效,随后这些核心必须重新同步最新数据。
并发量越高、核心数越多,这种围绕同一计数器的原子争用就越明显。表面上看,读操作都在并行执行;实际上,所有核心都在反复抢同一个共享状态。结果就是常见的 Cache Bouncing,也就是缓存行在多个核心之间频繁来回同步。
这也是为什么在 32 核、64 核这样的机器上,RWMutex 不一定随着核心数增加而持续受益。读操作虽然没有彼此串行化,但它们仍然通过原子计数器耦合在一起,吞吐量会被底层硬件同步成本吃掉一部分。
为避免写饥饿,RWMutex 还会制造延迟毛刺
除了缓存层面的竞争,sync.RWMutex 还有一个更容易在业务指标上暴露的问题:写协程一旦出现,新读请求会被挡住。
原因是读写锁必须处理“写饥饿”。如果系统永远偏向读者,那么只要持续有新读协程进入,写协程就可能一直拿不到锁。Go 为了避免这种情况,在有写协程开始排队时,会主动阻止后续读者继续切入。
Go 1.19+ 的核心逻辑可以用下面这句来表示:
// Go 1.19+ 宣告写锁排队,阻止新的读锁切入
r := rw.readerCount.Add(-rwmutexMaxReaders) + rwmutexMaxReaders
这段代码的意义不是“立刻拿到写锁”,而是先宣布写锁已经在等待。宣布之后,后续再来的读协程在执行 RLock() 时,就不会继续无条件放行,而是被挂起到等待队列里,直到写协程完成并释放锁。
从正确性上看,这个机制很重要,它避免了写请求被无限期饿死。但从延迟表现上看,它会形成明显毛刺:写入一来,新的读请求立刻开始排队,原本平滑的读链路会出现一个短时间停顿。
对很多管理后台来说,这个停顿可能没什么问题;但对于网关、配置分发、规则匹配这类追求低尾延迟的服务,哪怕写操作很少,只要它会周期性打断读流量,就可能在监控里形成肉眼可见的尖峰。
极端读多写少时,如何用 atomic.Value 做无锁热更新
如果场景满足两个条件:一是读远多于写,二是数据可以整体替换而不是原地细粒度修改,那么很多后端系统会改用写时复制(Copy-On-Write)加原子指针替换的思路。Go 标准库里最常见的落地工具,就是 sync/atomic 提供的 atomic.Value。
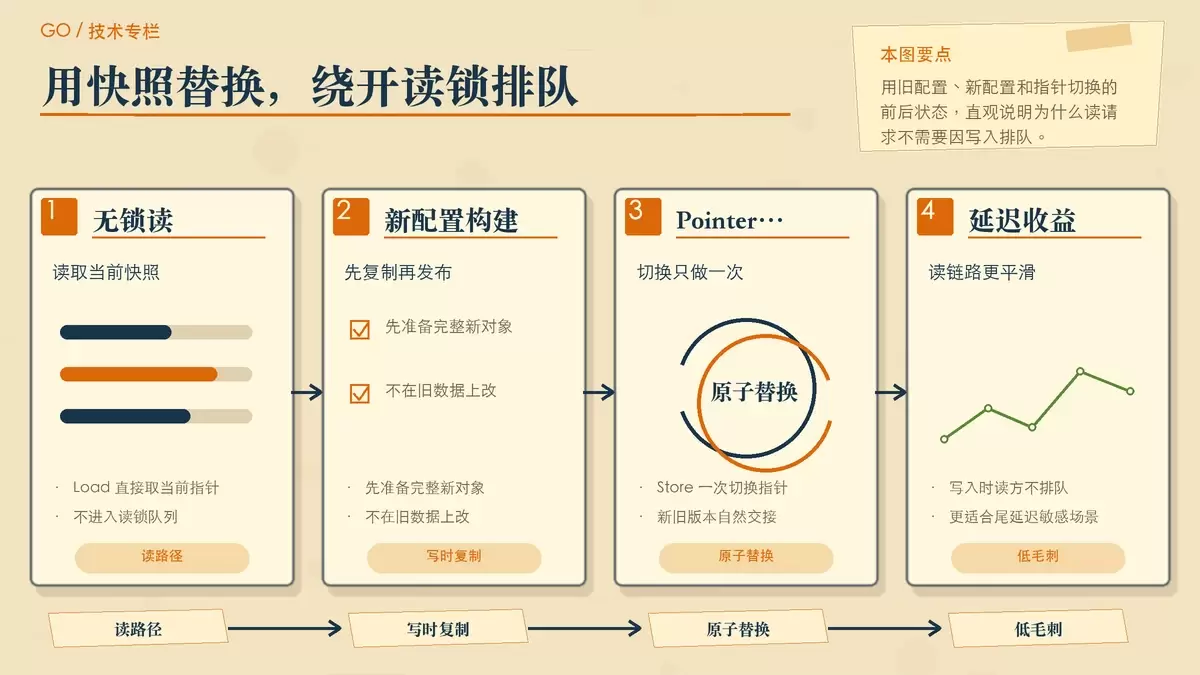
它的核心思路很直接:读路径不加锁,只读取当前配置指针;写路径不在原对象上打补丁,而是准备好一份新的完整数据,最后一次性原子替换。
先看数据结构定义:
// Config 定义系统需要频繁检索的配置信息
type Config struct {
    Routes map[string]string
}
这里的 Config 很适合做整体替换。对于路由映射表、黑白名单、特征规则集这类数据,业务往往更关心“读取当前版本”而不是“边读边改同一个对象”。
然后用一个服务结构体保存配置指针:
// RouteServer 承载并发路由检索的服务体
type RouteServer struct {
    config atomic.Value // 存储指针 *Config
}
读操作可以保持极简:
// GetRoute 读操作:零锁开销,高吞吐无摩擦
func (s *RouteServer) GetRoute(key string) string {
    cfg := s.config.Load().(*Config)
    return cfg.Routes[key]
}
这里的 s.config.Load() 本质上是一次原子读取当前指针。读协程不需要去竞争读计数器,也不需要登记“我正在读”,因此不会像 RLock() 一样在每次读取前都修改共享状态。
这正是它适合极端读多写少场景的关键。读请求越多,这种“只读当前指针”的模型优势越明显,因为所有读取都不需要排队,也不会因为写协程准备入场而被统一拦住。
写操作则采用整体替换:
// UpdateRoute 写操作:写时复制与指针原子替换
func (s *RouteServer) UpdateRoute(newRoutes map[string]string) {
    newCfg := &Config{
        Routes: newRoutes,
    }
    s.config.Store(newCfg) // 原子替换指针
}
在这个过程中,旧配置不会被直接修改。写协程先准备好新对象,再通过 Store 把指针一次性切换过去。切换前进入的读请求仍然读旧数据,切换后进入的读请求读新数据,整个过程不会让读方停下来等写方。
这就是为什么很多配置中心、本地缓存快照、规则表热更新都会采用类似方案。它牺牲的是“更新时需要准备一份新副本”,换来的是读路径的极低干扰和更平滑的延迟曲线。
当然,这也不是完全没有前提。它更适合整体替换成本可接受、数据发布频率低、更新原子性要求明确的场景;如果你的写入非常频繁,或者数据结构巨大且复制代价高,收益就未必能覆盖复杂度。
Mutex、RWMutex、atomic.Value 到底该怎么选
工程里没有单一答案,关键是把同步方式和业务形态对齐。下面这段伪代码概括的是一种“先看读写比例,再看数据规模和访问形态”的决策思路:
// 伪代码:在三者之间做工程决策的判断逻辑
func ChooseSyncStrategy(readRatio float64, size int) string {
    // 根据读比例与数据规模做决策
    return "Mutex" // 或 "RWMutex" 或 "Atomic"
}
如果读写比例比较均衡,比如 1:1 到 10:1,或者临界区非常短、代码追求简单可维护,那么 sync.Mutex 往往是最稳妥的方案。它语义直接、行为容易预估,也最不容易引入复杂的并发表现问题。
如果读明显多于写,比如大于 100:1,而且临界区读逻辑并不只是取一个指针,而是确实有一段需要保护的共享访问过程,同时部署环境的 CPU 核心数处于常规规模,那么 sync.RWMutex 仍然是很实用的折中方案。
但如果读写比例已经极端失衡,比如大于 10000:1,写入非常稀少,系统又对尾延迟很敏感,并且数据可以按“整份快照”替换,那么 atomic.Value 更值得优先考虑。它解决的不是一般意义上的并发安全,而是高并发读场景下读路径被锁状态干扰的问题。
换句话说,RWMutex 不是不能用,而是不是所有“读多写少”都该默认用它。是否合适,取决于读锁获取的硬件成本、写入到来时你是否能接受读方排队,以及数据是否适合用快照替换来建模。
真正可靠的选型方式,不是背结论,而是把业务模式、机器规格和延迟目标一起考虑进去。只有理解了读写锁在底层是怎么工作的,才不会在面试里答得漂亮、在线上却踩到性能拐点。









