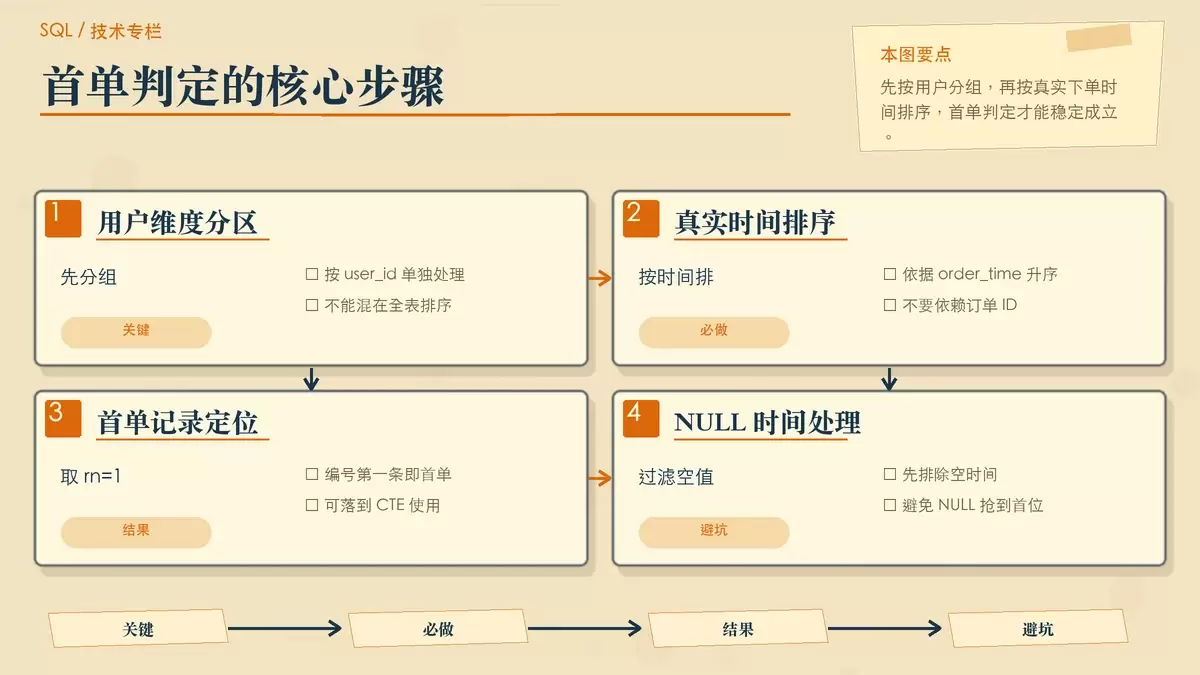
SQL窗口函数如何查询首次购买后的复购记录
查询“首次购买后的复购记录”,关键不在于先写哪种 SQL,而在于先把“首次购买”的业务口径定清楚。本文用窗口函数为主线,拆解如何用 `ROW_NUMBER()` 锁定每个用户首单、再筛出后续订单,并说明 MySQL、PostgreSQL、SQL Server 的写法差异与常见误区。
2026-08-25
67

查询“首次购买后的复购记录”,关键不在于先写哪种 SQL,而在于先把“首次购买”的业务口径定清楚。本文用窗口函数为主线,拆解如何用 `ROW_NUMBER()` 锁定每个用户首单、再筛出后续订单,并说明 MySQL、PostgreSQL、SQL Server 的写法差异与常见误区。
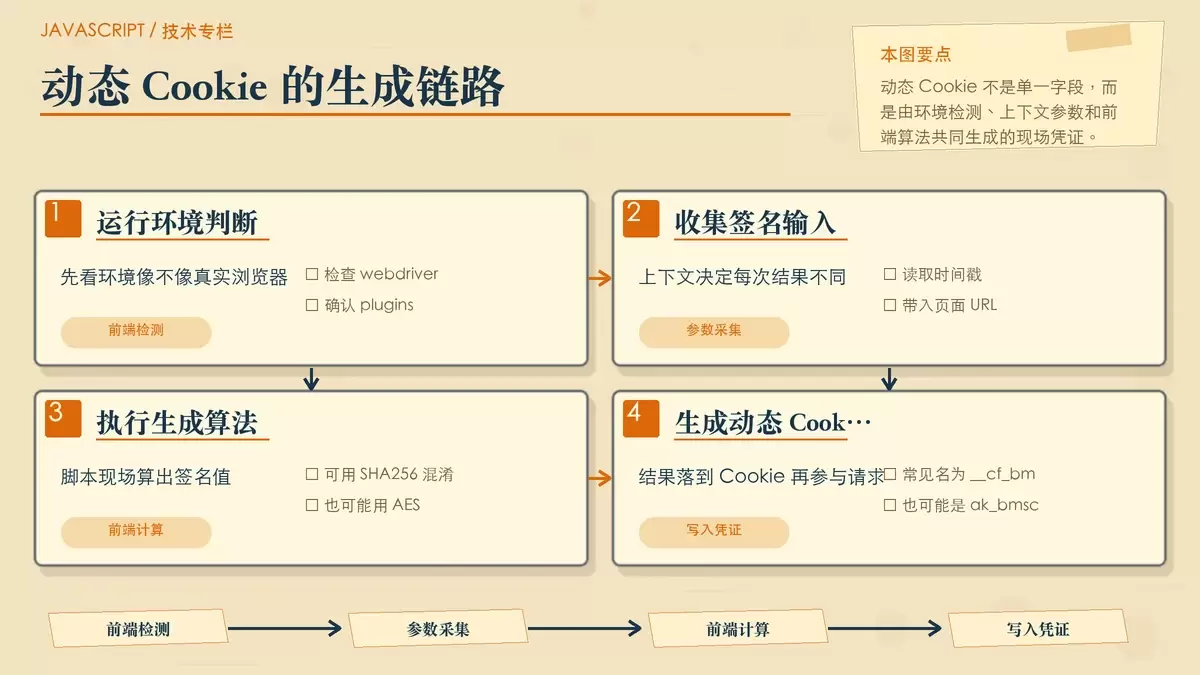
动态 Cookie 防护的关键,不在于“设置一个 Cookie”,而在于要求客户端在真实浏览器环境里现场算出可校验的凭证。本文按生成、校验、失效原因与表单防刷增强四个环节,梳理这类 JavaScript 反爬机制的工作方式与适用边界。
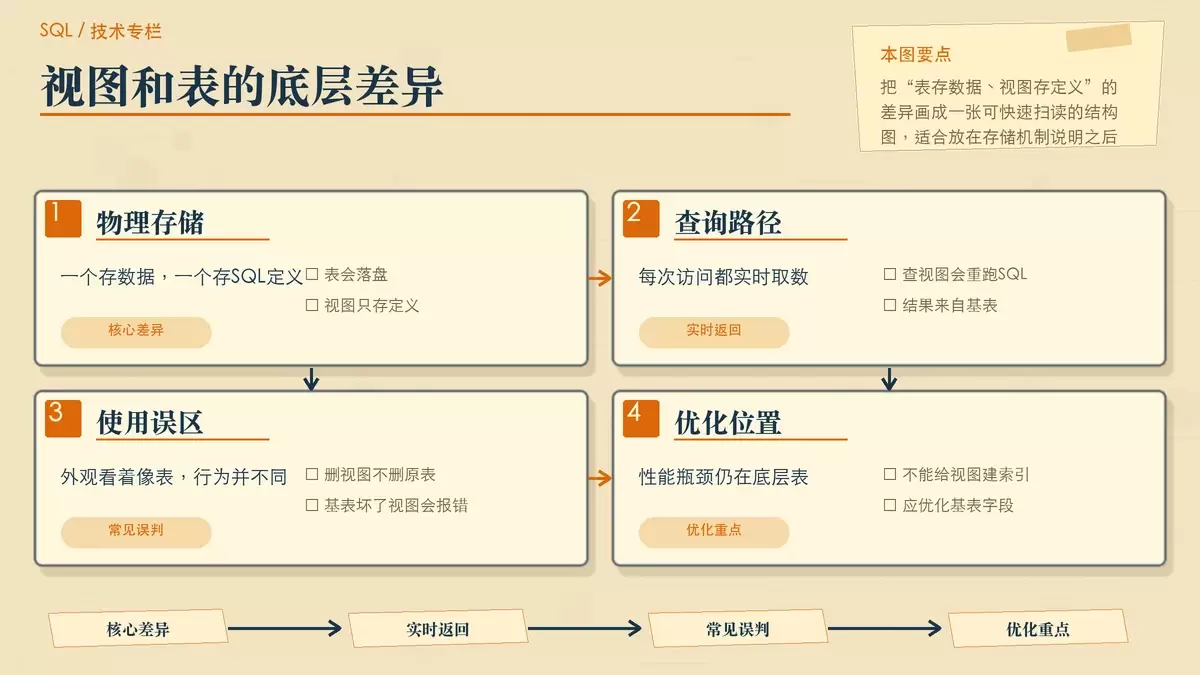
视图和普通表在查询结果上看似相同,但底层职责完全不同:表负责真实存储,视图只保存查询定义。理解两者在存储、写入限制、权限隔离和性能上的差异,才能判断该用表落地数据,还是用视图做封装与接口层。
C++ 多线程程序在调试时频繁断连,常见原因并不是网络故障,而是超时、阻塞和心跳逻辑仍按真实时间推进。本文从 `condition_variable`、socket 超时和应用层心跳三类场景入手,说明为什么断点会触发误判,以及调试阶段应如何隔离这些时间依赖。
在 SQLAlchemy 里使用原生 SQL,最容易踩的坑不是不会写查询,而是把 `text()` 当成天然安全层。本文围绕四类高频风险展开:字符串拼接、动态字段名、`execute()` 传参差异,以及 `IN` 查询展开方式,给出可直接落地的安全写法。
在 SQL 里查找重复数据,最常见的做法是先用子查询找出重复键,再由外层查询回捞原始行。但 `IN`、`EXISTS`、多字段匹配和 MySQL 删除限制各有坑,尤其会受 `NULL`、版本能力和同表删除规则影响。 查重复数据,真正麻烦的通常不是写出一条 GROUP BY ,而是继续把原始记录捞出来,并判断后续能否安全删除。
GROUPING SETS 适合把多个彼此独立、又要同时出现在一张结果表里的聚合需求合并成一次查询。它的优势不是“更高级的汇总语法”,而是精确控制分组组合;但要注意 MySQL 8.4 及以下不支持,结果里的 NULL 也必须配合 GROUPING() 才能正确解释。
Python 里的 `set` 很适合做去重和集合运算,但它不是“列表增强版”。这篇文章把几个最容易踩坑的点拆开讲清:为什么 `set()` 去重会打乱顺序、什么时候该改用 `dict.fromkeys()`、交并差集的推荐写法,以及把列表转成 `set` 时常见的类型限制和性能判断。
用 LEFT JOIN 做“零数量统计”时,最常见的坑有三个:把 COUNT(*) 当作关联记录数、GROUP BY 写错分组键、以及把左表过滤条件误塞进 ON 子句。本文用订单与商品示例拆开说明这些问题,并给出在 MySQL、PostgreSQL 等数据库里更稳妥的写法与性能判断依据。
按年月统计订单并不难,难点在于分组键是否稳定、展示是否直观,以及查询能否继续走索引。本文按 MySQL、PostgreSQL、SQL Server 和跨库写法分别整理可直接落地的方案,同时指出常见误区与性能边界。
按日期筛选数据时,`BETWEEN` 常因隐式转换把右边界变成当天 `00:00:00`,导致最后一天的数据被漏掉。本文用订单、日志等常见场景说明问题根源,并给出更稳妥的左闭右开写法、动态边界生成方式,以及字符串日期字段的处理建议。
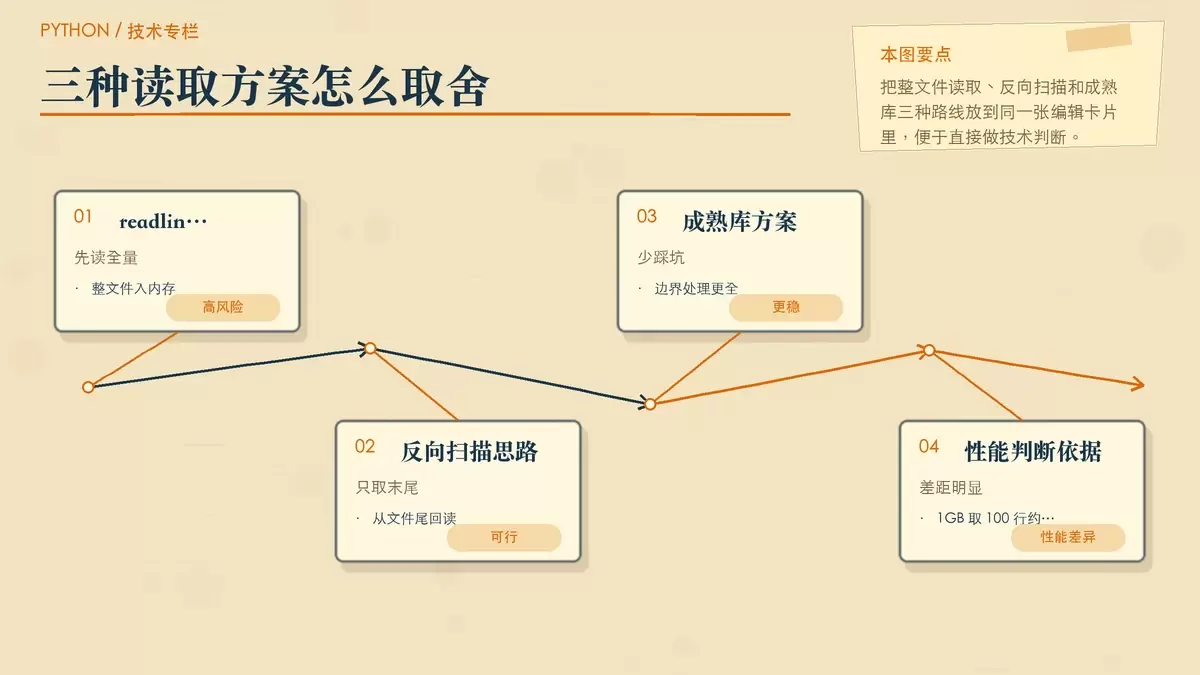
读取大日志最后 N 行时,`readlines()[-N:]` 看似直接,实际会把整份文件读入内存,面对 GB 级日志很容易卡死或触发 `MemoryError`。这篇文章把可行方案拆开讲:命令行优先用 `tail -n N`,Python 自实现则要用二进制反向扫描,同时说明边界处理和第三方库的取舍。