


多线程网络程序一旦进入断点或单步,最容易出现的现象不是代码本身报错,而是连接先被判定为超时断开。问题通常不在调试器,也不在链路质量,而是程序内部把“真实时间流逝”当成了业务判断条件。下面按等待、socket 超时和心跳机制三类典型场景拆开看,帮助你判断哪些逻辑适合保留真实超时,哪些必须在调试阶段显式隔离。
为什么 wait_for 在调试时特别容易误超时
std::condition_variable::wait_for 的超时依据是真实流逝时间,也就是 wall-clock time,而不是线程真正执行了多久。只要线程在断点处停住,计时就不会跟着暂停。
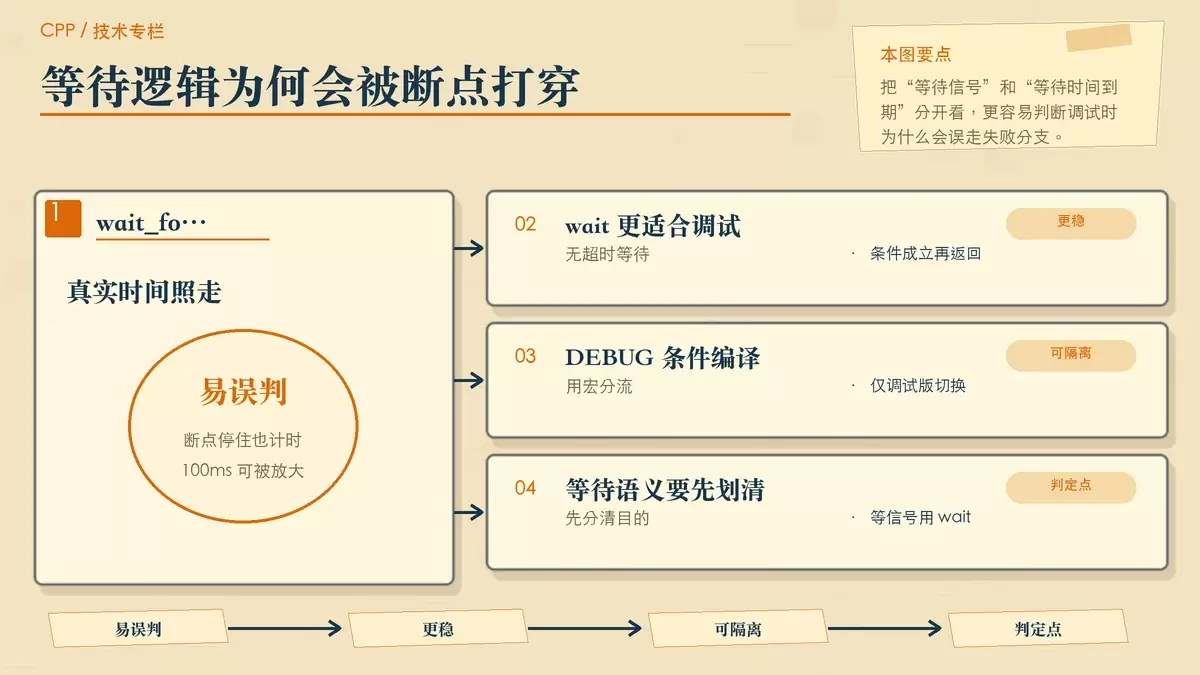
这意味着你在调试器里停 5 秒,哪怕代码只写了一个 wait_for(100ms, pred),它也会把这 5 秒一起算进去,最后直接返回 false。从程序视角看,这就是一次标准的“等待失败”,它不会知道你只是为了排查问题才中断执行。
- 如果你的目标是“等到某个条件成立”,而不是“100ms 内必须等到”,那就不应该把
wait_for当成默认方案。 - 调试阶段更合适的写法是无超时等待:
wait(lock, pred),配合notify_one或notify_all主动唤醒。 - 如果业务上必须保留超时语义,例如需要模拟线上行为,至少要在调试构建里把这类逻辑隔离出来。
一个直接可用的处理方式,是通过条件编译让调试版改成无限等待。这样既不影响发布版行为,也能避免断点把等待逻辑提前打穿。
#ifdef DEBUG
// 调试时改为无限等待
cv.wait(lock, pred);
#else
cv.wait_for(lock, 100ms, pred);
#endif
判断标准其实很简单:只要这段等待逻辑本质上是在等另一个线程发信号,优先就该用 wait;只有当“超时本身就是业务结果的一部分”时,wait_for 才值得保留。
socket 设置超时后,为什么一调试就断连接
另一类高发问题出在 socket 阻塞超时。给 recv 或 send 设置 SO_RCVTIMEO、SO_SNDTIMEO 后,计时是在内核层完成的,调试器暂停线程并不会让内核计时器停下来。
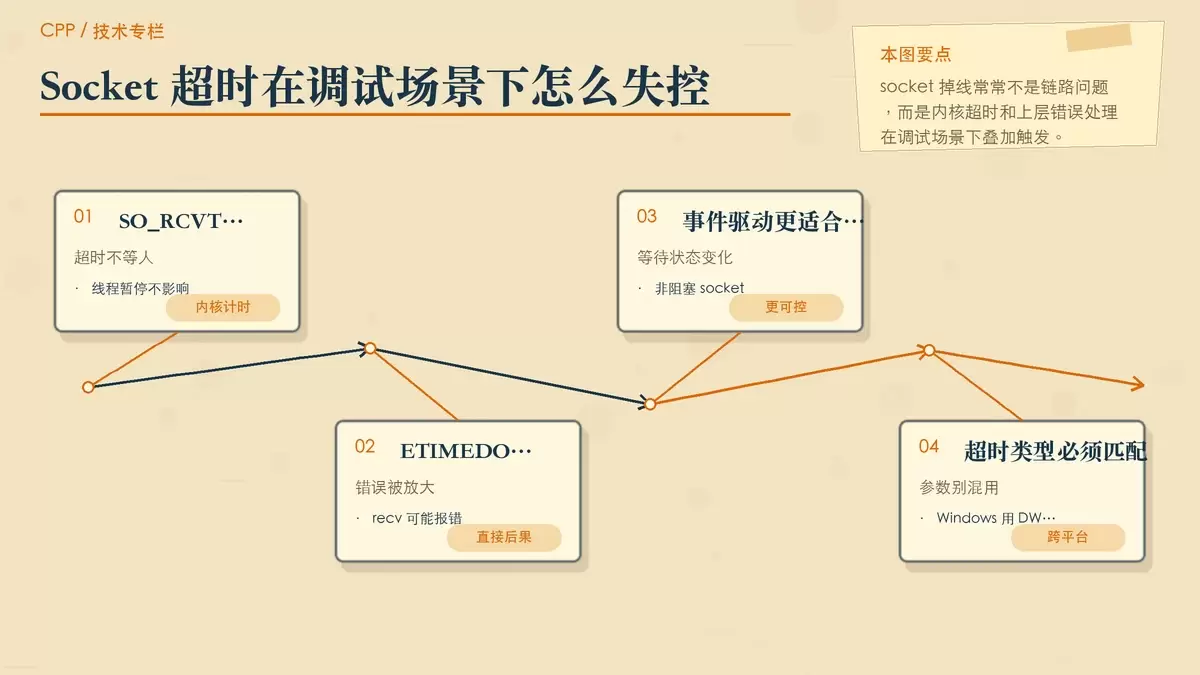
因此线程即使卡在系统调用里不动,超时时间一到,recv 仍然可能返回 ETIMEDOUT 或 EAGAIN。如果上层把这种返回值直接解释为“连接失效”,接下来就会主动关闭 socket,看起来像是调试一停就掉线。
这类问题可以从两层处理。
调试阶段先隔离内核超时
如果当前任务是排查线程协作、协议处理或状态切换,最省事的办法就是在调试构建中临时禁用 setsockopt 的超时设置:
#ifndef DEBUG
setsockopt(fd, SOL_SOCKET, SO_RCVTIMEO, ...);
setsockopt(fd, SOL_SOCKET, SO_SNDTIMEO, ...);
#endif
这样做的重点不是修改业务逻辑,而是避免内核在你停住线程时替你做出“已经超时”的判定。
需要更可控时,改用非阻塞模型
如果你希望调试和运行时的行为都更一致,可以考虑改成非阻塞 socket,再用 select 或 poll 驱动等待。原文里给出的经验是:调试暂停期间,select 只关心文件描述符状态变化,只要你没有主动销毁连接,它就会继续等下去,整体可控性比内核阻塞超时更强。
此外还有一个很容易忽略的跨平台细节:Windows 下 SO_RCVTIMEO 传入的是 DWORD 毫秒值,而 Linux/macOS 使用的是 struct timeval。如果把两边写法混用,结果可能不是简单的“超时不准”,而是直接把超时设置成 0 秒或极端的大值,调试时问题会更加难查。
心跳检测怎样设计,才不会在断点时误判掉线
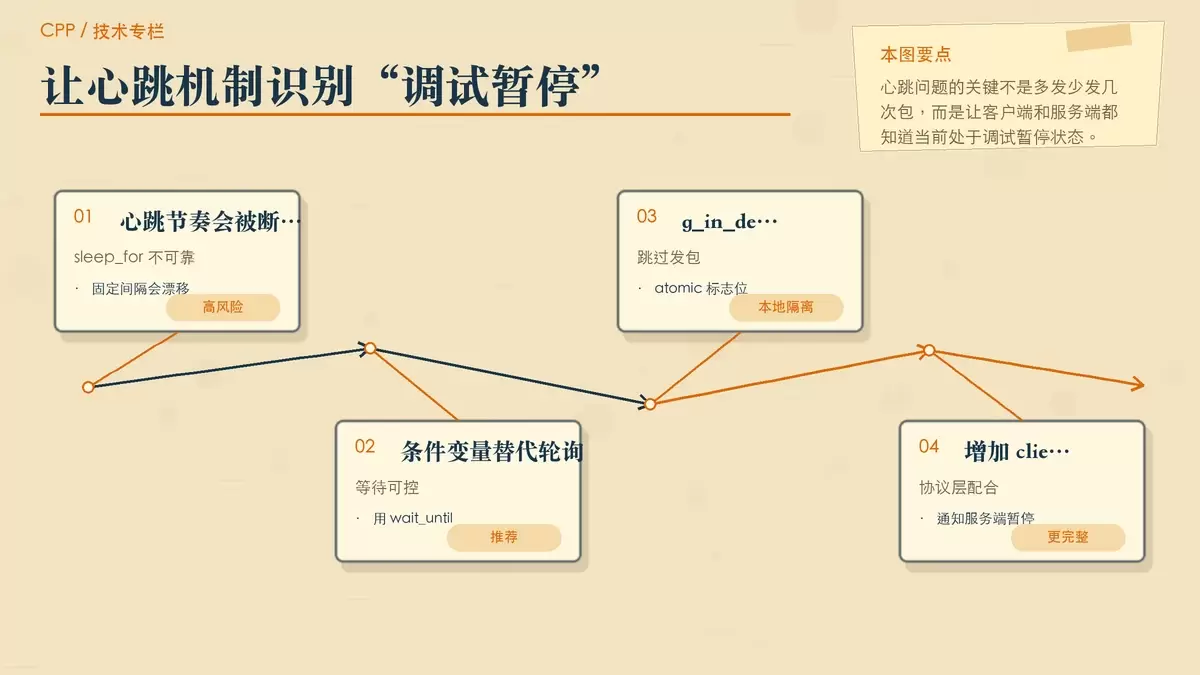
应用层心跳往往比底层 socket 超时更隐蔽。很多程序会开一个心跳线程,用 std::thread 加 sleep_for 定时发包,或者定时检查最近一次响应时间。一旦调试器暂停,心跳发送和接收节奏都会被打乱,对端就可能把客户端判定为失联。
这里的问题不只是“少发了几次包”,还包括本地状态机会因为时间差值失真而连锁触发。例如某段逻辑用 steady_clock::now() 的差值判断“多久没收到响应”,断点停住的几秒钟也会被原样算进去。
不要用固定 sleep_for 维持心跳节奏
相比简单轮询,更稳妥的做法是把心跳线程改成 std::condition_variable::wait_until,再配合一个全局调试标志控制发送行为。这样线程不是盲目睡眠一段固定时间,而是可以根据调试状态决定是否真的发包。
std::atomic<bool> g_in_debug{true};

// 心跳循环中:
// 如果处于调试状态,则跳过发送,只维护本地状态
原文建议在调试启动时设置一个原子标志,例如 std::atomic<bool> g_in_debug{true}。心跳循环检测到该标志后,不发送心跳包,只做本地状态更新。这样可以避免你在断点期间让对端看到一串异常节奏的心跳。
对端可配合时,增加“暂停豁免”协议
如果客户端和服务端协议都在自己控制范围内,更稳妥的方案是调试器附加后主动发送一帧类似“client paused”的协议消息,让服务端暂时放宽心跳检查。这样处理的好处是明确、可观测,而且不会把调试行为伪装成正常运行。
这类设计尤其适合长连接、网关、消息分发或需要严格保活的系统。因为真正触发断开的决定权往往并不只在客户端,本地停发心跳只能解决一半问题,让服务端理解“当前是调试暂停”才更完整。
真正该隔离的,是所有依赖连续时间流逝的逻辑
归根到底,调试时掉线不是单个 API 的问题,而是程序里存在大量默认假设:线程会持续运行、计时器会按预期推进、固定间隔的 sleep 能维持业务节奏。这些假设在线上成立,在断点环境里却全部会失真。
因此排查这类问题时,可以按下面的顺序判断:
- 先看等待逻辑是不是把“超时”当成了普通控制流的一部分,例如
wait_for失败后直接进入错误分支。 - 再看系统调用是否启用了内核级超时,例如
SO_RCVTIMEO、SO_SNDTIMEO。 - 最后检查应用层是否有心跳、轮询、时间差判断、固定周期
sleep等依赖连续时间的机制。
只要确认一段逻辑在调试阶段不需要真实超时语义,就应该显式切换到“无超时、可唤醒、可豁免”的模式。把调试行为和运行时行为区分开,通常比继续追查“为什么一打断点就断线”更有效。









