


很多网站拦截自动化请求,并不是单纯依赖请求头或固定 Cookie,而是把“先执行一段 JavaScript,再拿到临时凭证”作为访问前提。判断这类机制是否有效,关键要看 Cookie 是否同时绑定了执行环境、时间窗口和后端可复算的签名链路;理解这几点,才能分清它只是表面校验,还是足以抬高恶意请求成本的真实防线。
动态 Cookie 为什么能成为反爬入口
JavaScript 动态 Cookie 反爬的本质,是利用浏览器执行环境的不可替代性来区分人与机器。服务端并不直接信任请求头里携带的 Cookie,而是要求客户端先“现场生成”一个动态、有时效、带环境指纹的 Cookie,再用它发起后续请求。
这意味着,爬虫如果不能真实执行 JS,就拿不到关键凭证。像 __cf_bm 这样的动态 Cookie,通常不是页面初始响应里直接下发的固定值,而是由前端脚本结合当前环境计算出来,再写回浏览器。
和传统静态 Cookie 相比,这种机制多了三个约束:
- 它依赖浏览器运行时,不能只靠拼接 HTTP 请求复用。
- 它带有时效性,常见设计是几分钟内有效。
- 它往往和访问环境绑定,例如 IP、User-Agent、页面 URL 或已有会话信息。
因此,动态 Cookie 的重点不只是“有一个值”,而是这个值必须来自正确的执行现场,并且能被服务端复验。
浏览器里通常怎样生成动态 Cookie
典型流程中,用户首次访问页面时,服务器返回 HTML,并在页面里嵌入一段 JS 脚本。脚本运行后,才会完成动态 Cookie 的生成。这个过程通常包含三步。
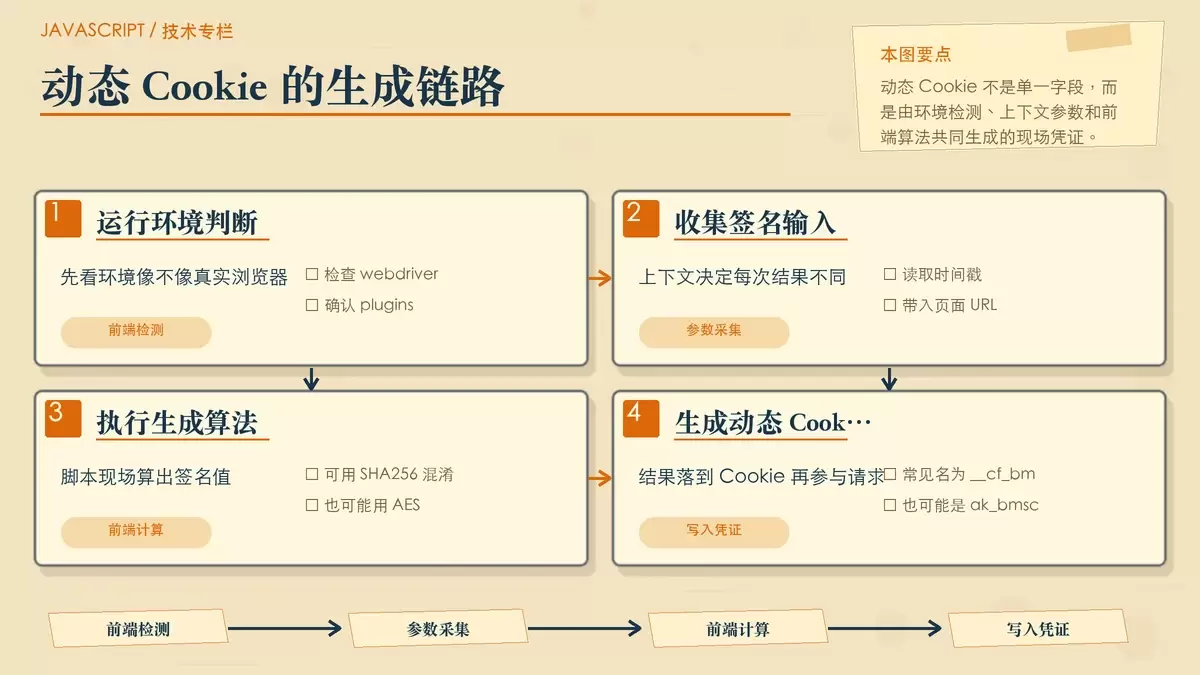
1. 先判断当前是不是可疑运行环境
脚本会先读取一些浏览器特征,确认当前环境不像一个过于“裸露”的自动化容器。例如:
- 检测
navigator.webdriver是否为false - 检查
plugins是否存在 - 确认
userAgent是否完整
这类信息未必足以单独判定机器人,但它们会参与后续计算,成为环境指纹的一部分。
2. 再收集参与签名的上下文参数
除了浏览器环境,脚本还会采集当前请求上下文中的变量,常见包括:
- 当前时间戳
- 页面 URL
- 已有静态 Cookie
- 随机
salt
这样做的目的,是让同一段算法在不同时间、不同页面或不同会话下,算出的结果都不一样,减少 Cookie 被复制后长期复用的可能。
3. 通过前端算法计算并写入 Cookie
最后,脚本会用预设算法生成签名值,并写入名为 __cf_bm、ak_bmsc 或类似名称的 Cookie。常见做法包括:
SHA256+ 时间戳混淆AES加密- 自定义位运算
从设计上看,这一步不是为了绝对保密,而是为了让请求必须经过一次真实执行,才能得到能用的结果。
检测运行环境(如 navigator.webdriver 是否为 false、plugins 是否存在、userAgent 是否完整)
采集上下文参数(当前时间戳、页面 URL、已有静态 Cookie、随机 salt 等)
通过加密函数(如 SHA256 + 时间戳混淆、AES 加密或自定义位运算)生成签名值,并写入名为 __cf_bm、ak_bmsc 或类似名称的 Cookie
服务端校验时,真正验证的是什么
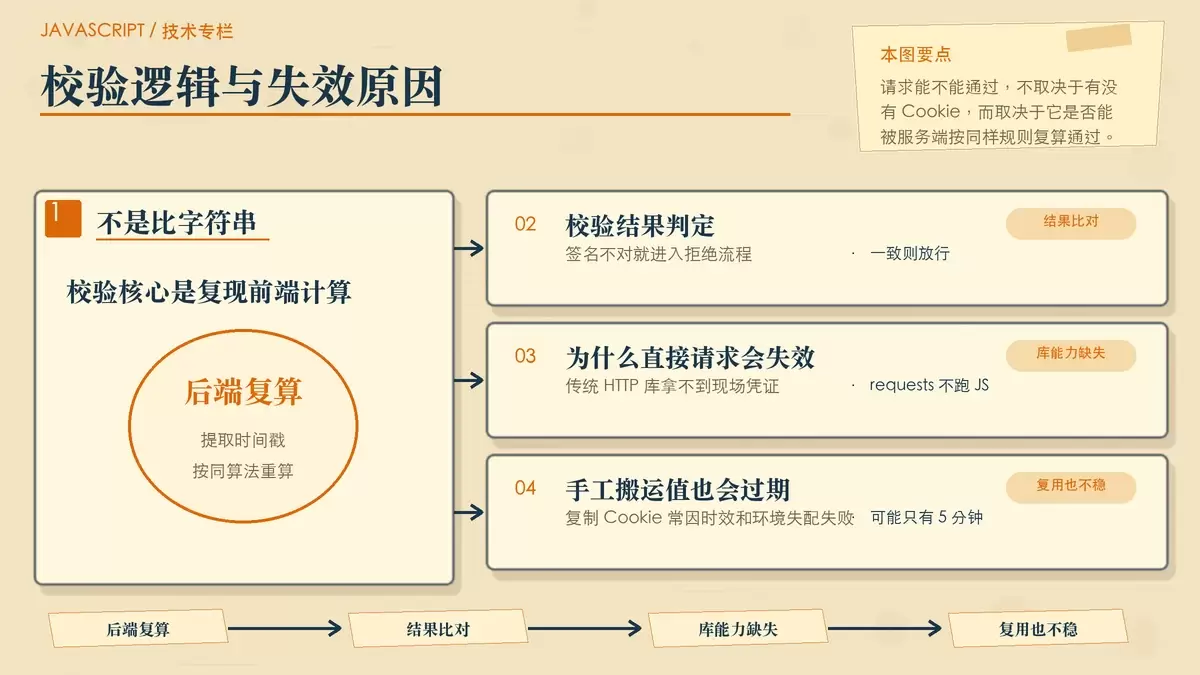
后续请求,尤其是 POST 表单提交或关键 API 请求到达服务端时,后端会检查这个 Cookie 是否存在、是否过期,以及它的签名是否可以被还原验证。这里的校验并不是简单做字符串比对,而是要复现前端 JS 的核心计算逻辑。
一个典型的校验链路通常包括:
- 提取请求中的动态 Cookie 值和对应时间戳
- 用相同密钥、相同算法、相同输入参数重新计算一次哈希
- 比对结果是否一致
如果结果不一致,服务端通常会直接拒绝请求,返回 403,或者跳转到挑战页。这样一来,攻击者即便能看到 Cookie 的最终值,也不一定能稳定复用,因为后端验证的是“它是否按规则算出来”,而不是“它看起来像不像真的”。
换句话说,动态 Cookie 有效的前提是前后端对输入和算法达成严格一致:相同密钥、相同参数、相同时间处理方式、相同编码逻辑,缺一项都可能导致误判。对防护方而言,真正的门槛也建立在这里。
提取请求中的动态 Cookie 值和对应时间戳
用相同密钥、相同算法、相同输入参数(如当前 URL、原始时间戳)重新计算一次哈希
比对结果是否一致;不一致则拒绝请求,返回 403 或跳转挑战页
为什么传统 HTTP 爬虫在这里经常失效
requests、urllib 这类 HTTP 库只能发请求,不能执行页面里的 JS,所以它们通常无法自行生成合法 Cookie。这也是很多“接口明明抓到了,请求却还是 403”的直接原因。
即使手动从浏览器复制了 Cookie,也未必能复用成功,因为这类值往往还有额外约束:
- 有效期很短,例如 5 分钟
- 绑定当前 IP
- 绑定 User-Agent
- 与生成时所在页面或来源上下文相关
一旦过期,或者环境不匹配,后端复算后的结果就会失效。
要绕过这类防护,请求方通常必须具备 JS 执行能力。现实中常见有两种路径:
- 使用 Puppeteer、Playwright 启动真实 Chromium 实例,让浏览器自动执行页面 JS 并维护 Cookie
- 逆向前端逻辑,在 Python 中用
execjs或手写等效算法模拟计算
但第二种方式只在目标逻辑较简单时才有操作空间。一旦页面里叠加了混淆、WebAssembly、Canvas 指纹等进阶干扰,单靠还原算法的成本会迅速升高,也更容易在细节上和真实浏览器行为出现偏差。
表单防刷场景下,怎么把 Cookie 校验做得更完整
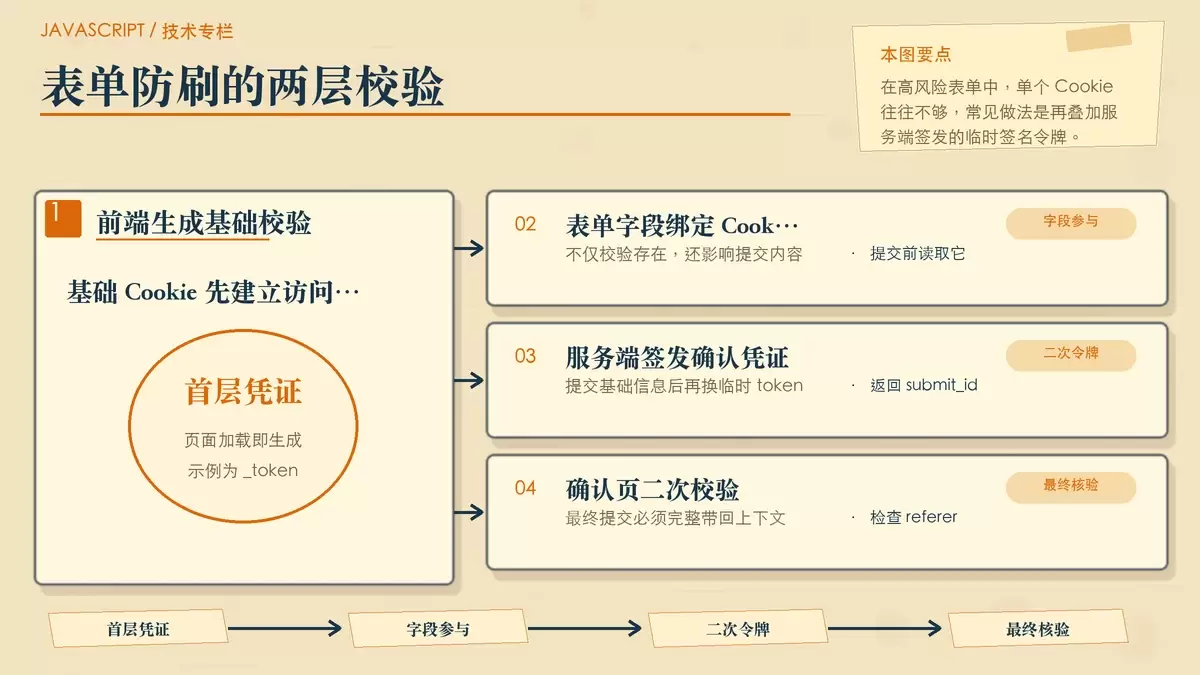
在询盘、注册、留言这类高风险表单中,动态 Cookie 通常不会单独使用,而是和服务端签发的一次性凭证组合起来,形成更长的校验链路。这样做的目的,是把攻击者从“伪造一个请求”提升到“串联完成整套页面流程”。
一种常见做法是叠加两层 Cookie 防护。
第一层:页面加载时先生成基础校验 Cookie
页面打开后,前端 JS 自动生成一个基础校验 Cookie,例如 _token。这个值不仅用于标记访问状态,还会在提交前参与表单字段加密。也就是说,攻击者即便知道表单字段名,也未必能直接构造出可通过校验的提交内容。
第二层:提交后再换取临时签名令牌
当用户先提交基础信息后,后端返回一个带签名的临时 token,例如 submit_id=abc123&sig=xxx,并跳转到确认页。最终提交时,客户端必须带上这个 token,而服务端会进一步校验:
- 签名是否正确
- 是否仍在有效时间内
- 来源
referer是否符合预期
这种“JS 生成 + 服务端签发 + 二次确认”的结构,能明显提高自动化模拟成本。普通脚本往往能完成单次请求,但很难稳定串联整个交互链路;而一旦缺少其中任一环,请求就会在后端校验时暴露问题。
因此,在实际防刷设计里,动态 Cookie 更适合作为流程门槛的一部分,而不是唯一防线。只有把浏览器执行、上下文签名、时效控制和提交链路结合起来,它的效果才会真正体现出来。









