Mac系统下Python pip包管理工具安装与使用指南
本文详细介绍在Mac系统中为Python2.7和Python3安装pip包管理工具的方法。针对Python2.7,可通过系统自带的easy_install手动安装;针对Python3,推荐使用get-pip.py脚本进行安装。文章还涵盖了版本查看、包列表查询及pip升级等常用操作,帮助开发者快速配置Python开发环境。
2026-10-12
22

本文详细介绍在Mac系统中为Python2.7和Python3安装pip包管理工具的方法。针对Python2.7,可通过系统自带的easy_install手动安装;针对Python3,推荐使用get-pip.py脚本进行安装。文章还涵盖了版本查看、包列表查询及pip升级等常用操作,帮助开发者快速配置Python开发环境。

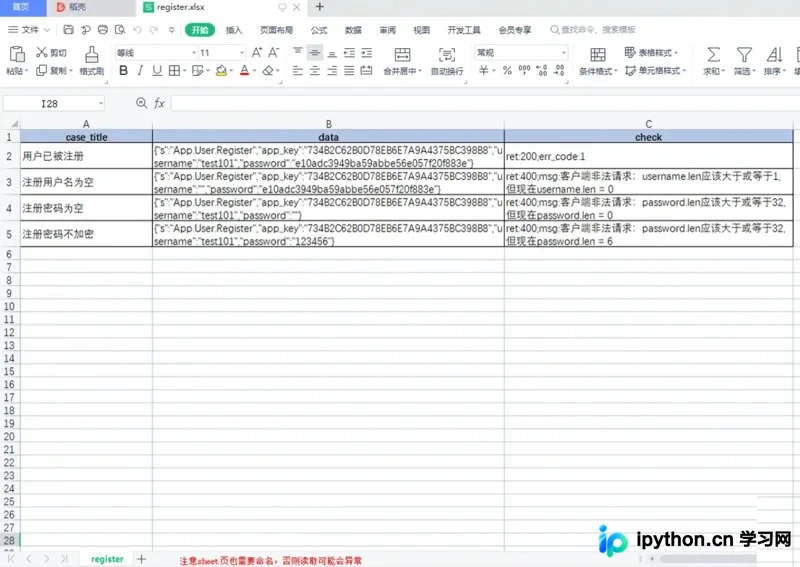
本文总结Python接口自动化测试中三种主流用例数据读取方法:xlrd、pandas和yaml。通过注册接口示例,详细解析各库的代码实现与优缺点。xlrd适合小规模数据,pandas擅长处理大型表格,而yaml凭借高可读性和模块隔离性成为复杂场景优选。文章提供完整代码片段及注意事项,帮助测试人员根据项目规模选择最佳方案。
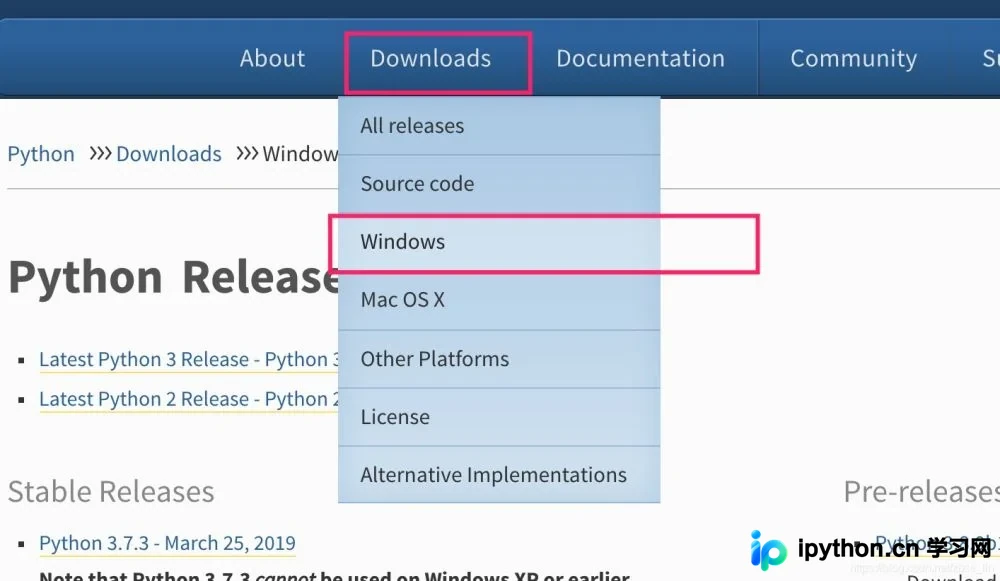
本文详细介绍在 Windows Server 2008 R2 标准版服务器上部署 Python 3.5.4 环境的完整流程。内容涵盖从官网下载离线安装包、管理员权限安装、配置环境变量,到使用 virtualenvwrapper-win 创建和管理自定义路径虚拟环境的详细步骤,帮助开发者在旧版 Windows 服务器中高效搭建 Python 运行环境。
本文深入解析Python中threading.Lock的使用方式。通过对比未加锁与加锁的代码示例,展示线程执行顺序的控制方法。详细阐述线程不安全的原因,介绍Lock类的工作原理,并探讨RLock解决死锁问题的机制,帮助开发者掌握多线程编程中的资源同步技巧。
本文深入解析pandas中pd.concat()函数的核心用法,详细讲解objs、axis、join等关键参数的含义与区别。通过上下堆叠与左右拼接两个实战案例,展示如何灵活处理Dataframe和Series的合并操作,帮助开发者掌握高效的数据合并技巧。
本文深入解析Python threading模块中的线程通信机制。通过互斥锁(Lock)解决多线程共享全局变量时的数据竞争问题,对比两种加锁实现方式。同时介绍Queue队列的基本操作及task_done与join的配合使用,并结合协程(yield)与线程的区别,详细演示生产者/消费者模式的代码实现与执行逻辑。
本文详细介绍Python列表中查找元素的两种核心方法:index()与count()。index()用于定位元素索引,支持start和end参数指定检索范围,但元素不存在时会引发ValueError;count()用于统计元素出现次数,可通过返回值判断元素是否存在。文章包含具体语法格式、参数说明及代码示例,帮助开发者高效处理列表数据。
本文详解利用Python进行电商评论情感分析的完整流程。通过SnowNLP计算每条评论的情感得分,结合Matplotlib绘制直方图与饼图分析正负向分布;利用Jieba进行分词、生成词云并提取高频关键词。重点解析如何识别“屏幕”、“充电”等负面因素,为提升产品品控与物流效率提供数据支持。
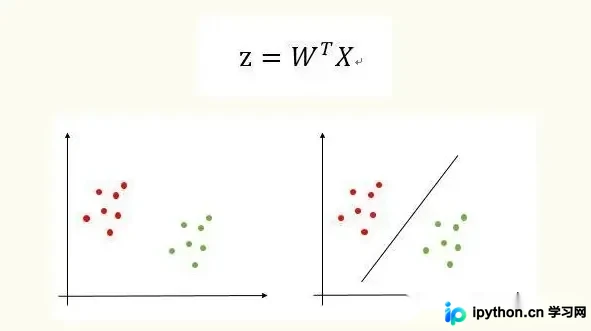
本文深入解析Logistic回归原理,从线性分类到概率映射,详解sigmoid函数与目标函数的构建。通过梯度上升法推导权重参数W,并结合Python代码实现数据读取、模型训练及可视化,帮助读者掌握这一经典分类算法的核心逻辑与实战应用。
本文深入解析Python第三方库orjson,其在基准测试中性能远超原生json及ujson等库。文章详细演示了dumps与loads的基础用法,并重点介绍OPT_INDENT_2、OPT_SERIALIZE_NUMPY等高级Option配置,以及如何通过default参数处理dataclass和datetime对象,帮助开发者实现高效、灵活的数据转换。
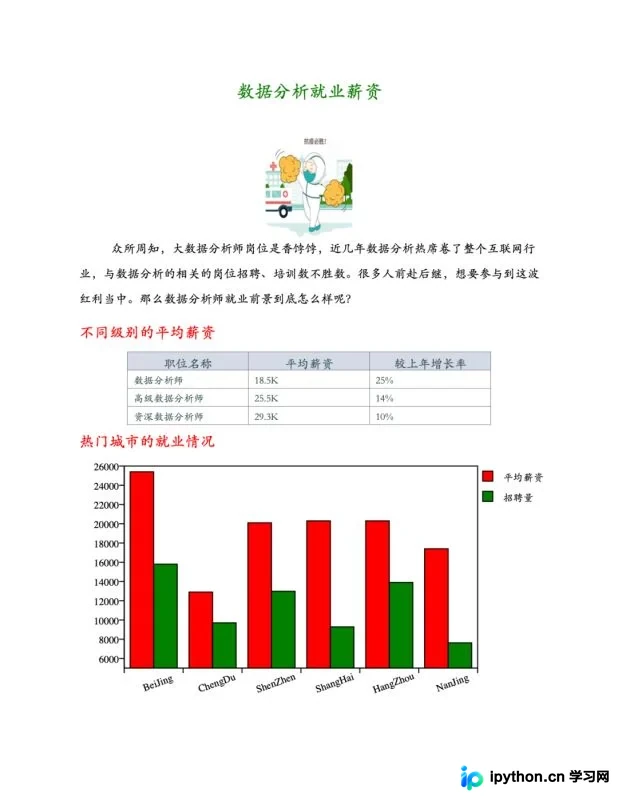
本文详解如何利用Python的ReportLab库生成包含文字、图片、表格及图表的PDF报告。通过封装Graphs类处理不同元素,并采用列表填充方式组装文档,最终输出专业格式的PDF文件。
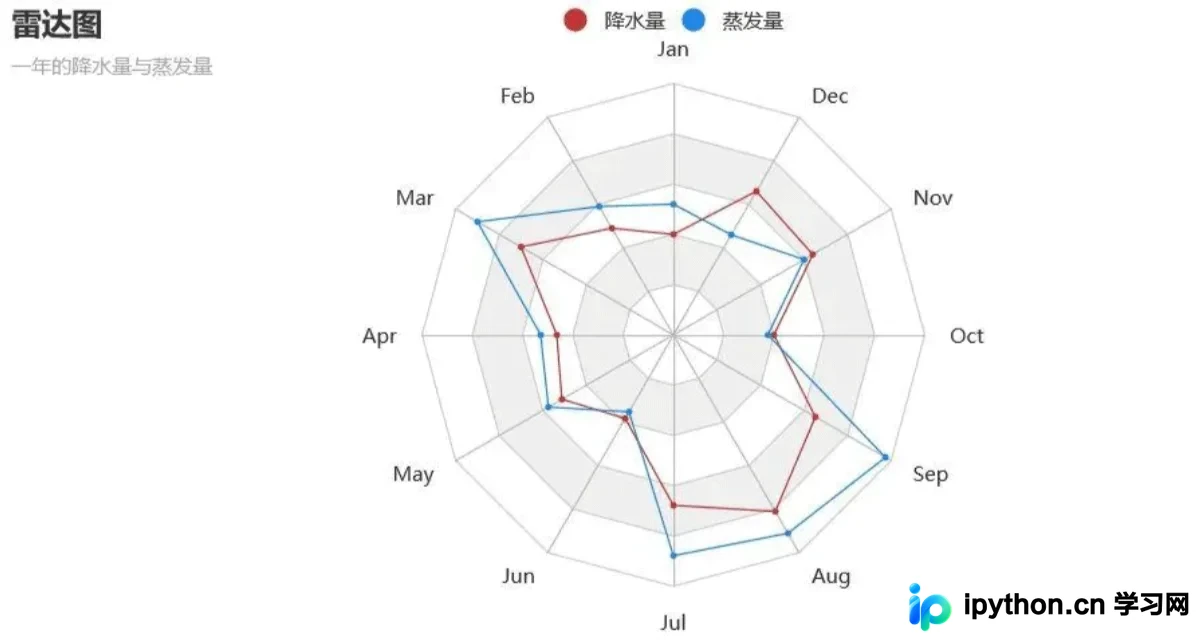
本文介绍如何使用Python库pyecharts进行数据可视化。pyecharts兼容Echarts,支持链式调用及多种图表类型。文章通过具体代码示例,演示了柱状图、饼图、箱线图、折线图、雷达图、散点图及图表布局Grid的创建与配置方法,并总结了从导入包到保存渲染的标准流程,帮助开发者快速上手。