

Python实战:基于SnowNLP与Jieba的电商评论情感分析全流程

发布时间:2026-10-12| 5人浏览过
本文详解利用Python进行电商评论情感分析的完整流程。通过SnowNLP计算每条评论的情感得分,结合Matplotlib绘制直方图与饼图分析正负向分布;利用Jieba进行分词、生成词云并提取高频关键词。重点解析如何识别“屏幕”、“充电”等负面因素,为提升产品品控与物流效率提供数据支持。
使用Python实现简易的情感分析项目
1 数据导入及预处理
1.1 数据导入
#  数据导入
import pandas as pd
data = pd.read_csv('../data/京东评论数据.csv')
data.head()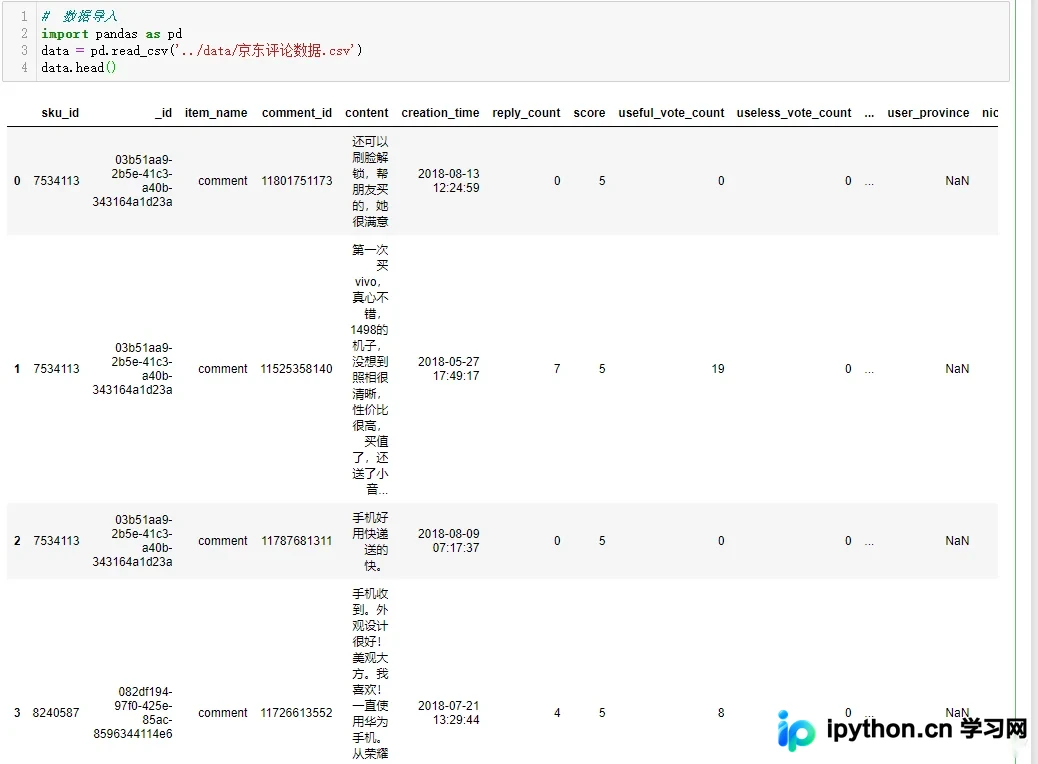
1.2 数据描述
#  数据描述
data.describe()
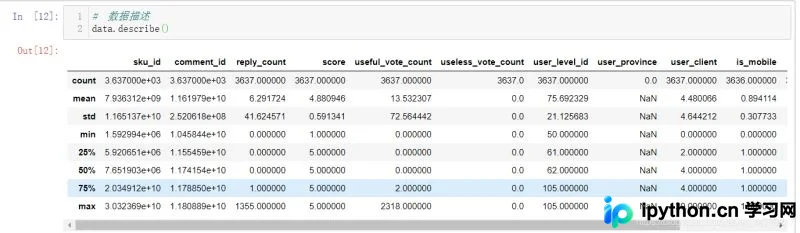
1.3 数据预处理
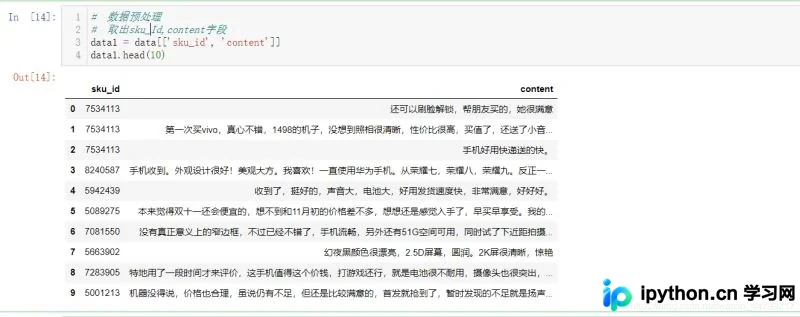
#  数据预处理
#  取出sku_Id,content字段
data1 = data[['sku_id', 'content']]
data1.head(10)
2 情感分析
2.1 情感分
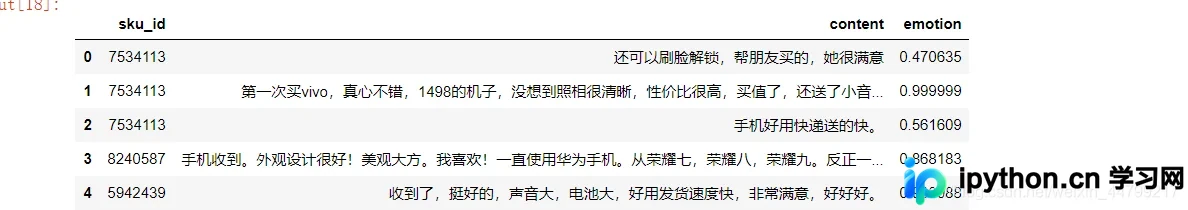
#  情感分析
from snownlp import SnowNLP
data1['emotion'] = data1['content'].apply(lambda x: SnowNLP(x).sentiments)
data1.head()
#  情感数据描述
data1.describe()
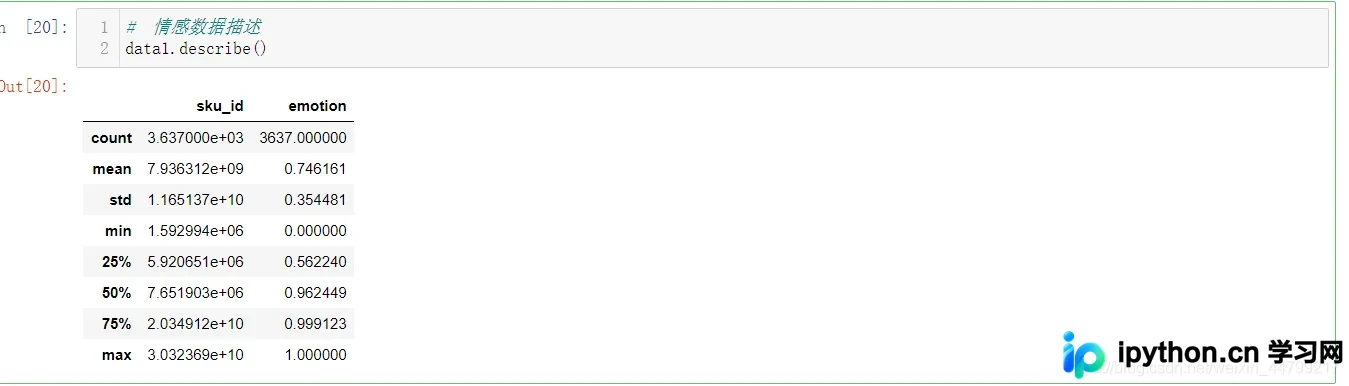
emotion字段的平均值显示为0.74,中位数为0.96,第25百分位数为0.56。这一分布特征表明,有超过25%的数据点数值较低,从而显著拉低了整体平均值。
2.2 情感分直方图
#  绘制情感分直方图
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False

bins = np.arange(0, 1.1, 0.1)
plt.hist(data1['emotion'], bins, color = '#4F94CD', alpha=0.9)
plt.xlim(0, 1)
plt.xlabel('情感分')
plt.ylabel('数量')
plt.title('情感分直方图')
plt.show()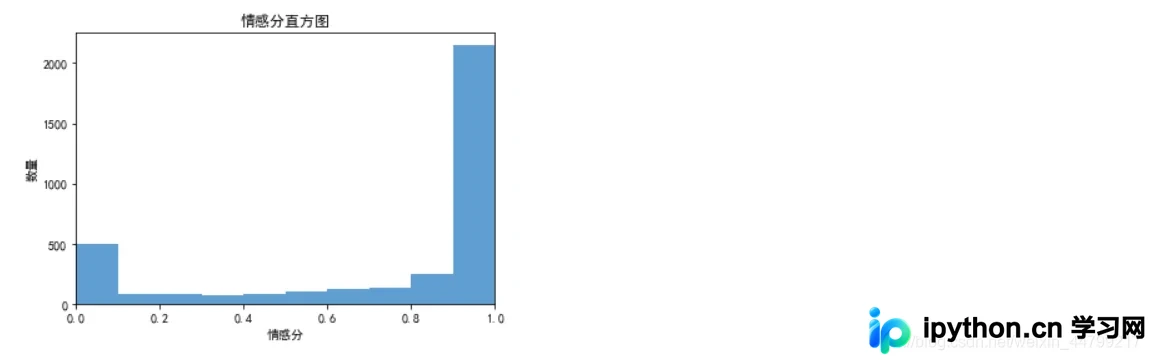
观察直方图分布可知,评论内容呈现出明显的两极分化现象;
在总计3637条评论中,约有2200条评论的情感得分集中在[0.9,1]的高分区间;与此同时,约有500条评论的情感得分落在[0,0.1]的低分区间。
2.3 词云图
#  绘制词云图(这儿没有做停用词处理)
from wordcloud import WordCloud
import jieba

myfont = myfont = r'C:\Windows\Fonts\simhei.ttf'
w = WordCloud(font_path=myfont)
text = ''
for i in data['content']:
    text += i
data_cut = ' '.join(jieba.lcut(text))
w.generate(data_cut)
image = w.to_file('词云图.png')
image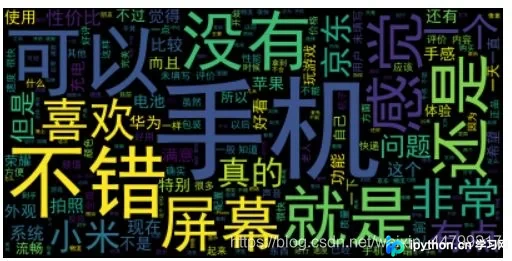
2.4 关键词提取
#  关键词提取top10
#  这儿直接写import jieba运行会显示没有analyse属性
from jieba import analyse

key_words = jieba.analyse.extract_tags(sentence=text, topK=10, withWeight=True, allowPOS=())
key_words
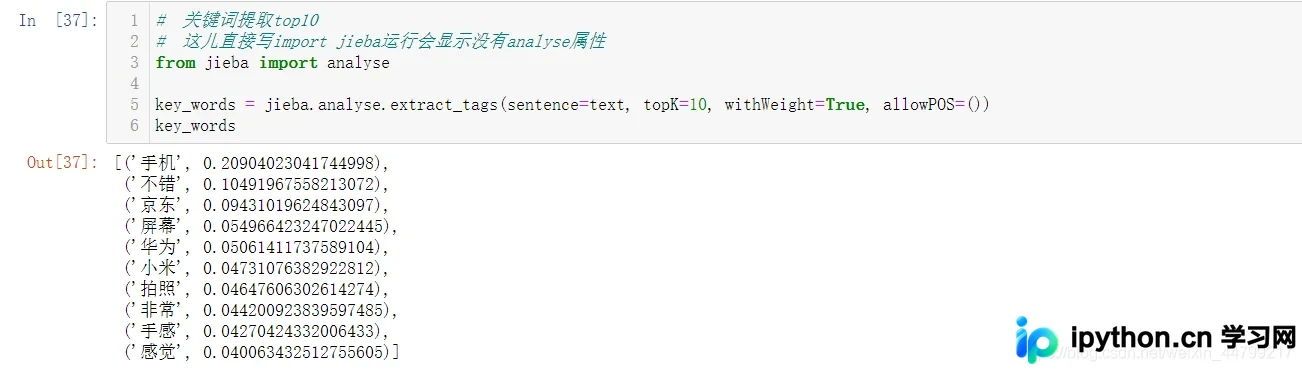
上述关键词分析结果反映出,消费者在选购手机时较为关注“屏幕”、“拍照”以及“手感”等核心特性;而在品牌维度上,“华为”与“小米”是出现频率最高的两个手机品牌。
参数说明 :
- sentence:待提取的字符串,必须为str类型,不支持list类型
- topK:指定提取前多少个关键字
- withWeight:布尔值,决定是否返回每个关键词对应的权重
- allowPOS:允许提取的词性列表,默认值为allowPOS=‘ns’, ‘n’, ‘vn’, ‘v’,即提取地名、普通名词、名动词及动词
3 积极评论与消极评论
3.1 积极评论与消极评论占比
#  计算积极评论与消极评论各自的数目
pos, neg = 0, 0
for i in data1['emotion']:
    if i >= 0.5:
        pos += 1
    else:
        neg += 1
print('积极评论数目为:', pos, '\n消极评论数目为:', neg)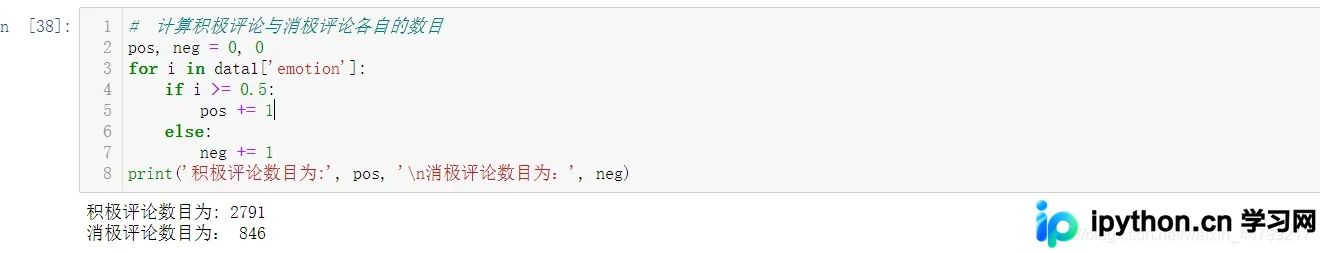
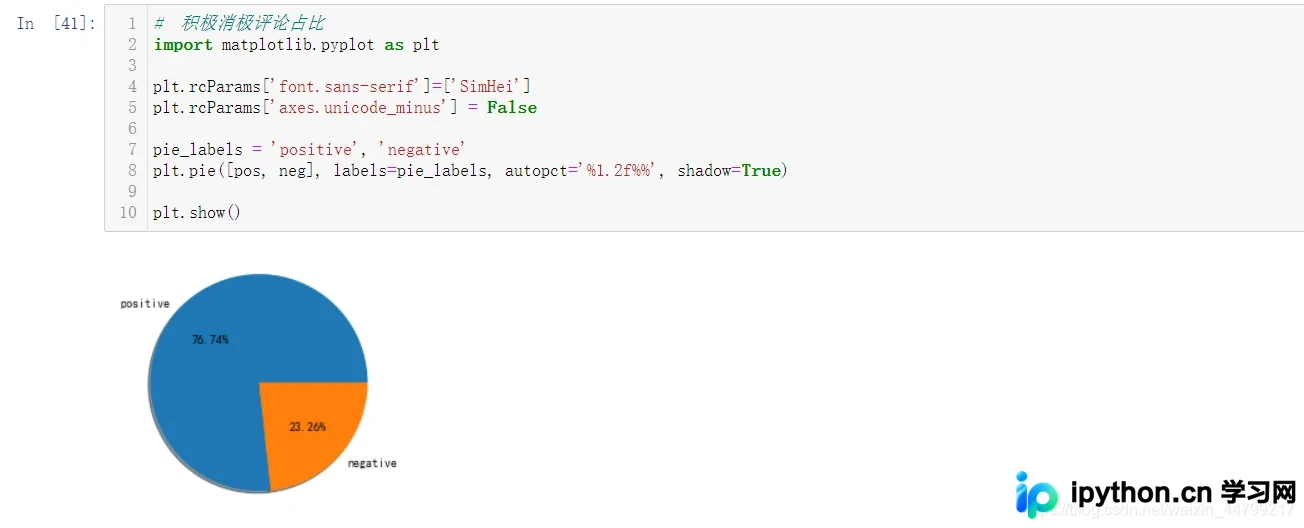
#  积极消极评论占比
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif']=['SimHei']
plt.rcParams['axes.unicode_minus'] = False

pie_labels = 'positive', 'negative'
plt.pie([pos, neg], labels=pie_labels, autopct='%1.2f%%', shadow=True)

plt.show()
3.2 消极评论分析
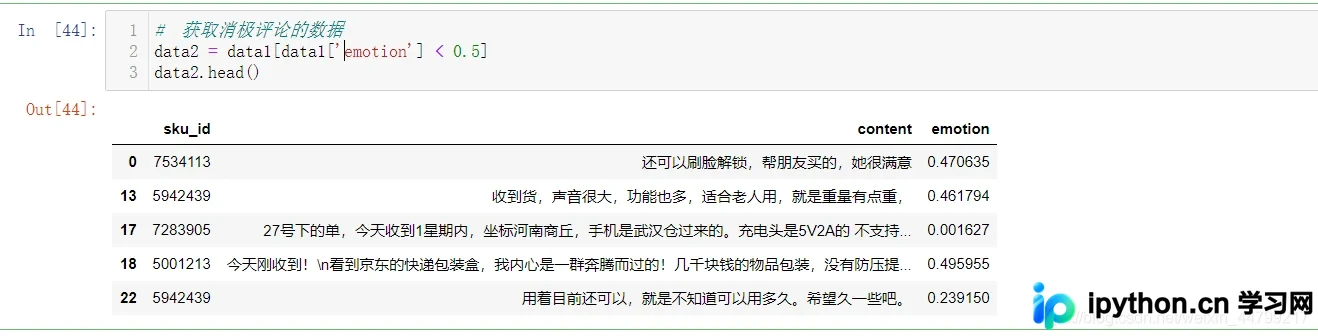
#  获取消极评论的数据
data2 = data1[data1['emotion'] < 0.5]
data2.head()
#消极评论词云图(这儿没有做停用词处理)
text2 = ''
for s in data2['content']:
    text2 += s
data_cut2 = ' '.join(jieba.lcut(text2))
w.generate(data_cut2)
image = w.to_file('消极评论词云.png')
image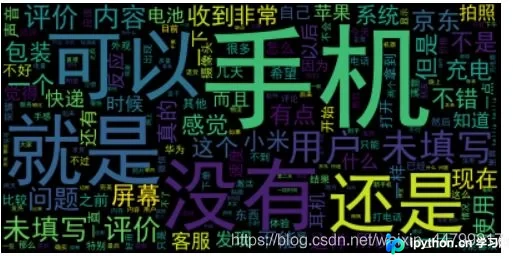
#消极评论关键词top10
key_words = jieba.analyse.extract_tags(sentence=text2, topK=10, withWeight=True, allowPOS=())
key_words
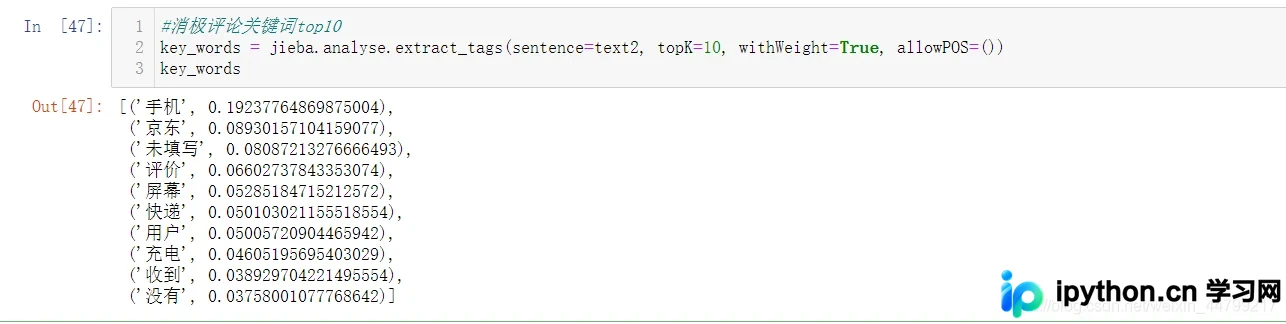
对消极评论关键词的分析显示,“屏幕”、“快递”和“充电”是导致用户体验不佳的几个关键因素;其中,屏幕显示异常和充电问题可能源于手机不良品率较高或物流快递过程中的物理压迫;
因此,平台方应着重加强手机生产环节的品控管理,以降低不良品率;此外,还需致力于提升发货、配送及末端派件的效率与服务质量。
总结
至此,关于利用Python实现简单情感分析的教程介绍完毕,更多相关Python情感分析内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









