Python dnspython模块DNS解析实战:安装与A/MX/NS/CNAME记录查询
本文详细介绍Python中dnspython模块的安装方法及DNS解析实战。涵盖源码安装步骤,解析器类query方法的参数说明,以及A、MX、NS、CNAME等常见记录的查询代码实现。最后通过结合httplib2实现基于DNS轮询的业务IP监控示例,帮助开发者掌握自动化DNS处理技巧。
2026-10-12
26

本文详细介绍Python中dnspython模块的安装方法及DNS解析实战。涵盖源码安装步骤,解析器类query方法的参数说明,以及A、MX、NS、CNAME等常见记录的查询代码实现。最后通过结合httplib2实现基于DNS轮询的业务IP监控示例,帮助开发者掌握自动化DNS处理技巧。
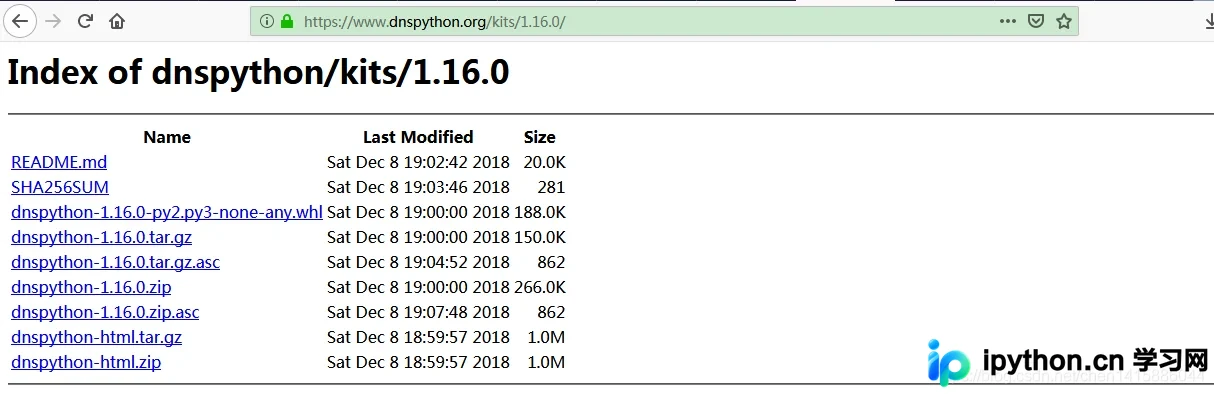
本文深入解析梯度下降算法原理,对比传统数值解法的局限性,如局部最优和收敛效率问题。通过泰勒展开推导学习率公式,并展示Python代码在Logistic回归中的应用,帮助读者掌握算法核心逻辑与工程实现细节。
本文深入解析Python中的双下方法(Dunder Methods),涵盖__init__初始化、各类运算符重载(比较、算术、位运算)、字符串与数值转换、集合与迭代协议,以及对象创建销毁和属性管理。通过尺子与二进制字符串等实例,展示如何自定义类行为,提升代码灵活性与可维护性。
本文详细解析Python中文件读取的三个核心方法:read、readline和readlines。read一次性读取全部内容为字符串;readline逐行读取返回单行字符串;readlines将所有行存入列表。通过示例演示了各方法的语法、执行结果及seek指针控制技巧,帮助开发者根据内存和数据处理需求选择合适的方法。
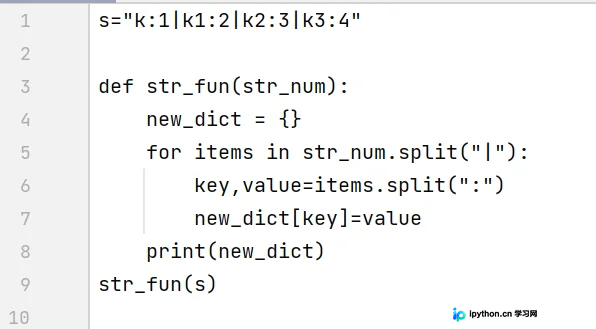
本文系统梳理Python中列表与元组的常见操作方法,涵盖长度获取、元素查找、追加插入、排序反转及清空复制等核心功能。重点解析append、insert、remove、sort、clear、copy等内置函数的使用细节与注意事项,并深入探讨二次赋值与copy的区别,以及浅拷贝与深拷贝在嵌套数据结构中的内存表现,帮助开发者掌握高效的数据处理技巧。
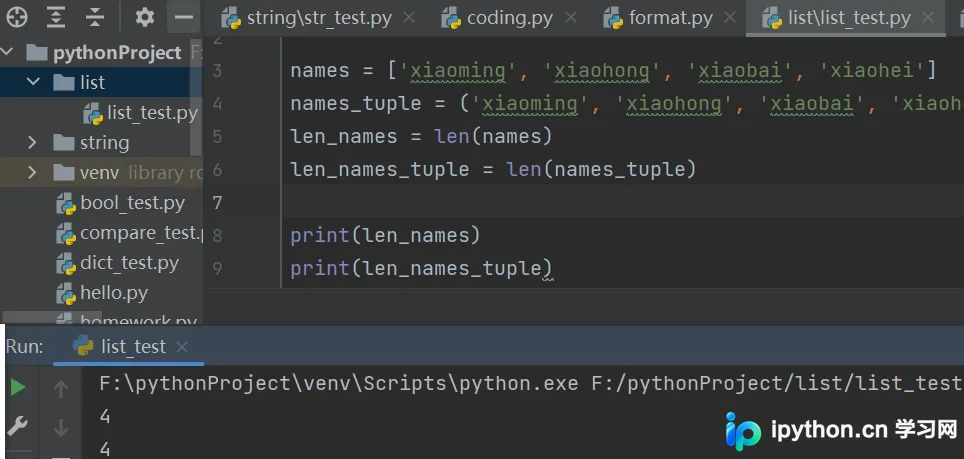
本文详细介绍Pandas库中df.fillna()函数的使用方法,涵盖固定值填充、前后向填充(ffill/bfill)及基于统计量的填充策略。通过具体代码示例解析value、method、inplace等关键参数的应用,并对比df.replace()替代方案,帮助开发者高效处理数据中的缺失值。
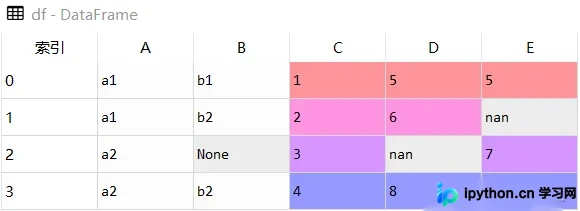
本文详解Python中字符串的常用处理方法与运算符。重点介绍strip()、lstrip()和rstrip()三种去空格函数的用法差异,并逐一演示+、*、in、not in、is、is not、==及!=等运算符的具体行为与返回值,帮助开发者掌握字符串操作核心技巧。
本文介绍Pandas中df.shape属性的使用方法,用于获取Dataframe的行数和列数。df.shape返回一个元组,第一个元素为行数,第二个为列数。通过示例代码展示如何提取具体行列数值,并说明Series对象的shape特性。
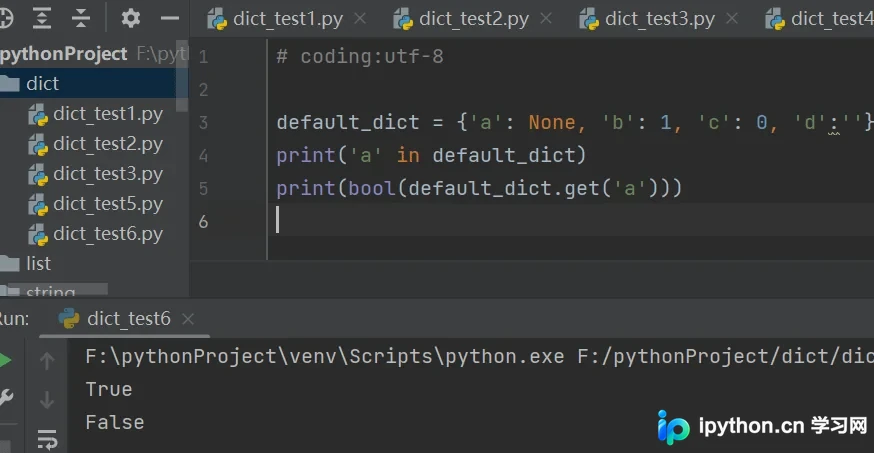
本文详细解析Python字典的常见操作,包括使用in、not in及get()函数判断键是否存在,并指出get()在值为False或None时的局限性。深入讲解popitem()方法用于删除并返回末尾键值对的用法及空字典报错处理。最后通过代码示例对比浅拷贝与深拷贝在修改嵌套对象时的内存地址差异,帮助开发者准确掌握字典操作细节。
本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
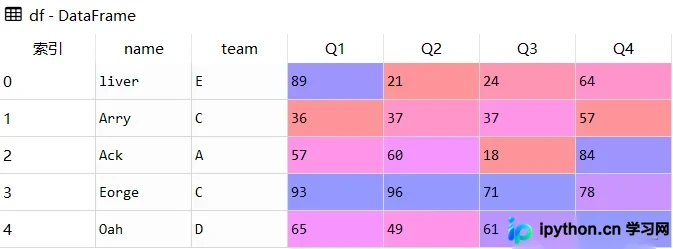
本文详解pandas中处理重复数据的两个核心方法:duplicated()与drop_duplicates()。通过DataFrame、Series及Index三种对象的示例,解析subset与keep参数的具体行为,并演示如何根据品牌或全部列识别重复项,以及如何直接删除重复数据以完成数据清洗。
本文系统梳理Python数学建模核心知识,详解预测、优化、评价三大模型及十大常用算法。结合Pandas库实战,演示CSV/Excel读取、Series与DataFrame数据结构操作,涵盖单值、批量、区间及条件查询技巧,并解决数据类型转换等常见报错,助力掌握建模与数据处理全流程。