

Python Scrapy爬虫将控制台日志重定向至文本文件的方法
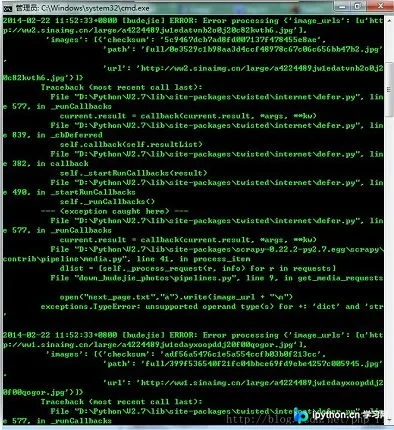
本文介绍如何在Windows环境下使用Scrapy框架时,将控制台打印的运行及调试信息保存至文本文件。通过指定LOG_FILE参数,解决CMD窗口信息滚动导致无法查看完整日志的问题,便于后续排查爬虫运行中的错误或调试细节。
2026-10-13
23

本文介绍如何在Windows环境下使用Scrapy框架时,将控制台打印的运行及调试信息保存至文本文件。通过指定LOG_FILE参数,解决CMD窗口信息滚动导致无法查看完整日志的问题,便于后续排查爬虫运行中的错误或调试细节。
本文详细演示了使用Python进行数据抓取与分析的完整流程。通过requests获取页面,利用BeautifulSoup和XPath解析HTML及JS动态数据,并将结果存入MongoDB。文章涵盖分类网址获取、产品详情页抓取、数据清洗入库及异常处理等核心步骤,提供具体代码实现供参考。
本文介绍如何使用Python生成随机日期字符串并插入数据库。通过设定起止时间元组,转换为时间戳后随机选取,再格式化为指定字符串。示例代码展示了从时间元组到时间戳,再到格式化输出的完整流程,适用于需要批量生成测试数据的场景。
本文深入解析Python中的回归树算法,提供完整的代码实现。内容涵盖数据加载、二元切分、树构建及剪枝策略,并对比普通回归树与模型树的预测效果。通过计算相关系数评估模型性能,帮助开发者掌握连续值回归预测的核心技术。
本文详细介绍Python nose单元测试框架的安装方法及核心特性。涵盖测试用例命名规则、命令行常用参数(如-v、-s、-h)的使用,以及如何通过nose_ittr插件实现测试方法传参,并利用nose-html-reporting生成HTML测试报告。同时解析nose.tools模块中@nottest和@istest修饰器的应用,提供完整的代码示例与执行流程,帮助开发者高效构建自动化测试体系。
本文深入解析Python中eval()与exec()函数的核心区别,详细阐述globals()、locals()及compile()函数的定义、参数与返回值机制。通过代码实例说明命名空间在动态执行中的作用,并对比Python 2与Python 3中exec语句的变化,帮助开发者安全高效地使用动态代码执行功能。
本文详细解析Django模板中include标签的变量传递机制,并指导如何创建自定义templatetags包。通过示例演示如何编写Python过滤器函数并在HTML中加载使用,实现如分页逻辑等复杂功能,帮助开发者掌握Django模板的高级用法。
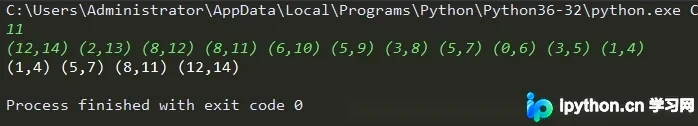
本文深入解析Python中贪心算法在解决活动安排问题中的应用。通过按结束时间排序并迭代选择相容活动,实现最大活动数量计算。文章提供完整的冒泡排序与贪心选择代码示例,详细阐述局部最优到全局最优的转化逻辑及代码执行流程,帮助开发者掌握区间调度算法的核心实现。
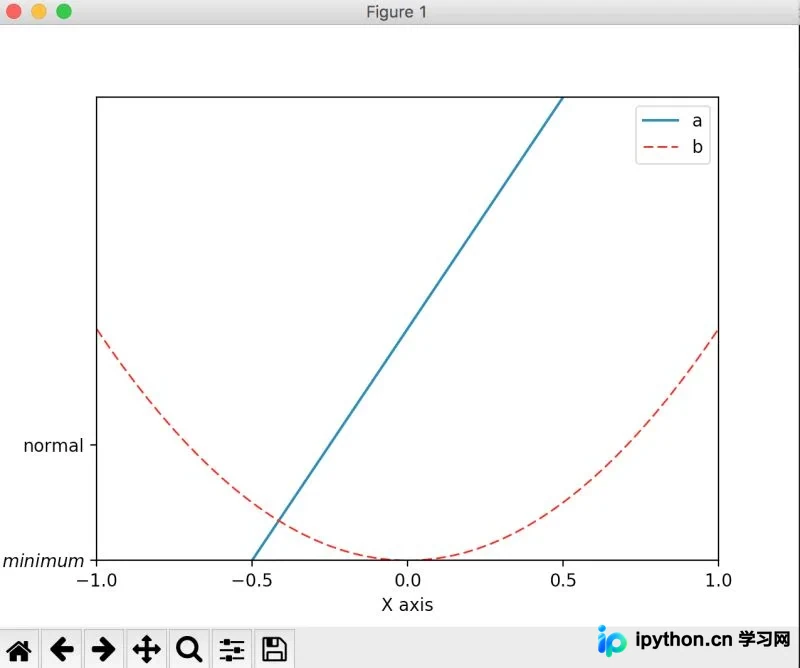
本文介绍Matplotlib中设置图例(legend)的基本用法。通过示例代码展示如何在绘制曲线时添加标签,并使用plt.legend()函数自定义图例的句柄、标签文本及显示位置。包含完整的坐标轴设置与刻度调整代码,帮助开发者快速掌握图例配置技巧。
本文介绍在Python数据挖掘场景中,如何通过封装方法并利用[[wp:a1]]中的cached_property实现结果的缓存与延迟加载。通过示例展示,该方法确保复杂计算仅执行一次,后续调用直接返回缓存值,从而显著提升重复调用时的性能与资源利用率。
本文介绍如何使用Python3编写程序计算三角形面积。通过获取用户输入的三边长度,利用海伦公式计算半周长及面积,并输出保留两位小数的结果。代码包含完整的输入处理与数学运算逻辑,适合Python初学者参考学习。
本文介绍如何使用Python脚本解决Navicat导入MySQL视图时因依赖顺序导致的报错问题。通过查询information_schema.VIEWS获取视图定义,利用迭代算法重新排序视图创建语句,确保被依赖视图先创建,从而自动化生成正确的SQL导出文件。