

Python正则表达式匹配中文字符的实现方法
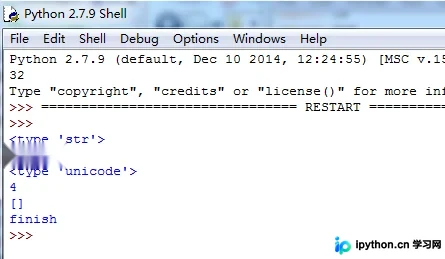
本文详细介绍在Python中使用正则表达式匹配中文字符的方法。核心思路是将字符串转换为Unicode格式,利用[u\u4e00-\u9fa5]模式进行匹配,并注意文件编码(如GBK)的转换。文中提供了完整代码示例及在线正则测试工具链接,帮助开发者高效处理中文文本。
2026-10-13
11

本文详细介绍在Python中使用正则表达式匹配中文字符的方法。核心思路是将字符串转换为Unicode格式,利用[u\u4e00-\u9fa5]模式进行匹配,并注意文件编码(如GBK)的转换。文中提供了完整代码示例及在线正则测试工具链接,帮助开发者高效处理中文文本。
本文介绍了一个基于Python的数据库定时任务自动重试方案。针对下游依赖上游数据产出失败的场景,脚本通过循环检测与延时重试机制,自动执行SQL查询直至获取有效数据或达到最大重试次数,有效减少人工干预。
本文系统总结Python中常见的格式化输出方式,涵盖字符串、整数及浮点数的打印技巧。重点解析如何指定小数位数、控制占位符宽度与对齐方式,以及使用0作为填充字符的方法,最后介绍科学计数法的格式化输出,帮助开发者掌握高效的文本格式化处理。
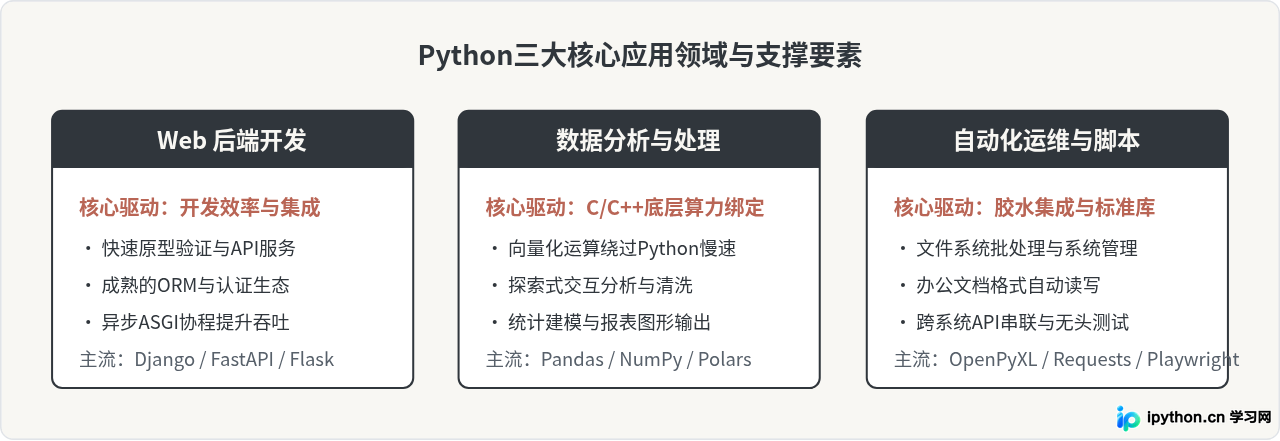
详细解析Python在Web开发、数据分析和日常自动化三个主力领域的具体适用场景、典型技术栈、代码示例与不适用边界。
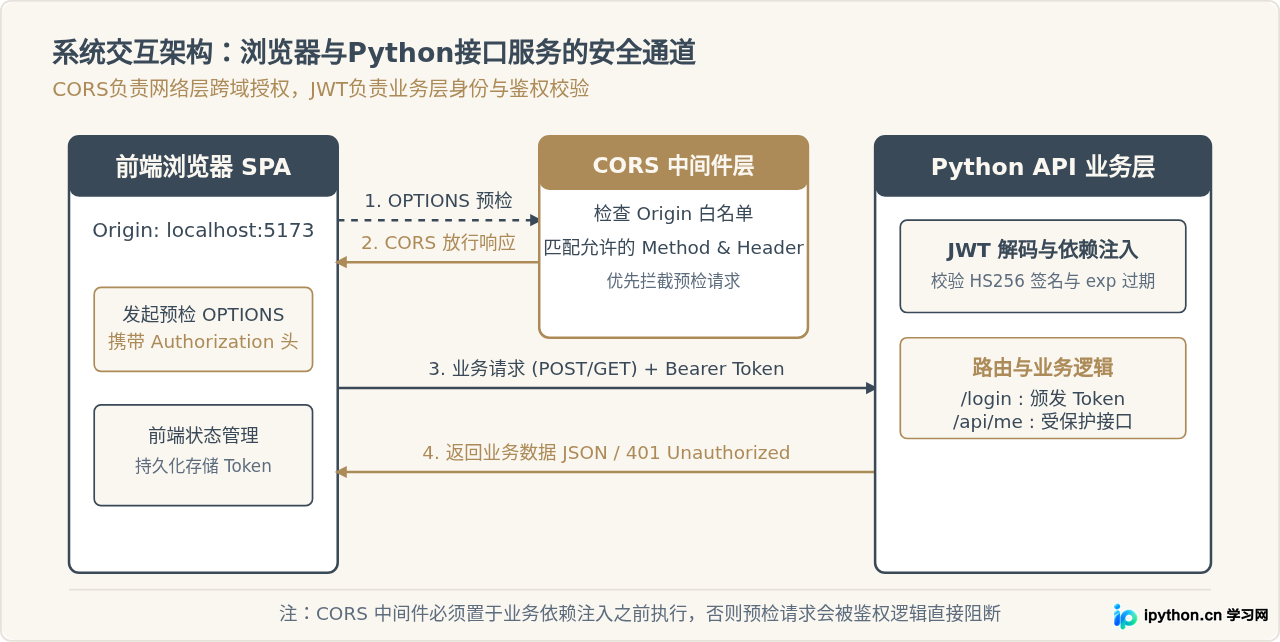
本文详细讲解如何在Python接口服务中完整实现JWT身份验证与CORS跨域处理,包含环境安装、流程解析、代码实现、预检请求调试与排错方法。
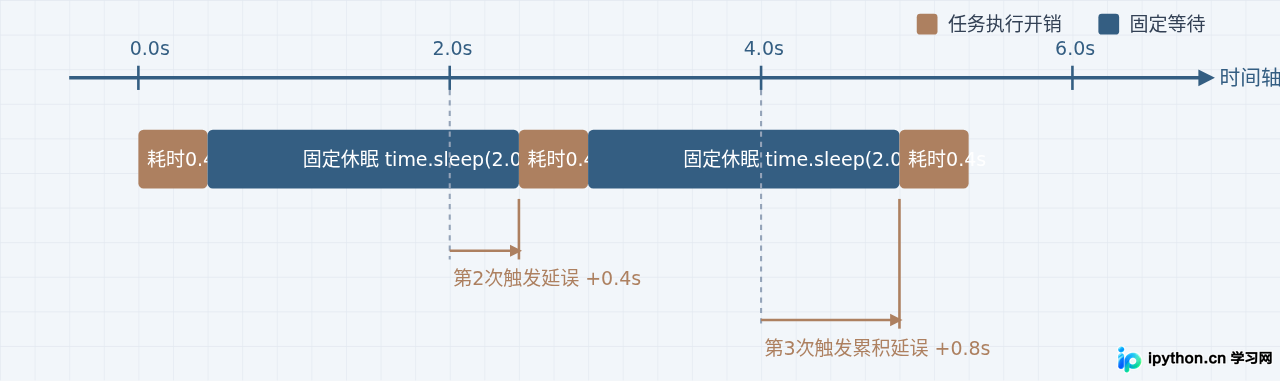
针对Python中使用time.sleep设置2秒间隔时,因业务逻辑耗时导致实际执行周期不断拉长、产生时间漂移的问题,本文提供三种直接可用的修正方案与代码实现。
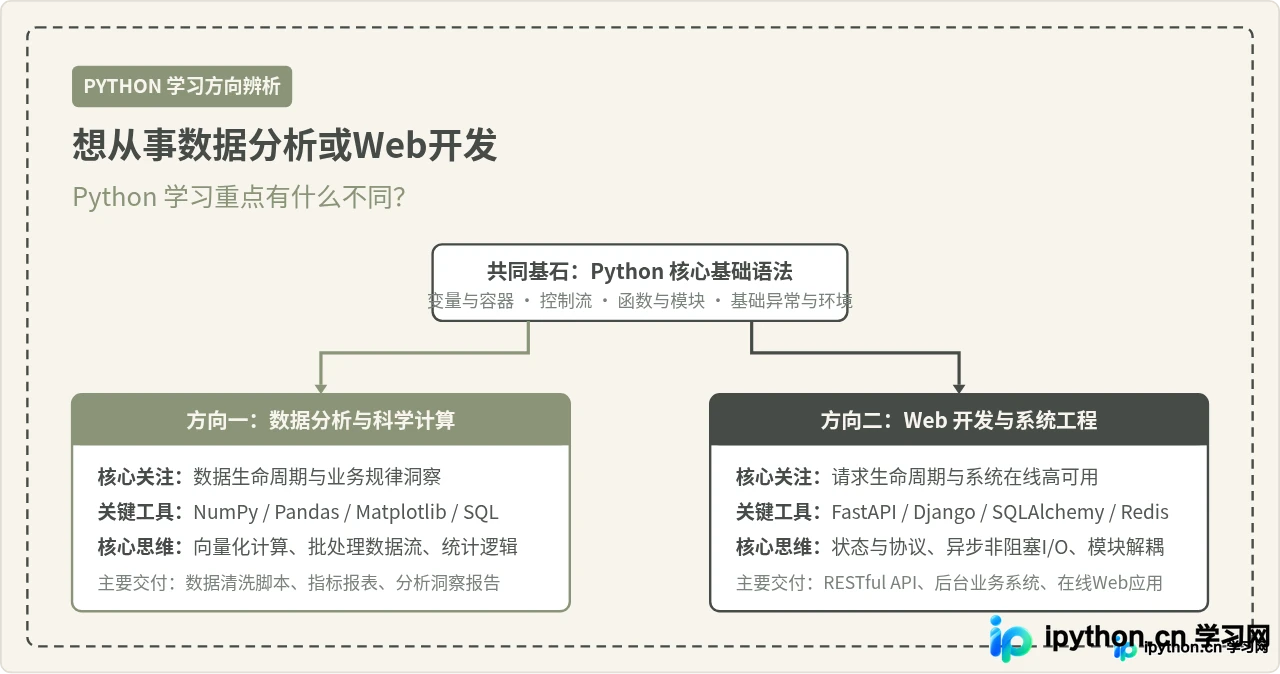
对比想从事数据分析与Web开发两个方向的Python学习重点差异,从通用基础分界、核心工具链、思维模型区别、常见认知误区到选型决策,提供清晰实用的学习路径解析。
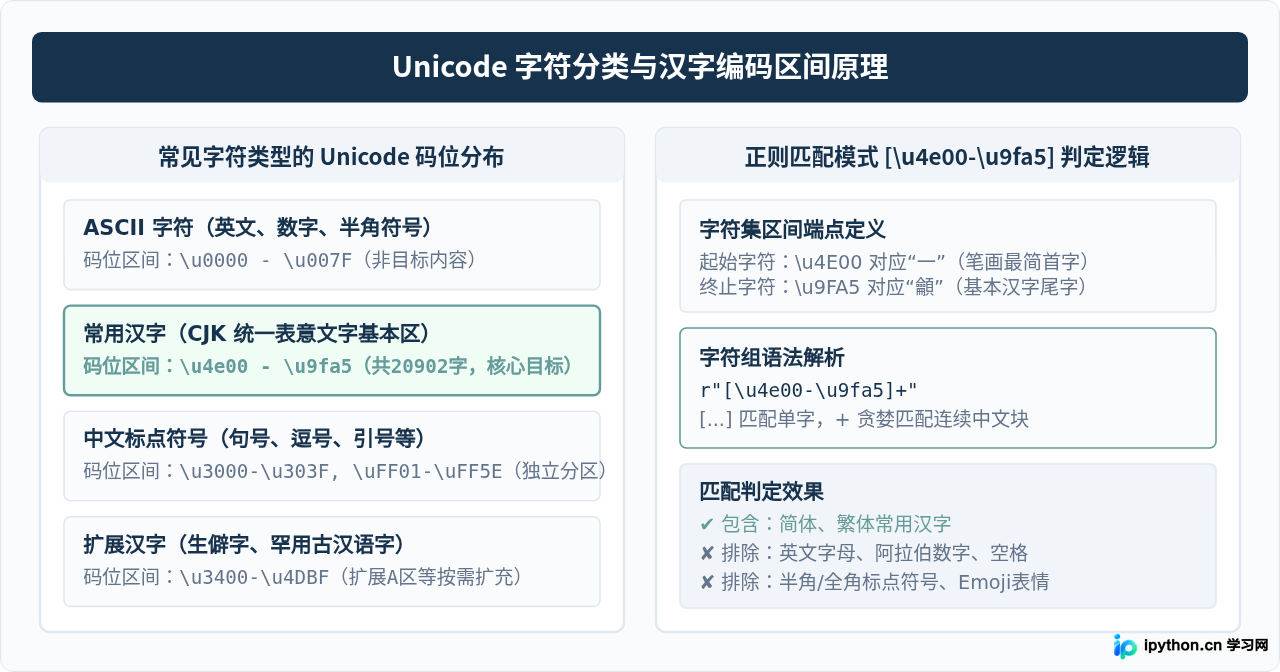
详细讲解在Python中使用正则表达式提取字符串中纯中文内容的实用方法,对比re.findall与re.sub的实现差异、Unicode编码区间原理、标点符号边界处理及性能优化实践。
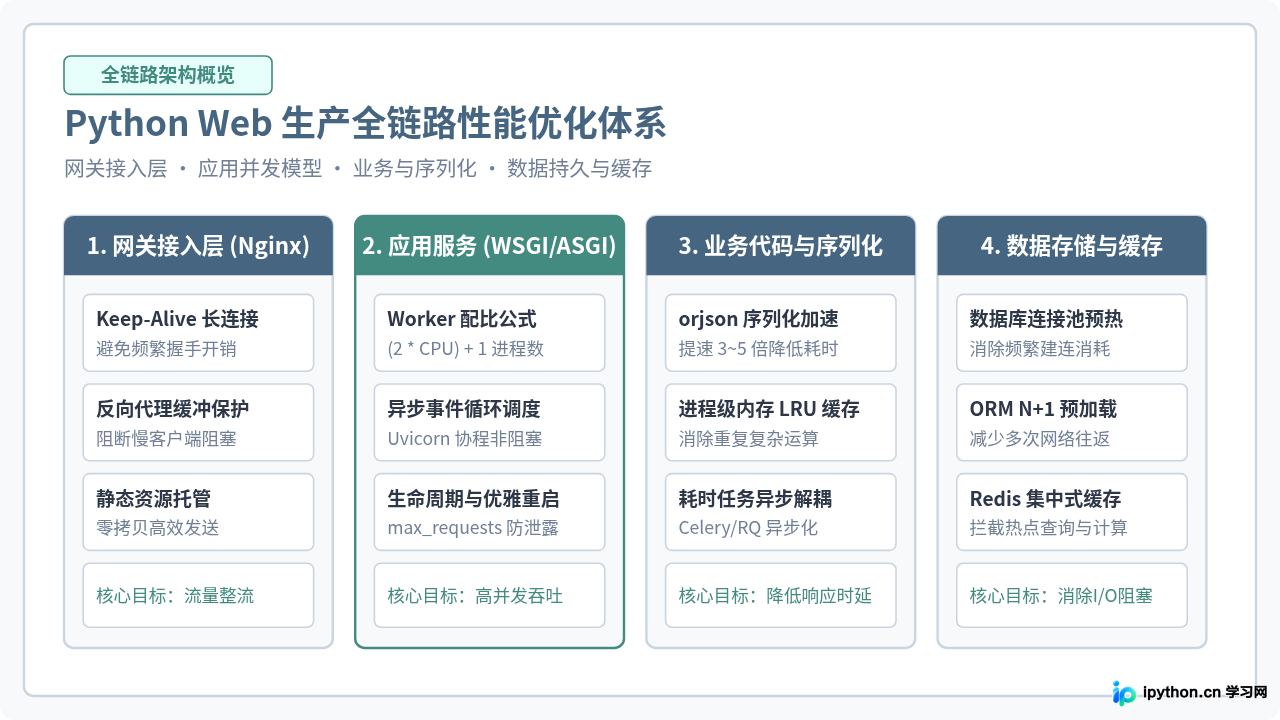
深入探讨Python Web框架性能优化,从代码层序列化与异步选型、数据库ORM治理与连接池,到Gunicorn/Uvicorn服务器及Nginx网关部署的全链路最佳实践。
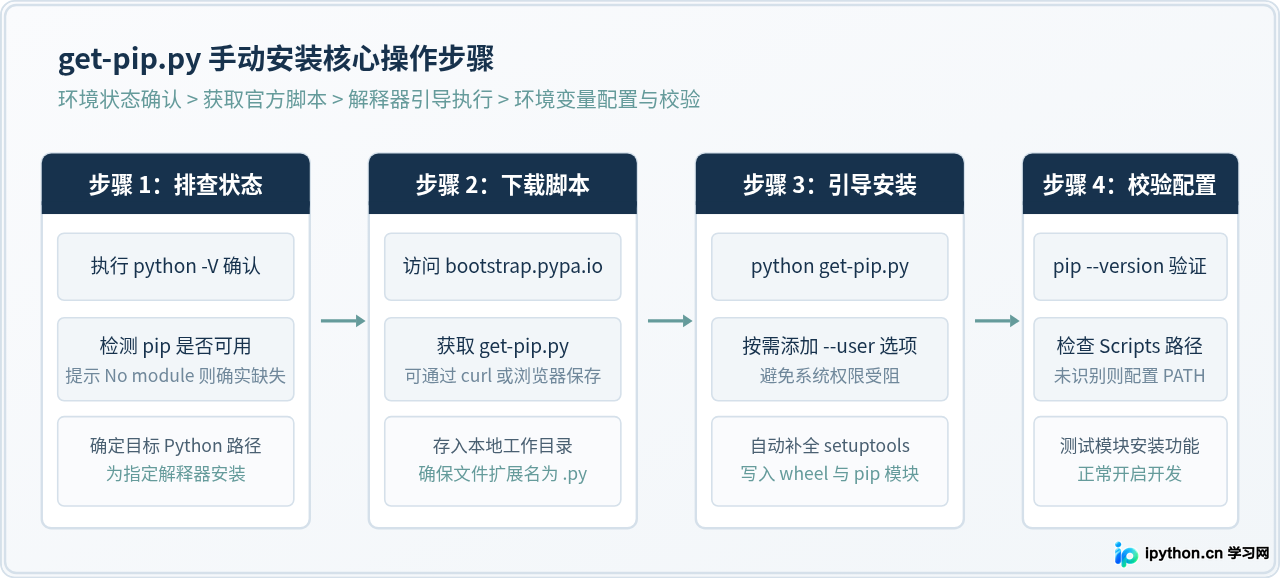
详细介绍在Python没有预装或误删pip情况下的手动安装教程,重点讲解官方get-pip.py脚本的下载、执行安装、权限与网络报错处理及环境变量配置。
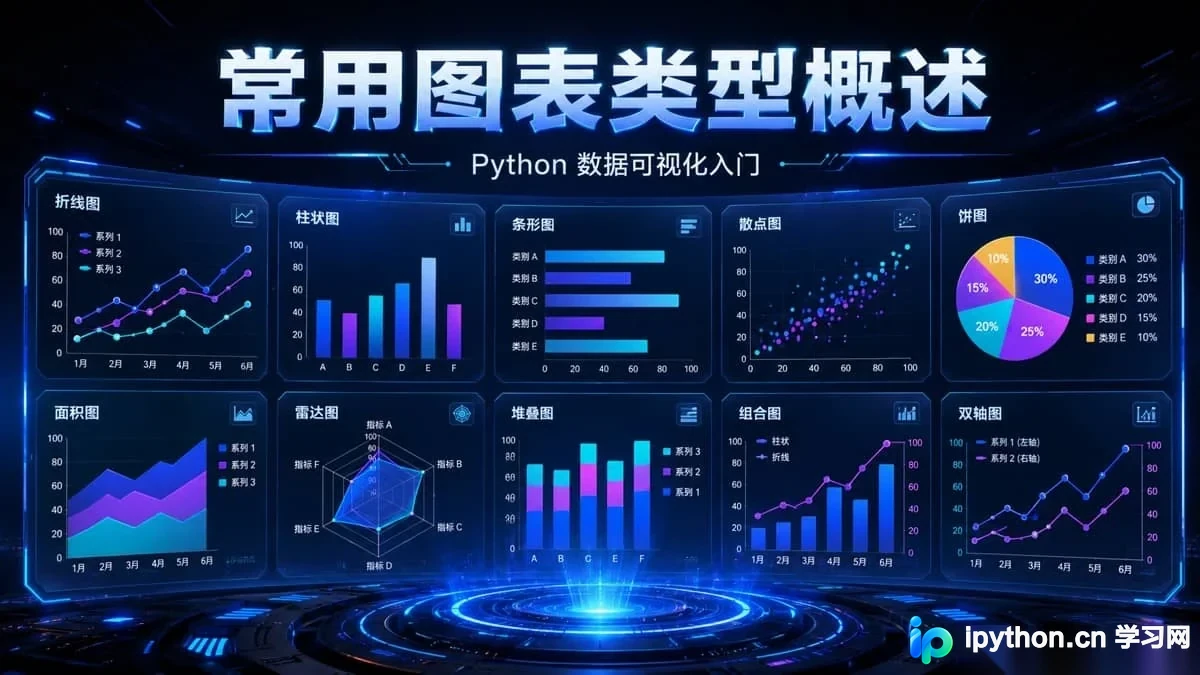
本文针对Excel数据分析场景,系统梳理Python常用图表类型的适用边界与选择逻辑。通过标准化的数据读取、清洗与Matplotlib绘图流程,详解折线、柱状、条形及散点图等核心代码实现与参数配置,结合排版避坑指南,帮助开发者快速定位数据表达需求并输出高质量报表。
在Python中获取字符串末尾字符有多种实现方式,本文梳理了负数索引、长度计算与切片操作等核心方法,并说明空字符串场景下的安全处理策略。掌握不同取值的类型差异与边界条件,可直接提升日常文本解析代码的健壮性。