

Python自动化处理Word题库:去除冗余与修正格式实战
本文介绍如何利用Python的python-docx库自动化处理杂乱的Word题库文档。通过遍历段落、识别特定字符(如序号后的点号、选项符号)及过滤无效行,实现自动删除多余空白、修正错误题号、合并选项行及移除“窗体顶端/底端”等冗余内容,最终生成格式规范的标准化文档。
2026-10-14
11

本文介绍如何利用Python的python-docx库自动化处理杂乱的Word题库文档。通过遍历段落、识别特定字符(如序号后的点号、选项符号)及过滤无效行,实现自动删除多余空白、修正错误题号、合并选项行及移除“窗体顶端/底端”等冗余内容,最终生成格式规范的标准化文档。
本文深入解析 Python 两大主流测试框架 unittest 与 pytest 的核心差异。unittest 作为标准库,结构严谨但语法繁琐;pytest 凭借简洁的 assert 语句、强大的 Fixture 机制及丰富的插件生态,显著提升了测试编写效率。文章通过代码示例与特性对比,帮助开发者根据项目需求选择最合适的测试工具。
本文介绍Python中处理文件编码与类型识别的两个核心模块。针对ConfigParser读取非UTF-8配置文件时的UnicodeDecodeError,演示如何使用chardet模块自动检测文件编码并正确读取。同时讲解mimetypes模块通过文件名或URL获取MIME类型及对应文件扩展名的方法,涵盖guess_type与guess_all_extensions函数的具体用法与参数说明。
本文深入解析Python装饰器的核心原理,通过逐步演进的代码示例,讲解如何从基础函数包装过渡到使用柯里化技术处理参数。重点剖析了装饰器对原函数__name__和__doc__属性的影响,并提供了两种修复方案:手动复制属性与将属性复制逻辑封装为装饰器。最后介绍了带参装饰器的实现方式,帮助开发者掌握高阶函数应用。
本文详细记录在Windows 10环境下,使用Anaconda和PyCharm安装TensorFlow 2.2的完整流程。涵盖从Visual Studio、Anaconda基础安装,到创建独立conda环境、配置CUDA 10.1与cuDNN 7.6 GPU支持,以及最后在PyCharm中绑定解释器并验证安装成功的全过程。
本文深入解析Django中F()函数的核心机制与应用场景。通过对比传统内存更新方式,阐述F()函数如何实现数据库层面的原子操作,从而显著提升性能并避免并发竞争问题。同时覆盖跨字段比较、算术运算、日期处理及跨关系查询等高级用法,帮助开发者写出更高效、安全的ORM代码。
本文详细解析 Python 中 docutils 工具的文档编译流程。通过下载官方源码、配置环境及执行 buildhtml.py 脚本,可将 reStructuredText 格式的源文件转换为 HTML。文章提供了具体的命令行操作示例及路径配置建议,帮助用户快速生成支持中文的本地文档手册。
本文介绍在TensorFlow 2.0环境下训练模型后,如何将其转换为适用于TF 1.x的.pb模型文件。针对TF 2.0不再保存.meta文件的情况,提供了一种通过Keras中间层进行转换的方法。该方法要求模型结构完全基于tf.keras构建,且仅保存权重文件(.h5)。通过定义模型结构并加载权重,在TF 1.x环境中冻结计算图,生成可直接用于推理或进一步转换的.pb文件。
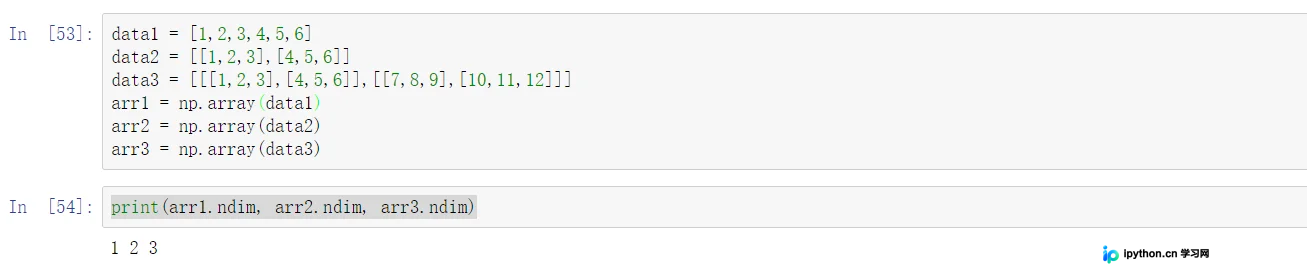
本文深入解析Numpy数组的四个核心属性与方法:ndim用于获取数组维度数,shape返回各维度大小的元组,dtype标识数据类型(如int32、float64),astype实现类型转换。内容涵盖一维至多维数组的shape理解,以及整型、浮点型、字符串间的类型转换规则与截断机制,帮助开发者准确掌握Numpy基础操作。
本文介绍如何在Python中使用NumPy计算数组按列非零元素的平均值,通过判断非零元素并求和除以数量实现。同时补充了利用Pandas DataFrame统计行列零值个数的方法,包括按行返回Series及按列返回Series的操作示例,为数据处理提供实用参考。
本文深入解析Python中循环加载模块的底层机制,解释为何直接导入可能成功而间接调用却报错。通过具体代码案例演示AttributeError的产生过程,并提供修改导入时机等解决方案,帮助开发者理解模块初始化顺序并避免常见陷阱。
本文详细介绍如何在Python中集成并使用内置的SQLite3模块。内容涵盖从建立数据库连接、创建游标对象,到执行SQL语句(包括插入、更新、删除及带参数的查询)的完整流程。重点解析Connection和Cursor对象的生命周期管理,强调使用try...except...finally结构确保资源正确释放,避免内存泄露,并提供实际代码示例辅助理解。