Python数据可视化实战:pyecharts与pandas结合使用详解
本文详细介绍如何使用pyecharts库在Python中进行数据可视化,涵盖柱状图、饼图、折线图及地图绘制。结合pandas处理JSON数据,通过获取国内疫情数据并转换为Excel,展示从数据抓取、清洗到可视化输出的完整流程。
2026-10-15
11

本文详细介绍如何使用pyecharts库在Python中进行数据可视化,涵盖柱状图、饼图、折线图及地图绘制。结合pandas处理JSON数据,通过获取国内疫情数据并转换为Excel,展示从数据抓取、清洗到可视化输出的完整流程。
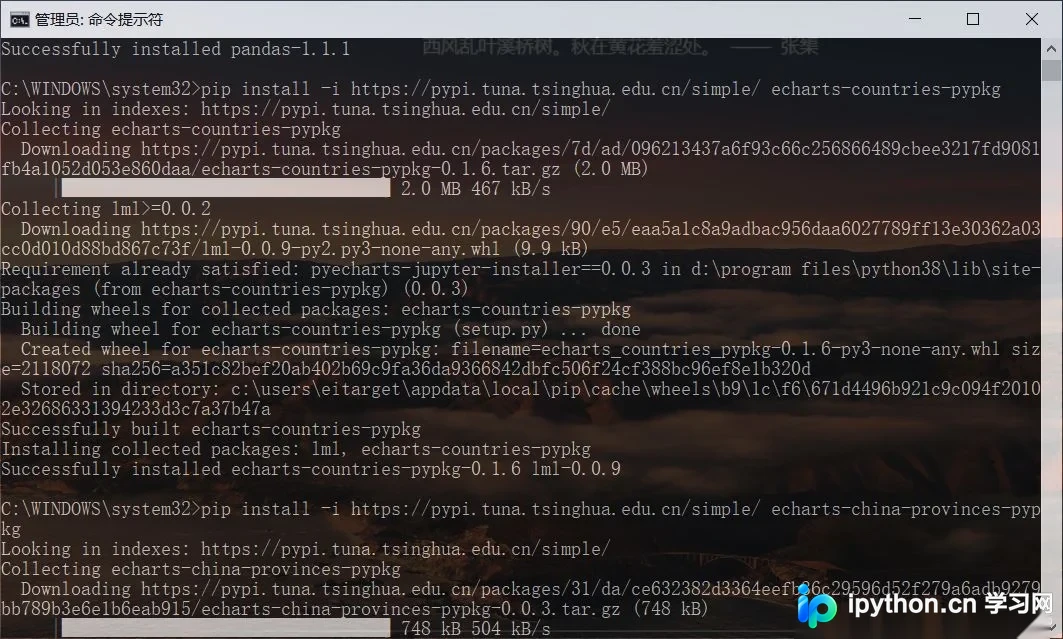
本文详细解决Python运行时报错no module named sklearn的问题。介绍通过pip install命令直接安装,以及在Anaconda/Spyder环境中使用conda activate激活环境后安装sklearn的方法。同时提供解决pip安装超时Read timed out错误的技巧,确保scikit-learn及相关依赖顺利部署。
本文详细介绍Python中WebSocket长连接与短连接的使用方法。重点解析WebSocketApp类的关键参数,如url、header及各类回调函数。通过示例演示如何配置ping_interval和ping_timeout实现心跳保活,确保连接稳定,并提供短连接的简单创建与关闭代码。
本文详细汇总了Jupyter Notebook中命令模式与编辑模式下的所有常用快捷键。涵盖单元管理、代码执行、文件保存及光标操作等核心功能,帮助开发者提升编码效率,快速掌握Notebook的高级操作技巧。
本文深入解析Python中的高阶函数与装饰器机制。详细阐述map与reduce函数的参数及返回值特性,并讲解如何在不修改原代码的前提下,利用嵌套函数和高阶函数特性实现装饰器。内容涵盖无参及有参装饰器的实现逻辑,包括使用*args和**kwargs传递参数及@语法糖的应用,帮助开发者掌握Python函数式编程核心概念。
本文通过Python Pygame库的实例演示,详细讲解如何在程序界面中正确显示中文字符。针对默认字体导致中文乱码的问题,提供了具体的代码修改方案,重点介绍如何加载本地中文字体文件(如simsun.ttf)并指定路径,从而实现中文内容的正常渲染。
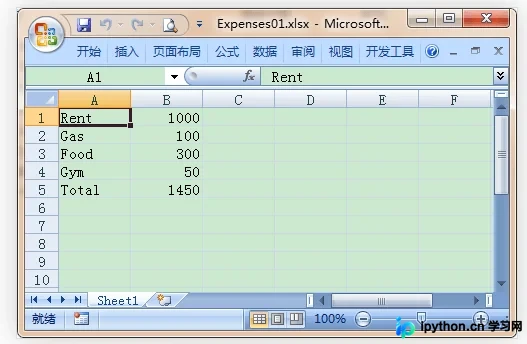
本文介绍 Python 中 xlsxwriter 模块的核心功能,该库专为高效写入 Excel 2007+ XLSX 格式设计。内容涵盖创建工作簿、添加工作表、写入文本数字及公式、应用格式设置、插入图像图表等特性。通过具体代码示例演示如何遍历数据并计算总和,同时指出其仅支持写入不支持读取修改的局限性,并对比 PhpSpreadsheet 库提供相关文档链接。
本文深入解析Django ORM中常见的N+1查询性能瓶颈,通过具体代码示例展示问题成因。重点讲解如何利用select_related和prefetch_related方法优化数据库查询,结合Prefetch对象处理复杂关联,并提供SQL日志记录方案,帮助开发者提升Django应用性能。
本文深入解析Python中的鸭子类型概念,对比其与Java静态多态的本质区别。通过代码案例说明Python如何通过方法而非类型定义对象行为,并探讨从Java转向Python时需克服的思维定势,帮助开发者正确理解Python的动态特性与内存模型。
本文介绍如何利用Python的python-docx库自动化处理杂乱的Word题库文档。通过遍历段落、识别特定字符(如序号后的点号、选项符号)及过滤无效行,实现自动删除多余空白、修正错误题号、合并选项行及移除“窗体顶端/底端”等冗余内容,最终生成格式规范的标准化文档。
本文深入解析 Python 两大主流测试框架 unittest 与 pytest 的核心差异。unittest 作为标准库,结构严谨但语法繁琐;pytest 凭借简洁的 assert 语句、强大的 Fixture 机制及丰富的插件生态,显著提升了测试编写效率。文章通过代码示例与特性对比,帮助开发者根据项目需求选择最合适的测试工具。
本文介绍Python中处理文件编码与类型识别的两个核心模块。针对ConfigParser读取非UTF-8配置文件时的UnicodeDecodeError,演示如何使用chardet模块自动检测文件编码并正确读取。同时讲解mimetypes模块通过文件名或URL获取MIME类型及对应文件扩展名的方法,涵盖guess_type与guess_all_extensions函数的具体用法与参数说明。