

Python实现简易Web爬虫详解
本文详解使用Python标准库urllib和第三方库BeautifulSoup4构建简易Web爬虫的方法。文章涵盖爬虫核心流程、URL管理器、HTML下载器与解析器、索引构建及主程序逻辑,通过具体代码示例展示如何抓取网页标题并建立关键词索引,适合Python初学者理解爬虫原理。
2026-10-13
24

本文详解使用Python标准库urllib和第三方库BeautifulSoup4构建简易Web爬虫的方法。文章涵盖爬虫核心流程、URL管理器、HTML下载器与解析器、索引构建及主程序逻辑,通过具体代码示例展示如何抓取网页标题并建立关键词索引,适合Python初学者理解爬虫原理。
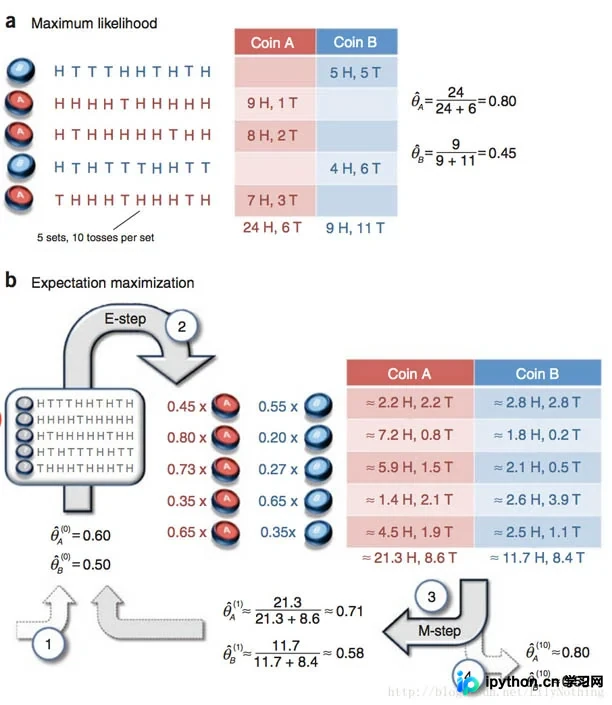
本文通过双硬币抛掷实验,详细讲解EM算法在Python中的具体实现步骤。涵盖从数据构建、参数初始化、E步概率计算到M步参数更新的完整流程,并分析不同初始值对算法收敛性及结果的影响,帮助读者深入理解期望最大化算法的核心逻辑。
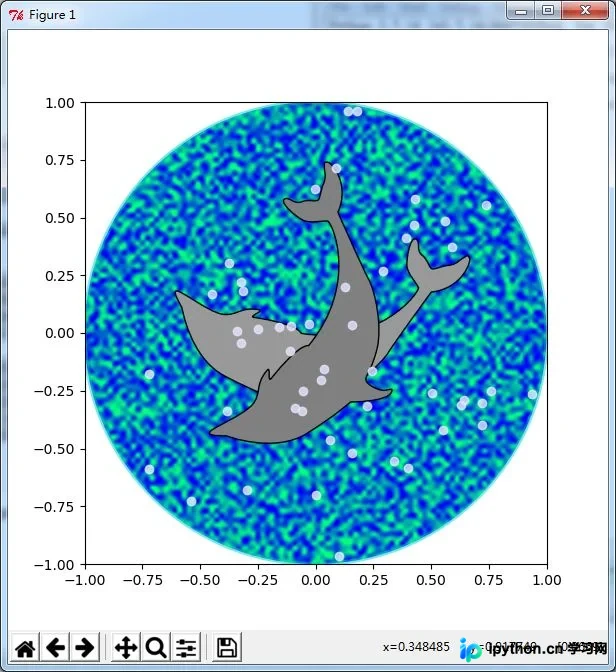
本文通过Python Matplotlib库演示如何结合Patch、Path和Affine2D变换类绘制海豚图形。详细解析了顶点数据的生成、路径代码的定义以及旋转等几何变换操作,展示了从基础形状到复杂矢量图形绘制的完整流程,为掌握Matplotlib高级绘图功能提供实用参考。
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
本文介绍如何利用Python轻量级Bottle框架快速构建Web服务,适用于RESTful API性能测试场景。内容涵盖框架安装、服务启动配置、动态路由实现及客户端调用示例,帮助开发者快速掌握使用Bottle提供简单Web接口的核心步骤。
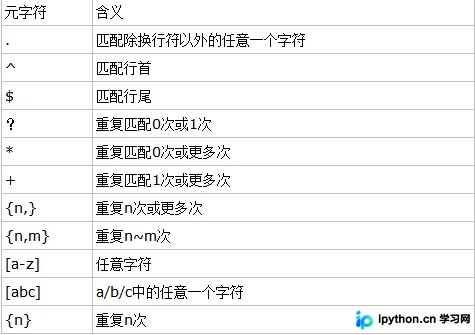
本文详细解析Java与Python中正则表达式的核心语法,涵盖元字符、转义处理及常用匹配模式(如邮箱、身份证、强密码验证)。重点介绍Python re模块的compile、search、match、findall等方法,深入讲解match对象的使用及子模式扩展语法,通过代码示例展示高级匹配技巧,帮助开发者高效处理复杂字符串任务。
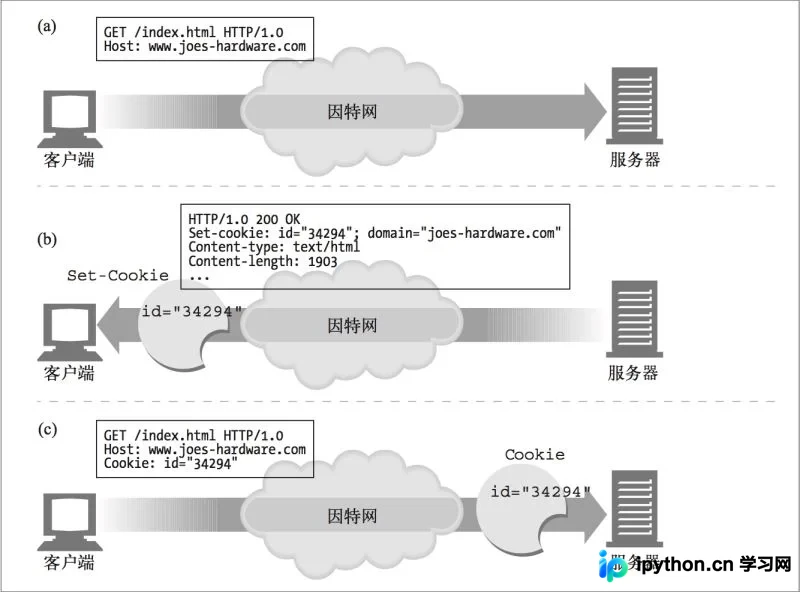
本文深入解析Python爬虫中Cookie与Session的核心机制。详细阐述Cookie作为客户端存储的身份标识,涵盖Version0与Version1的属性差异及过期策略;解析Session如何通过唯一ID减少数据传输并保障服务器性能。对比两者在安全性、存储位置及适用场景上的区别,帮助开发者优化爬虫策略与Web交互逻辑。
本文介绍使用Python计算数组元素平均值的方法。通过定义列表、获取长度并遍历求和,最后除以长度得到均值。附带相关在线计算工具链接,适合Python初学者参考学习。
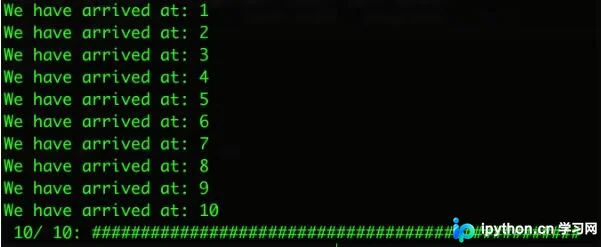
本文详解如何在Python控制台实现动态进度条。核心在于利用sys.stdout.write替代print,配合\r转义符将光标移至行首,并通过sys.stdout.flush()强制刷新缓冲区。文章涵盖解决旧字符残留、固定底部输出及封装类实现等常见问题,适用于爬虫、机器学习等耗时任务的可视化监控。
本文介绍如何利用Python的函数式编程特性处理Splunk导出的CSV日志数据。通过封装DictReader、应用生成器过滤与投影、使用SimpleNamespace简化属性访问,以及构建Map-Reduce管道,实现灵活的数据探索。文章详细讲解了如何动态调整转换逻辑以分析RESTful API性能,并展示了如何结合Counter和statistics模块进行统计聚合。
本文介绍利用Python和ADB工具,在安卓手机上实现《王者荣耀》冒险模式“陨落的废都-魔女回忆”关卡的自动刷金币脚本。通过模拟屏幕点击和自动战斗功能,玩家可高效获取游戏内金币。教程涵盖环境配置、代码实现及注意事项,旨在发挥程序员优势,提供便捷的游戏辅助方案。
本文深入解析Python处理中文乱码的核心原理,重点区分“字符”与“字节”的概念。通过对比Python、Perl及Ruby在编码处理上的差异,解释str与unicode的区别,以及encode和decode的实际作用,帮助开发者从根本上理解并解决编码问题。