

Python实现EM算法:双硬币模型实例解析

本文通过双硬币抛掷实验,详细讲解EM算法在Python中的具体实现步骤。涵盖从数据构建、参数初始化、E步概率计算到M步参数更新的完整流程,并分析不同初始值对算法收敛性及结果的影响,帮助读者深入理解期望最大化算法的核心逻辑。
前言部分回顾了EM算法的基本概念及相关公式,为避免数学推导带来的记忆负担,本文转向通过代码实践来巩固理解。接下来将深入分析EM算法在Python环境下的具体实现过程。
EM算法的Python实现与详细解析
引入经典的双硬币问题场景。
假设存在两枚硬币A和B,每次实验以相同概率随机选取其中一枚进行抛掷。实验共进行5轮,每轮独立抛掷10次,结果记录如图a所示。例如,某次实验结果序列为H、T、T、T、H、H、T、H、T、H,其中H代表正面朝上。
假设记录实验数据的实习生因业务熟练度不同,导致数据记录出现a和b两种情况。
情况a中,实习生详细记录了每次实验所选用的硬币是A还是B,因此我们可以直接观测到每次抛掷对应的硬币类型。
情况b中,实习生遗漏了每次实验所选硬币的记录,导致我们无法从观测数据中得知具体使用的是硬币A还是B。
问题在于,在这两种不同观测条件下,应如何分别估计两枚硬币正面朝上的概率?
针对情况b的问题,其逻辑与三硬币问题类似,区别仅在于三硬币问题中的首个抛掷选择被替换为实习员的随机选择行为。
当明确知道每次抛掷使用的是硬币A还是B时,可直接通过概率公式求解。然而,当存在隐变量(即未知具体使用哪枚硬币)时,必须采用EM算法进行求解,具体流程如图所示。
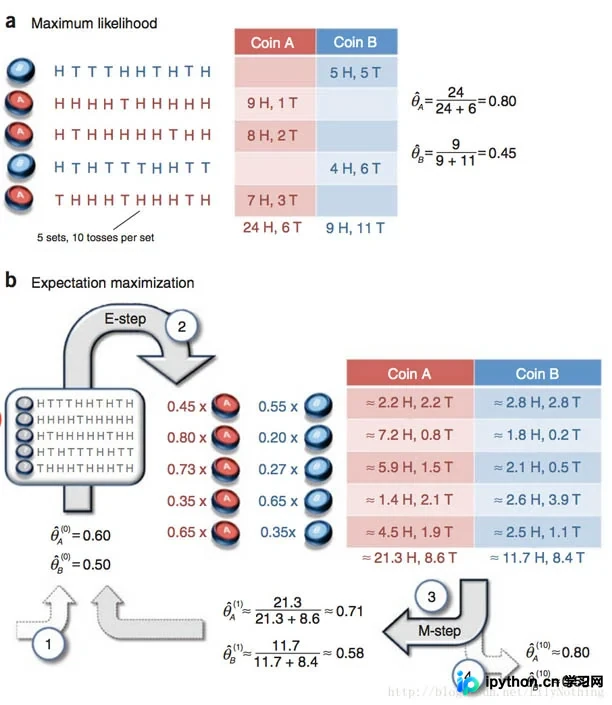
EM算法的第一步为参数初始化,随后基于当前参数推导可能的观测结果。
构建观测数据集。
针对该问题,首先采集数据,用1表示正面(H),0表示反面(T):
#硬币投掷结果
observations = numpy.array([[1,0,0,0,1,1,0,1,0,1],
            [1,1,1,1,0,1,1,1,0,1],
            [1,0,1,1,1,1,1,0,1,1],
            [1,0,1,0,0,0,1,1,0,0],
            [0,1,1,1,0,1,1,1,0,1]])
第一步:参数初始化。
为模型参数赋予初始值。
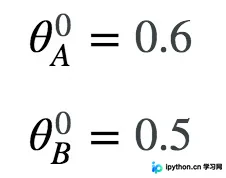
执行第一个迭代的E步(期望步)。
抛硬币过程符合二项分布,可利用scipy库中的binom函数进行计算。以第一行数据为例,正反面各出现5次,计算如下:
#二项分布求解公式
contribution_A = scipy.stats.binom.pmf(num_heads,len_observation,theta_A)
contribution_B = scipy.stats.binom.pmf(num_heads,len_observation,theta_B)
将计算得到的两个概率值进行归一化处理,从而得出数据来源于硬币A或B的概率:
weight_A = contribution_A / (contribution_A + contribution_B)
weight_B = contribution_B / (contribution_A + contribution_B)
该值类似于三硬币模型中的μ,但增加了下标以标识数据所在行(本数据集共5行)。同理,可计算出剩余4行数据的μ值。
获得μ后,即可估计数据中由A和B分别产生的正反面次数。μ代表数据来自硬币A的概率估计值,将其乘以正面总数,即可得到正面来自硬币A的估计次数;反面同理。对硬币B亦进行相同操作。
 #更新在当前参数下A,B硬币产生的正反面次数
 counts['A']['H'] += weight_A * num_heads
 counts['A']['T'] += weight_A * num_tails
 counts['B']['H'] += weight_B * num_heads
 counts['B']['T'] += weight_B * num_tails
执行第一个迭代的M步(最大化步)。
在当前模型参数下,已估计出A和B分别产生的正反面次数,据此可计算新的模型参数:
new_theta_A = counts['A']['H']/(counts['A']['H'] + counts['A']['T'])
new_theta_B = counts['B']['H']/(counts['B']['H'] + counts['B']['T'])
整理上述步骤,给出EM算法单次迭代的代码实现:
def em_single(priors,observations):

  """
  EM算法的单次迭代
  Arguments
  ------------
  priors:[theta_A,theta_B]
  observation:[m X n matrix]

  Returns
  ---------------
  new_priors:[new_theta_A,new_theta_B]
  :param priors:
  :param observations:
  :return:
  """
  counts = {'A': {'H': 0, 'T': 0}, 'B': {'H': 0, 'T': 0}}
  theta_A = priors[0]
  theta_B = priors[1]
  #E step
  for observation in observations:
    len_observation = len(observation)
    num_heads = observation.sum()
    num_tails = len_observation-num_heads
    #二项分布求解公式
    contribution_A = scipy.stats.binom.pmf(num_heads,len_observation,theta_A)
    contribution_B = scipy.stats.binom.pmf(num_heads,len_observation,theta_B)

    weight_A = contribution_A / (contribution_A + contribution_B)
    weight_B = contribution_B / (contribution_A + contribution_B)
    #更新在当前参数下A,B硬币产生的正反面次数
    counts['A']['H'] += weight_A * num_heads
    counts['A']['T'] += weight_A * num_tails
    counts['B']['H'] += weight_B * num_heads
    counts['B']['T'] += weight_B * num_tails

  # M step
  new_theta_A = counts['A']['H'] / (counts['A']['H'] + counts['A']['T'])
  new_theta_B = counts['B']['H'] / (counts['B']['H'] + counts['B']['T'])
  return [new_theta_A,new_theta_B]
EM算法主循环逻辑。
设定两个终止条件:模型参数变化小于指定阈值,或循环达到最大迭代次数。基于此可编写EM算法的主循环代码。
def em(observations,prior,tol = 1e-6,iterations=10000):
  """
  EM算法
  :param observations :观测数据
  :param prior:模型初值
  :param tol:迭代结束阈值
  :param iterations:最大迭代次数
  :return:局部最优的模型参数
  """
  iteration = 0;
  while iteration < iterations:
    new_prior = em_single(prior,observations)
    delta_change = numpy.abs(prior[0]-new_prior[0])
    if delta_change < tol:
      break
    else:
      prior = new_prior
      iteration +=1
  return [new_prior,iteration]
调用EM算法函数。
给定数据集和初始参数,即可调用EM算法进行计算:
print em(observations,[0.6,0.5])
得到计算结果。
[[0.72225028549925996, 0.55543808993848298], 36]
我们可以尝试改变初始值,以观察初始值对EM算法收敛结果的影响。
print em(observations,[0.5,0.6])
实验结果:
[[0.55543727869042425, 0.72225099139214621], 37]
结果表明EM算法具有一定的健壮性。若将初始值设为相等,结果会如何?
print em(observations,[0.3,0.3])
输出结果为:[[0.64000000000000001, 0.64000000000000001], 1]
显然,当两个初始值之和不为1时,会破坏该EM函数的正常收敛逻辑。
调整初始值后:
print em(observations,[0.99999,0.00001])
输出结果为:[[0.72225606292866507, 0.55543145006184214], 33]
可见,EM算法对参数初始值的改变仍保持一定的健壮性。
以上内容基于前人博客的学习总结,建议读者动手实现以加强Python编程练习。希望对大家的学习有所帮助,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









