

Python logging模块使用详解:从基础配置到高级应用
本文深入解析Python标准库logging模块的核心用法。涵盖DEBUG至CRITICAL五级日志定义,演示控制台与文件输出的配置方法,讲解命令行参数动态调整日志级别、变量格式化及自定义输出模板。进一步介绍Logger、Handler、Filter和Formatter组件协作机制,并提供支持滚动保存近15天日志的自定义处理类实现案例,帮助开发者构建完善的日志监控体系。
2026-10-13
23

本文深入解析Python标准库logging模块的核心用法。涵盖DEBUG至CRITICAL五级日志定义,演示控制台与文件输出的配置方法,讲解命令行参数动态调整日志级别、变量格式化及自定义输出模板。进一步介绍Logger、Handler、Filter和Formatter组件协作机制,并提供支持滚动保存近15天日志的自定义处理类实现案例,帮助开发者构建完善的日志监控体系。
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
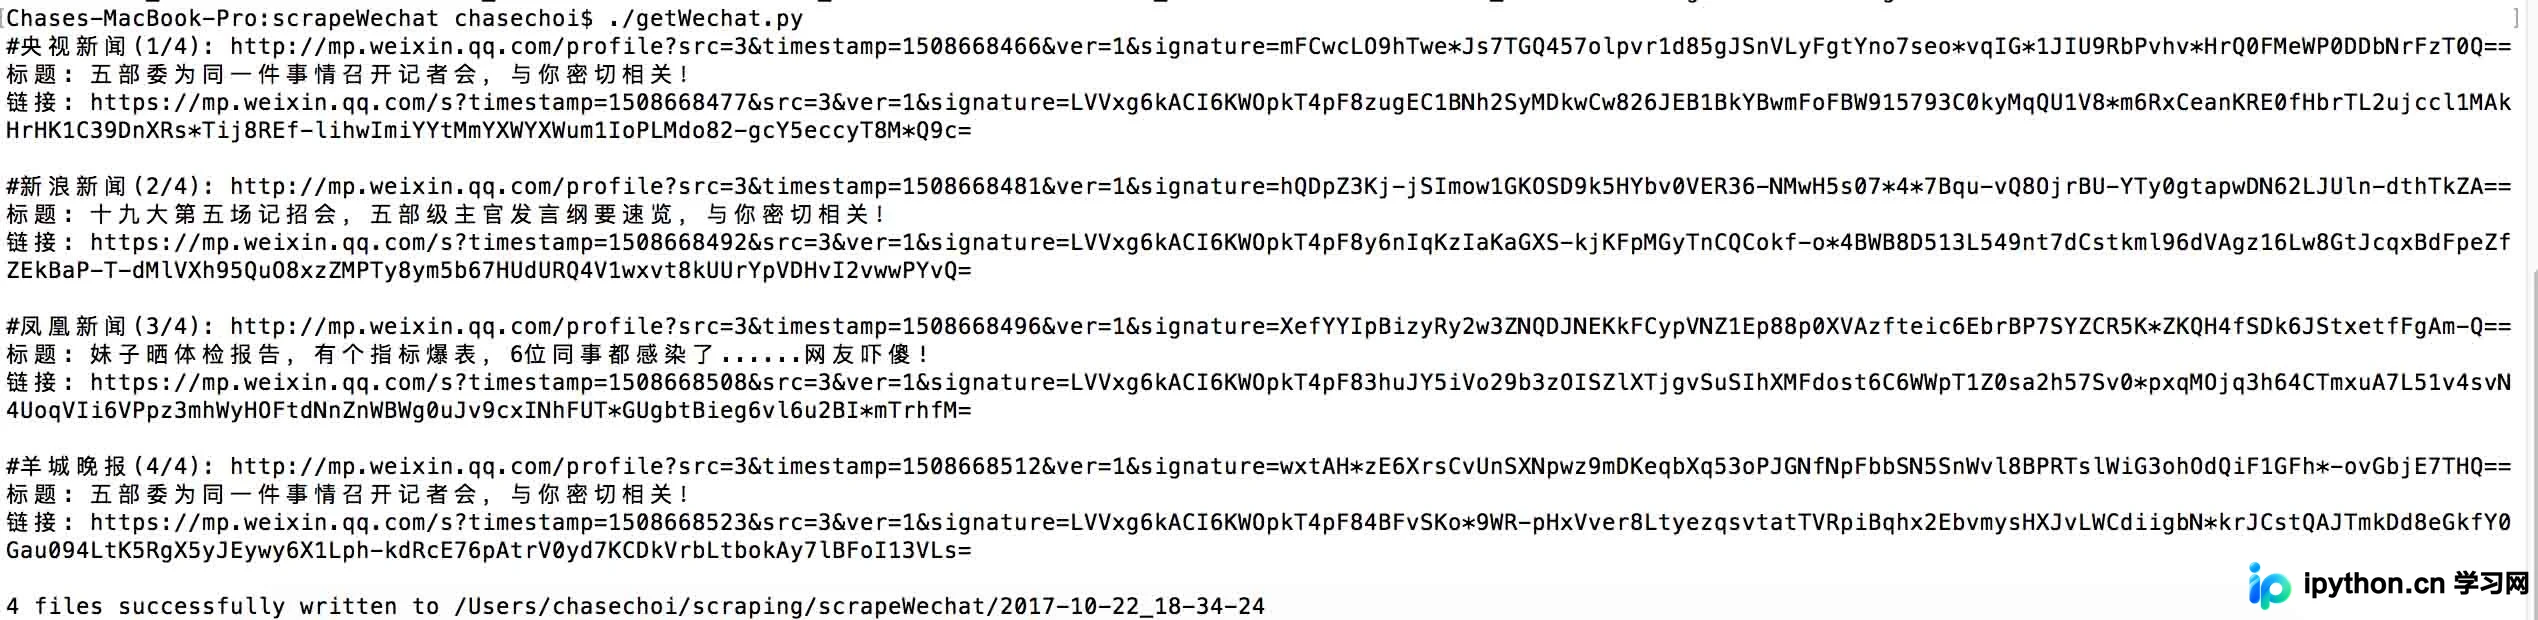
本文介绍在Python中如何获取13位Unix时间戳。默认time.time()返回10位秒级浮点数,通过乘以1000并四舍五入取整,可转换为毫秒级13位时间戳。提供两种实现方式:直接运算与Lambda函数封装,适用于Web接口签名等场景。
本文详细介绍在Ubuntu Docker环境中安装和配置Jupyter Notebook的完整步骤。内容涵盖从更新软件源、安装pip及依赖库,到生成安全密钥、修改配置文件及启动服务的详细命令。同时提供了解决locale错误、地址绑定失败及模块缺失等常见异常的实用解决方案,帮助开发者快速搭建交互式编程环境。
本文详解Python中urlparse模块的常用方法。介绍urlparse、urlsplit如何解析URL为协议、域名、路径等组件,以及urlunparse和urlunsplit的重组用法。同时说明urljoin处理相对地址的技巧,并展示如何提取hostname、port等附加属性,助力开发者高效处理网络链接。
Python标准库处理时间复杂且模块分散,arrow库提供了更优雅的智能方式。本文介绍arrow的安装方法及核心功能,包括获取当前时间、调整与修改时间、时区转换、文本解析为时间对象、获取时间戳及格式化输出,并展示如何转换为标准库对象,帮助开发者高效处理时间数据。
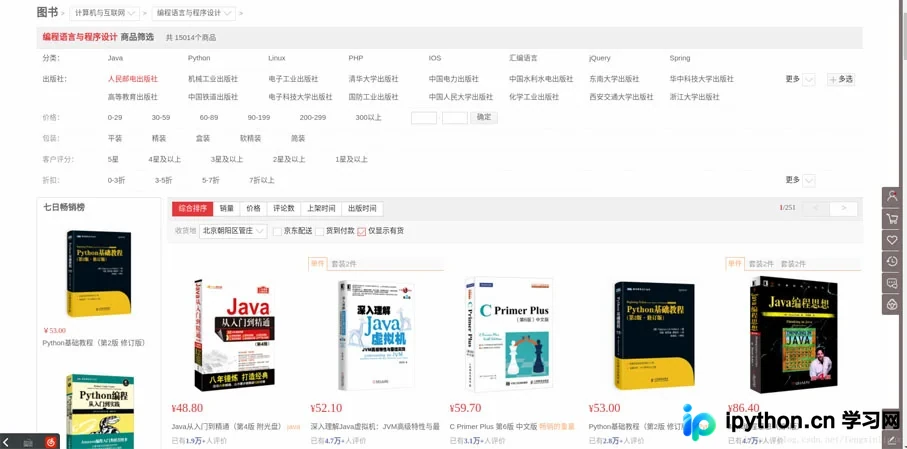
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
本文深入解析 Python 闭包机制,阐述函数作为对象的作用域规则及环境变量绑定原理。通过代码示例展示 __closure__ 属性的内部结构,并探讨闭包在减少参数传递、提升代码复用性及支持并行流水线运算中的核心价值。
本文介绍利用Python3.4从HTTP代理网站批量抓取代理IP并进行有效性筛选的方法。通过多线程并发测试目标网站连接速度与响应内容,快速剔除无效代理,提取可用IP列表,解决爬虫IP被封问题。
本文介绍使用Python脚本破解QQ群猜数游戏的算法。游戏设定在1至10000范围内,通过二分查找法快速定位目标数字。脚本支持自定义范围输入,自动计算中间值并模拟交互过程,展示如何利用编程优化猜测策略,提高猜中效率。
本文介绍Python中针对含中文字符串的截取方法,重点解决多字节字符截断导致的乱码问题。通过分别实现UTF-8和GB18030编码下的截取逻辑,利用字节长度判断确保不分割多字节字符,提供两种具体的代码实现方案供开发者参考。
本文系统讲解Python文件操作的核心流程,涵盖打开、读写及关闭步骤。详细解析'r'、'w'、'a'、'r+'等常见打开模式及其区别,重点说明Windows下UTF-8与GBK编码的兼容处理。通过对比Py2与Py3中rb模式及seek行为,阐述二进制读写差异,并演示利用with语句实现安全的文件上下文管理,避免资源泄露。